○
Neo4j 的开发者布道师 Jeremy Adams 把一台旧树莓派 4B 做成挂在脖子上的个人 agent:选了只有十几个源文件、把 agent 关在 Docker 容器里的 NanoClaw,用 WhatsApp 对话,推理全在云端的 Claude,理由是「看得懂比功能全重要」。
Neo4j 的开发者布道师 Jeremy Adams 把一台旧树莓派 4B 做成挂在脖子上的个人 agent:选了只有十几个源文件、把 agent 关在 Docker 容器里的 NanoClaw,用 WhatsApp 对话,推理全在云端的 Claude,理由是「看得懂比功能全重要」。
Traversal 的产品经理 Eric Schwartz(厂商视角)的判断是:编码 agent 把「开发」压短之后,省下的时间没有流向设计,而是被排障吃掉——代码更多、人对它的理解更少;他的幻灯片引的数字是 Global 2000 企业每年因宕机损失 4000 亿美元、每位工程师每周 7 小时耗在排障上。
提速的工具就是致病的工具:Sourcegraph 的 CEO Dan Adler 认为,coding agent 写代码越多越快,支撑世界运转的几十年老代码库就腐坏得越快——标准漂移、重复代码扩散、跨服务依赖变脆、新漏洞不断冒出来,病根是代码的量。
Sarah 的核心论点:dashboard 和各家查询语言从来只是夹在你和数据之间的「翻译装置」,你要的一直是答案;她自己每天用 Datadog 用了半年、却连它的仪表盘都没打开过,就是「仪表盘已死」的现场证据。
AssemblyAI 每天约 1,000 个 API 注册,负责带客户上手的工程师却长期只有 Matt 一个;买来的现成客服机器人只端到端解决约 10% 的对话,而且 system prompt、工具、检索管道一样都改不了,于是他的 FDE 团队自己造了一个所有对话都必须先过他的 agent,起名 Joey。
VS Code 团队靠 agent 把坚持了十年的月更改成周更:agent 写的代码存活率一年从 55% 涨到 86%,可成功马上制造了下一个问题——issue 和 PR 积压暴涨——所以他的结论不是让大家多用 AI,而是把发布软件的整套体系重建一遍。
管着 ChatGPT 的 Tibo 认为「调 loops、搭 graphs」这类人工精调的 agent 编排只是过渡阶段:他自己的 agent 团队每逢模型突破就缩编一次,长期要的是一个理解你目标、从反馈里学习的常驻 agent(他们叫 Dots),而不是一套更精巧的循环。
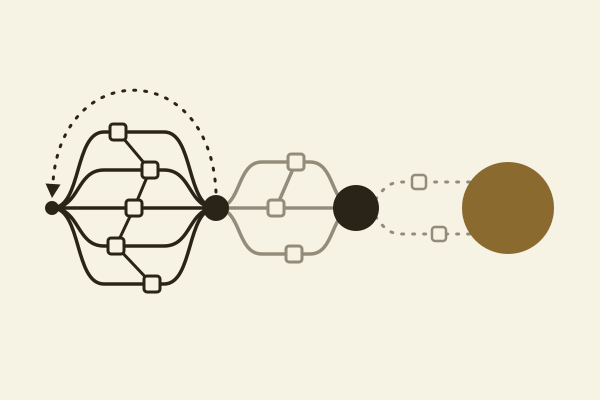
Vas 的总论点是别「应用」AI:AI 不是刷一层漆,真正的活儿是流程再造。进场先用访谈、挖记录系统、翻现有文档三个来源,把一件事实际怎么跑测绘出来(他举的上市软件公司报价流程,文档上 7 步,日志里是 20 步、7 个回路),再把每一步按「删掉 → 纯代码 → agent → 人做决策」的顺序归进四个桶——幻灯片上那 20 步里被删掉的有 8 步,比交给 agent 的 5 步还多。
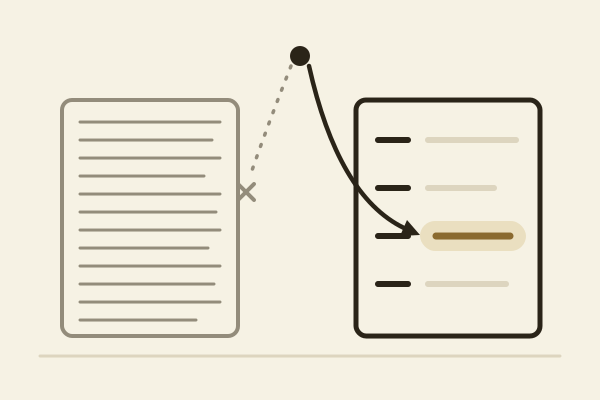
购物正在从「搜索时代」(人敲关键词、自己翻目录)走向「意图时代」(人用大白话描述需求,AI 把商品送到面前),下一站是「委托时代」(agent 直接替人下单);而商家手里的商品目录,是照着 Google Shopping 这类广告 feed 和人的关键词搜索建的,agent 读不好。
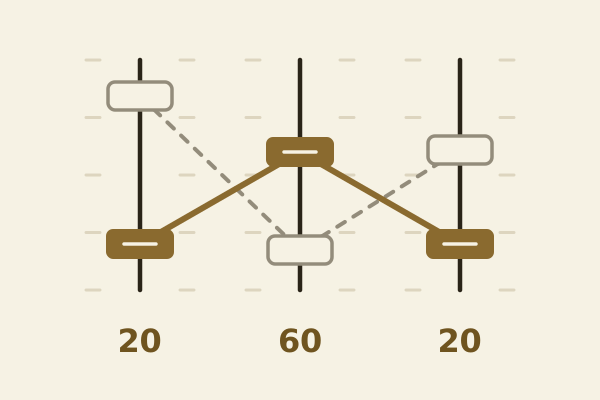
首席 AI 官是个还没定型的岗位:她引的 IBM 调研数字从 2024 年约 11% 涨到现在 76%,可同一个头衔在不同公司干的活天差地别。Rania 把它拆成三根滑块——科学家(探索实验)、架构师(定战略、改产品)、教练(布道教育),每根落在哪,看公司卖不卖软件、员工技术底子如何、AI 走到了哪一步。
Milly Tamati 在苏格兰一座只有 191 个人的偏远小岛上做 Generalist World(一份 newsletter + 会员社群 + 招聘板 + 暑期学校,服务「没法被塞进某个格子」的通才),自述每个月赚 3 万美元、4 年累计收入将近 60 万美元;而她给这门生意定的头号 KPI 是「平静」,因为她要它几十年后还在。
几乎什么都能造出来之后,PM 的价值不再是「把事情推到做完」,而是判断——Google Search 产品副总裁 Robby Stein 说,PM 的手艺不是样样都会一点,而是一件事:做决策,并且要认清很多决策会是错的。
AI builder 这个岗位是真的,但在一万多人的公司里,角色不是合并成一个,而是各自在扩张:PM 的职责(找到 PMF、做出人们喜爱的产品、让人肯付钱)没变,变的是做法;至于「怎么跟上所有工具」,Atlassian 首席产品官 Tamar Yehoshua 的回答是「跟不上」,该盯的是什么对你的客户真正管用。
产出不是产品。工具一直在变强,但「做出更好的东西」并没有因此自动发生;你可以建软件工厂,但别让组织自己变成一座只盯产出效率、把活儿和思考都外包出去的工厂——客户买的不是代码行数。
PM 没有消失,反而更吃重:Mike 转做 IC 后以为项目「有 Claude 顶着」,PM 一加入才看见大客户、客户成功团队、Safeguards 这一串事眼看要掉地上;Claude 已经能提醒你组织里别处在发生什么,但还当不了把人和 agent 聚到一起把活干成的「召集人」。
前 Microsoft、Supercell 工程师 Erina Karati 用一个游戏里的 AI 村庄说明:会记忆、有情绪的 agent 在短场景里很顺,时间一拉长就出现三种失真——丢了来源、传言被说成事实、做计划时想不起已知的事实,所以长周期 agent 得按「一整次运行」来评估和改进,而不是盯着某一次回答。
agent 已经够强,卡住产出的是人:每个 agent 都要人去掌舵、指挥、评审,规模一上来就把人累垮——AgentCraft 与 MCP-UI 的作者 Ido Salomon 的判断是「我们就是瓶颈」,而驾驭一大群单位的本事,其实早在打《魔兽争霸》这类游戏时就练过了。
前美团龙珠管理合伙人于红带团队 all in AI 时,反而确认了教育才是自己的人生使命,于是在 AI 最热时离开 VC、做儿童社会情感学习产品兔咚咚 SEL;她做取舍靠「以终为始」加上不断「给自己打叉叉」——当年离开 GGV,手上 4 个待上市项目的 Carry「肯定有上千万」,她连算都没算就走了。
Grok Bot 的核心设计是把 agent 做成常驻、有名字、有自己身份、记忆和工具的「同事」,而不是用完即弃的聊天:可复用的能力和记忆抽象成角色(bot),有截止日期的项目另开会话;同一个 bot 在私聊和群聊里是同一个实体,bot 之间能互相请教、拉群辩论、直接交接上下文。
Warp 创始人兼 CEO Zach Lloyd(前 Google Docs 工程负责人,六个月没写一行代码仍在频繁发版)的论点是「软件工程会变成工厂工程」:开发正从聊天补全、交互式 agent 走向自动化,每个有规模的项目都会有一条「想法 → 分诊 → spec → 实现 → 评审 → 验证 → 发布 → 监控」的大循环,人只在审 spec、审代码、审产品三处出场,工程师的活变成搭建和管理这座工厂。
W&B 工程师 Zubin Aysola 拆解自家刚正式发布的 ARIA agent 怎么评测、怎么自我改进(利益相关:ARIA、Weave 都是 W&B 的产品);他每晚睡前琢磨的难题是「benchmark、eval、agent 和它的配置全都一起变」,对策是让生产版和研究版 agent 逐字节一致,生产和离线的 trace 都用 Weave 按同一种格式记录,这样线上的任何一次运行都能原样搬回离线环境里做爬山优化。
Warp 的 harness 开发负责人 Suraj Gupta 认为,软件工程师正从「造产品」转向「建工厂、维护工厂」,而很少有人讲的是工厂本身怎么随时间变好;他把答案拆成三种回去就能落地的机制:skill、持久记忆、模型路由。
Reddit 的 Android 工程师 Andrew Orobator 认为模型从来不是瓶颈,围绕模型的判断力才是:换一个更聪明的模型,答案只好一点点;拿掉测试、闸门和评审,整个系统就垮。人是耳濡目染、隐式吸收判断力的,agent 每次都从零记忆启动、要求判断力是显式的——所以工程师的活已经变成「harness 工程」,要规模化的是判断力,而不是模型。
这篇论文把 agent 记忆里那些高频、答案只是「一个标签 / 概率 / 分数」的决定——给记忆打类型、判关系、路由查询、给候选打分、决定何时停——统统交给 TypeSafe AI 的类型化决策模型 Jev(不生成文字、直接返回概率,就是 ep229 讲的那个模型)当「系统一」,大模型(系统二,实验里是 gpt-4o-mini)只在最后综合作答时出场;论文强调真正的新意是这种「轻量控制 / 深思推理」的架构分离,Jev 只是它的一种实现。
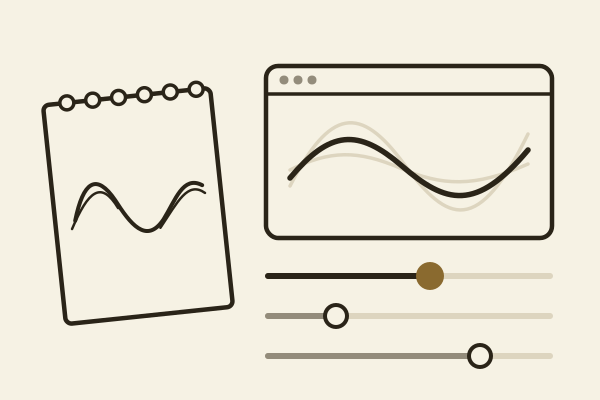
在 GitHub Next 设计工程师 Maggie Appleton 看来,设计和工程是同一种解决问题的技能、只是材料不同;如今实现已被 agent 做到「足够好」,她几乎不看代码,把功夫全花在「想清楚做什么」上——先在纸上画、Figma 只做到中保真,再写扎实的 spec 和「agent 怎么自证完工」的验证清单交出去,并让 agent 给原型挂上滑块和取色器做成 jig,在浏览器里实时调参,「按需给自己造一个 Figma」。
执行跑赢了发现:Claire 手握 40 个 Grok Bot、PR 涨了 3 倍、能把 ChatPRD 重构 70 次,却坦白「好点子用完了」——她几乎一次成型、功能对标竞品的「产品图谱」只有竞争力、没有差异化;瓶颈已经从「我能造什么」挪到了「我相信什么值得造」。
Meta 推荐研究负责人 Devansh Tandon 的第一个论点:推荐系统和 LLM 一样吃 scaling 律,而且还在曲线早段——证据是 Meta 的 HSTU 论文,以及 Meta 财报:简化排序、用更长的互动历史后 Reels 观看时长同比 +30%(2025 Q4),下一季又把训练用的互动序列加长一倍(2026 Q1);背后转着一个「token 进、互动出」的飞轮:训练 → 推理 → 用户互动 → 广告 / 订阅变现 → 替下一轮训练买单。
AI 让「造」变得极其容易,也在重演战后建造热潮:LLM(大语言模型)只给「最可能的答案」、界面几秒就显得「做完了」、做得太快就被当成一次性的,结果是满屏千篇一律、没人用心的「僵尸 UI」。
Marty Cagan 把整场演讲用来清算自己几十年的产品建议,挑出十个真心后悔的点:最难堪的是低估商业可行性(2008 年《Inspired》第一版只讲价值、可用性、技术可行性三种风险,十年后才补上),其次是让大家扎堆当「这是不是个问题」的守门人——而公司真正付钱请 PM 做的是方案探索。
Zapier CEO Wade Foster 的 AI 流利度评分表 V2 把 PM 分成四档——不合格(unacceptable,即不录用线)→ 胜任(capable)→ 适应型(adaptive)→ 变革型(transformative):2026 年用 AI 总结、写作、写基础 PRD 只是入场门槛,他希望大部分 PM 大部分时间落在适应型、手里拿得出一个变革型的例子;而变革型意味着「n of one」——你是第一个做这件新事的人,30 到 40 个 PM 半年大概才出一个,他给自己在大多数方面也只打适应型。
赢比赛靠的不是车手开得更快,而是清除驾驶之外的瓶颈;AI 不会消灭瓶颈、只会把它挪走——写代码变容易之后,瓶颈已经挪到了 PM 自己身上(定义、协调、测试、发布),所以产品领导者要少盯交付的产品,多盯那座造产品的「工厂」。
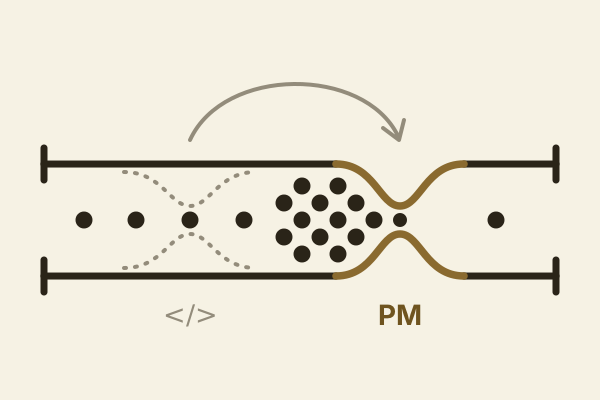
垂直 AI 公司赢前沿实验室,靠的不是比谁更聪明,而是做和它们「垂直」的东西:记录系统、MNPI 合规与可审计、数据室、让 agent 之间直接成交的渠道——Rogo 靠这些能做到 50 亿美元收入,而这对正冲向万亿营收的 Anthropic 只是「停在路边捡一分钱」。
Confido 给消费品牌(Mars、Unilever 的事业部,以及 Olipop、Dude Wipes 等)做「AI agent 劳动力」,从回款核销、会计到销售规划、供应计划都在一个系统里,刚拿下 Insight 领投的 5500 万美元 B 轮;而它的前身是差点没上 demo day 的健身点子 Outfit,熬过约一年转型地狱,才在 CEO Justin 自己的消费品履历里找到这个「一直摆在眼前」的问题。
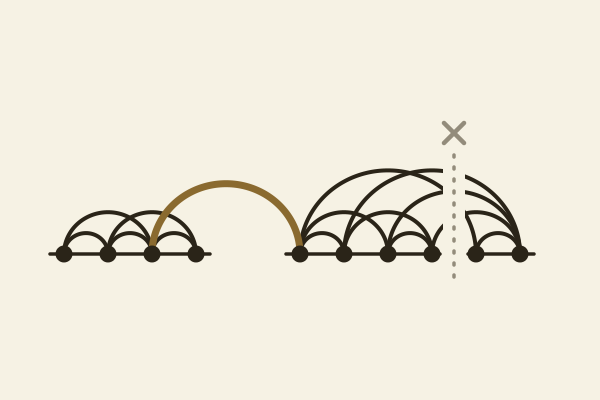
这篇南京大学团队的论文用图论回答「多智能体协作什么时候才值得」:把一次任务执行看成步骤之间的依赖图,删掉就会让图断开的「桥边」就是两个子任务之间唯一的交接线——事先知道整条轨迹、又沿桥边切对,拆给多个 agent 一定省上下文;可现实里依赖图要等任务做完才看得见,编排的本质是提前猜桥边,猜错会让 agent 互相干等(局部死锁)或推高通信开销,子任务越多错得越多、协调成本越高,所以多智能体只在「长程 + 稀疏依赖」的任务上系统性占优,在紧耦合的顺序流程里,Claude Code、Codex 这类单智能体 harness 依然更强。
Gurley 用 Surfside 公寓倒塌、波音 737 MAX、卡特里娜、福岛、挑战者号五场灾难立了一把尺子:它们大多是「技术性失败 + 制度性失败」交织,每场都有追查者(独立调查记者、两党委员会、科研机构出资的第三方调查、黑川清和费曼式的独立调查者)在查,常常还要顶着阻挠者(被聚光灯一照就抱团的当事机构、被俘获的监管方),最终都查清了根因——这正是 CAPA(纠正与预防措施)五步里不能跳过的一步,预防只能建在它上面。
前红杉掌门、前《时代》记者 Michael Moritz 借写父母家族史的书回看自己:逃离纳粹的难民家庭给了他「靠机灵活下去」的干劲与韧劲,也留下母亲那种「厄运就在拐角」的阴影——他至今说自己从没觉得擅长什么、很难为任何成就骄傲,「男人心里的那个小男孩永远拿不走」。
ChatGPT Finances 的产品负责人 Ethan Bloch(Digit 创始人,第二家公司 2026 年 4 月被 OpenAI 收购)用虚构人物 Jim 的合成数据演示了 6 个用例——扫 90 天流水找重复扣费和涨价订阅、省税、基金费率体检、信用卡回馈、停工创业的储蓄跑道、租还是买;起点都一样:经 Plaid 只读连上金融账户、再连上邮箱,让它有上下文(连账户目前只限美国用户)。
澳大利亚的 Tom 和兄弟做的 Avenue,是一个装在汽修厂、电工这类技工商家官网和 Google 商家主页上的预约小组件,专治「我有钱……凭什么非得给他们打电话」这个老问题;上线约一年,片中收入说法不一——Tom 自报每月 8.5 万澳元,Stripe 画面上的 MRR 是 A$63,108(他说去年 8 月才 597),TrustMRR 页 MRR $41,266。
Peter Yang 称 Meta 的 Muse 是他迄今用过最好的个人 agent:免费,一年替他在话费和有线电视费上省下 800 多美元。AT&T 那笔是它用存好的密码开浏览器代登录,查出只要把扣款从信用卡改成银行账户、4 条线每月就能省 40 美元,一年约 480 美元,前后只聊了 5 到 10 分钟——唯独填银行账号那一步,它坚持交还给他亲手做。
Jev(官网 typesafe.ai)是一个专做分类、决策的模型:你给它一个输入加一份输出 schema(一个问题 + 一组选项),它不生成任何文字,约 200 毫秒还你每个选项的概率,结果类型安全、拿来就能进代码;Ryan 用自己的 1,700 封邮件现场跑了类别、优先级、垃圾分、回复分四个字段,整批只花 18 美分。
团队要按「恐怖组织」来设计:一套人人当信仰的战略(再提炼成「香蕉摊里永远有钱」「长期贪婪」这类能反复念叨的短语)加一张「谁能被托付哪类决策」的清晰结构,就能省掉过度协作的协调成本——「你的速度只能和系统里最慢的那个节点一样」——让 PM 接住以前得由创始人拍板的决策;配套是容得下 Nikita Bier 这类尖刺型人才,并且把最强的人往死里用、而不是花时间去救一般的人。
靠几百上千个账号、几万到几十万个 SKU 铺货抢流量的「跨境大卖」老路已经失灵,卫哲说出海进入了「选择比努力重要」的阶段:做对地区、品类、渠道、品牌定位四个选择,而且四个有次序——地区排第一,先抢欧美(东南亚、中东是赚钱却不涨品牌的「后花园」),「你去欧美才能做大」,Cupshe 夫妻俩备了 5 万美金的第一盘货就直奔美国;大小公司都该从单一市场、单一品类、单一渠道、单一品牌的「四个单一」起步。
在生产里跑得好的商务 agent 共用一套「只需决定一次」的简单架构:一个 Claude 模型跑在标准 agent 循环里,前面不设意图路由、后面不挂领域 agent——长尾功能用按需加载的 skill 而不是 subagent(每次移交都丢状态,还可能多花几倍 token、多几秒延迟;多个企业部署对比下来「单 agent + skill」质量始终最好),工具直接调用你已经在跑的搜索、库存、促销等系统而不是让模型重造一遍,连商品轮播这类 UI 组件也做成工具,好让 agent 知道屏幕上此刻有什么。
界面自己调 API 取数,对模型就是黑箱,用户一追问「讲讲第一条」「给公司排个序」它就答不上。所以规则一是「凡是展示给用户看的东西,也都要作为数据提供给模型」:structuredContent 和界面一起返回、保持同步,用户在界面里点了什么也用 updateModelContext 推回去;规则二是在 tool description 开头写一句「结果已作为 UI 组件自动展示给用户」,免得模型再用文字把结果重排一遍。
前 Meta 工程经理、前 Amazon 软件工程师 Ken 四年多没写过代码、也从没做过游戏,借 AI 做出的文字放置手游 Harpagia 过去一年收入超过 15 万美元(月均约 1.3 万)、广告费为零、每月运营成本约 500 美元——撑起这盘生意的只是 3,500–4,000 个月活玩家。
发布与路线:Google DeepMind 本周放出 Nano Banana 家族最快最便宜的 Nano Banana 2 Lite(约 3 秒出图),和首次对开发者开放的 Gemini Omni Flash 视频 API(定价同 Veo 3.1 Fast);三位嘉宾判断专精模型短期仍会并存、五年后大概并进一个输入输出全模态的 Gemini,而 Shane 眼里视频模型的真正定位不是生成好看视频,而是和语言互补、做出 AGI 必需却还缺着的那块时空基础模型。
Billy Howell 把自己的本地 newsletter The Arlington Bagel(每周四发给 6000 位阿灵顿居民)整个交给一支 Grok Bot agent 团队:第一天只建一个 chief of staff,让它盘点生意、推荐最先该建的三个 agent;任何活先让它亲手做一遍、你审过,才「挣到」把它固化成专职 bot 的资格;节奏是第一周组队、第二周只执行不折腾、第三周招人开人、第四周自动化。
Peter Yang 同时养着四个能读邮件、用他的账号登录、替他花钱的个人 agent,本期只问一件事——哪个敢信:体验最好的 Instinct 住在一个 iMessage 对话里,靠后台定时任务主动把事跟到底,可为了帮他取消一个每月 100 美元的续费,它先后要走了两步验证码和 Google 密码;而且它把复杂性藏得越好,你就越看不见它在幕后干了什么。
结论反转,赢在 UX:和 Grok Bot 共事几周后,Claire 干掉了所有 OpenClaw、几乎全搬过去(ep182 首测时还不肯搬)。OpenClaw 立了队友型 agent 的标杆,可连她这么懂技术的人都维护不动;「开箱即用、能搞定 90% 需求的同事型 agent」让她放手同时跑着约 30 个 bot。
Greg 从过去 30 天受关注的 GitHub 仓库里挑出五个免费开源项目(开头口播说六个,实际讲了五个):Peter Yang 的 No AI Slop Skill、trycompai 的 agent 原生 CRM、Browser Use 团队的 Video Use、NVIDIA 的 SkillSpector、Phone Harness——理由是「你今天在 GitHub 上看到的工具,就是半年后大家都在热议的东西」。
模型越强,AI 3D 越往「能落地成实物」的场景收:只需要视觉化表达的 3D 需求(游戏、影视)正被视频模型和 coding 分走,实体制造却「很难用一个视觉化的表达来去解决生产的问题」,2026 年上半年 3D 打印已经是 AI 3D 的第一大场景;数美万物因此把功夫下在基模之后的整条管线上(拆件、加连接件、自动摆盘、按材料调参、对接设备),目标是先做 Maker 行业的 OS,再做制造业的 OS。
Melio 的 PM Daniel Blum 用 Claude Cowork 搭了一套替他扛「协调杂务」的个人操作系统:Notion 三栏看板对他只读,由周日的 weekly prep 和每天的 morning brief 两个定时任务代管,电脑前 70%–80% 的时间都走 Cowork——他敢说「以前要花我一周的活,现在我一天就能干完」,而且活更深:更多调研、更有数据支撑、少凭直觉。
今天的购物 agent 大多是「搜索框套壳」,默认用户意图清晰、手握关键词;Google DeepMind 产品人 Nidhi 主张把系统设计成「随时准备好接住 vibes」,走「发现(沉淀带置信度的工作状态、找意图缺口)→ 研究(多模态引导 + 后台比较权衡)→ 自适应回复」三段循环。
40 年来是人迁就静态软件,AI 本该扭转这一点——但 commercetools 早期把界面排版全交给模型,同一句「生成一份 Q1 销售报告」连跑四轮就出了四种互不一致的界面,连标题都从 Q1 变成「1 月和 3 月」,Gus 的评语是「不行,不行,还是不行」。
UBS 分析师 Karl Keirstead 与 Palantir 管理层会面、参加其 AIPCon 客户大会后,重申「买入」、目标价 200 美元,认为 Palantir 在大模型厂商和数据平台的夹击下依然强势。
微软把本体定义为"企业词汇 + 语义层":用实体类型、属性、关系(外加约束)把跨业务域的含义统一起来,定义完再绑定到 OneLake 里的真实数据,作为人和 AI 智能体共用的上下文层——这是官方预览版文档的自我描述,全文没有给出任何效果数据。
Palantir 是「一类一家」——一体化平台、精英驻场工程师、关键任务政府/国防环境三件事同时拔尖,估值达明年营收 77 倍;而满街喊「我们是 X 领域的 Palantir」的创业公司大多只抄到驻场这层皮,最后会沦为顶着软件估值的昂贵服务生意,用作者的话说是「前端更漂亮的 X 领域的 Accenture」。
本体不是换个名字的数据模型,而是「名词 + 动词」一起定义的运营层:传统数据库设计只管名词(数据),把动词(业务逻辑与更新流程)丢给另一个应用层;Palantir 把对象 / 属性 / 关联(语义)和动作 / 函数 / 动态权限(动力)放在同一层定义,同时建好「看的模型」和「改的模型」,动作结果直接写回——数据从「只供查看」变成「直接驱动业务」。
本体是按业务「怎么说话、怎么运转」建模,不是把数仓表、系统表搬进来:Palantir 的四条根本原则——领域驱动设计、不要重复自己、开闭原则、组合优于深层级——每条都对着一个一线最常见的反模式:一张 order data 表一比一建成「上帝对象」、销售 / 支持 / 计费三个「客户」各自为政、往已经上生产的对象上加字段、把建筑挂成一条父子长链。
Palantir 前置部署架构师 Chad Wahlquist 的底层主张是「人和 AI 协同」:LLM 没有你业务的世界模型,得靠本体来补——而本体不是 1996 年 Kimball 维度建模那种行和列,是能把 CAD 文件、图片、表格装进同一个「工厂」对象的多模态语义对象;同一个本体同时喂运营应用、KPI 和 agent,每接一个用例都在叠加复利。
Palantir 自己的业务早就建在本体上,今年上线的 OMCP 只给 agent 一个 MCP 入口——里面不是 20 个系统的原始数据,而是建好模的对象、对象之间的关系、管理员开放的动作,外加原样继承的个人权限(还能按安全标记把 PII 挡在外部工具之外);所以 Claude Code、Codex、Copilot 随便哪个接上都「说同一种语言」,分析离「一次做对」近得多,也少烧很多 token。
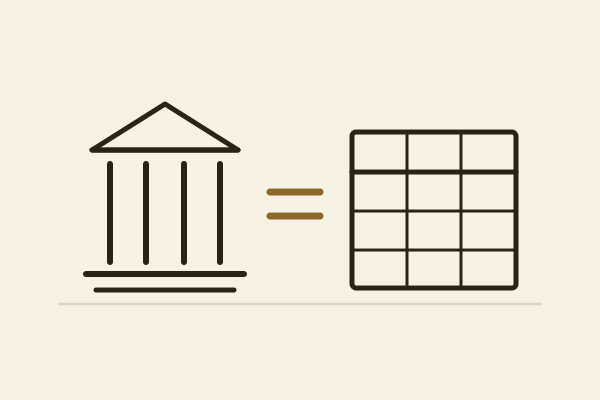
Palantir 的"本体论"在技术上就是数据库建模:老冯用一张"罗塞塔石碑"对照表把四个原语逐一翻译——Object Type 是表、Property 是列、Link 是外键、Action 是存储过程——Palantir 自己的专利也写明 Ontology 就是 database schema、就是 data model;同一个想法 2300 年里已被重新包装卖了五次。
Morning Brew 联合创始人 Alex Lieberman 把自己十年的内容流程原样画成图、再按「假设没有任何约束」重建成一台内容机器:Oracle 每天扫过去 7 天的内部系统与关注账号、吐出 15 个「内容爆点」→ 六位世界级访谈者人格轮番提问、把你的想法口述成稿 → 按你专属的 voice / style guide 起草 → 六个写手人格打分,不到 9 分就重写到 10 分。
AI 产品正在走过三个纪元:第一个是聊天,第二个是「和 agent 一起干活」(迄今主要是编码 agent),第三个——「可能很快到来」——是和一个常驻、不下班的 AI 同事协作:它干一大堆活、你给输入、它接着干,你们按不同节奏碰头看彼此没做完的活,甚至几个人带着各自的 agent 一起把事做完。
评测标准分两半:自上而下(凭对任务的理解想出来的)AI 帮你写得很好,自下而上(翻大量真实输出后长出来的直觉)「Claude 特别特别不擅长,那部分完全靠你自己」——绝大多数人手里那套 eval 只有前一半,所以永远评不出真问题。
今天真正的核心技能是「管一大群 agent」,而它靠的是老派的管理功夫——Ryan 一个人同时跑 10-15 个云端 Devin 线程,靠 Bugs / P0 / P1 / P2 文件夹把它们压回人脑能盯住的四五个桶,外加一张手写的周优先级纸;Claire 则反过来给"自己的时间"分块。"你职业生涯里练出来的那些管理能力,现在正好能用在这儿。"
AI 扩张的瓶颈正从电力/数据中心切回芯片本身,终局(2028-29)落在供应链最底层的 ASML:一吉瓦算力约需 3.5 台 EUV 光刻机,2030 年全球存量约 700 台、全给 AI 也只支撑约 200 吉瓦/年——这就是算力的物理天花板。
美国军事史上真正管用的东西全是「异端者」(军队里的创始人式人物:Rickover、Boyd、Higgins、Kelly Johnson)干出来的,「凡是走流程出来的什么都没交付」——今天重建威慑的答案不是采购改革,而是「人即项目」、把疯劲找回来。
Hugging Face 工程师 Niels Rogge 把自己「劝研究者把模型从 Google Drive 搬上 Hub」的日常工作交给了 agent:每晚一个 cron job 读几百篇 arXiv 论文、自动开 GitHub issue/PR,几千个 issue 只收到 2 条负面评论。
AI slop(AI 味的粗制滥造 UI)不是玄学,是一张可枚举的破绽清单——紫色渐变、标题斜体、scroll to explore、全大写胶囊标签等 20-30 项——完成后多花 10-20% 功夫专门打磨 UI,就是 AI 应用最大的竞争优势。
agent 是不可信软件,守卫不能放在 agent 里面——Opus 再对齐也可能被 prompt injection 带偏,安全不能是「一厢情愿指望模型听话」,边界必须在 agent 软件之外,包括安全插件、改 agent 代码都不算数。
Basia Kubicka 6 个月从 0 到 5 万粉(现 7 万)、每周 5 个 inbound 工作邀约,靠的不是粉丝数而是一套可复制的系统——档案(当落地页而不是简历)、内容(被动人脉)、评论与私信(主动人脉)三件事;招聘方找到你的三条路径共同瓶颈都是「头像 + tagline」。
Uber 几千名工程师、12 个站点,一年内做到 70% 的 PR 由 agent 生成、人均代码量翻倍、250 项自动迁移改了 900 万行——靠的是六个平台级构建模块(模型网关、MCP 网关、agent 化 Devpod、skill 生命周期、上下文图谱、Cortana 助手),而且站在六年 monorepo / Bazel 基建之上。
搭 agent 已经不难了:六个月前要一个团队干一个季度交的那些「税」(状态持久化、沙箱、可观测性),如今被云厂商原语 + 框架兜住,定义一个 agent 只剩选模型、写指令、给工具、给 skills、定沙箱五件事。
Kieran 今年一行代码没写,却一个人 ship 了几千人托付邮箱的 AI 邮件产品 Cora——靠的是「把我的思考方式和品味抽取出来,放进一个能复利的系统里」;他的判断是「一个带着复利系统的工程师,直接碾压整支没有复利系统的 AI 团队」。
harness、loop 这些 agent 调优技术终将变成大路货甚至 frontier lab 的标准服务,不会是你组织的差异化优势;「这在我们这儿行不通」的真实含义是「我们还没搭好架子」——差异化在团队、平台、组织怎么跟着变。
Warp 云端 agent 平台 Oz 的一条总原则是「平台在复杂性触达用户之前先把它扛下来」,落成四个原语设计:sandbox 托管 + 自托管并存、兼容任意 harness 但用平台护栏防体验碎片化、调研 / 实现 / 验证拆给不同 harness 和模型的 sub-agent、以及为栈里每个组件都开 API 让别人在上面搭。
这轮 AI 最先见底的可能不是算力、也不是电,而是钱。 今年全行业 CapEx(资本开支,即买地、建数据中心、买卡这类一次性大钱)约 8,000 亿美元,明年按现在的估算约 1.3 万亿美元;而资金已经沿「自由现金流 → 债券市场 → 增发股票 → NVIDIA 攒 5,000 亿美元 的盘子去接养老金与保险浮存金」这条资本曲线一路走到第四层——Ben 真正担心的是时间错配:钱烧完了,收入还没接上。
他的打法不是"用 AI 批量生产",而是"把每一件反复做的事固化成一个 skill,然后让这些 skill 自由混搭"——skill 不是坐下来设计出来的,是从日常干活里长出来的:干完一件有用、以后还会反复做的事,就跟 Codex 说一句"把这个做成 skill"。
瓶颈已经从「写代码」挪到「评审代码」,而这道闸门其实早就塌了——code churn(代码返工量,写完没多久又被改掉或删掉的那部分代码)涨了 861%,事故数与 PR 数的比值在上升,等 review 的时间是过去的四倍,超过 30% 的改动完全没经过评审就直接合入主干。Ankit 的判断很直白:「我们其实早就已经不 review 了。」
模型每周都在变强,但只在 IQ 这一条轴上变强——「你跟它们对话的时候,总感觉它今天是上班第一天」。Arjun 的类比是:把 Terence Tao(当代最顶尖的数学家之一)扔进一家会计事务所,第一天他多半不是那儿最好的会计,可给他几年、甚至几天就会非常好——真正被低估的是与智力正交的那条「经验」轴,Trajectory 这家公司要填的就是这道 experience gap(经验鸿沟)。
今天几乎所有公司的组织架构图,底盘还是两千年前罗马军团那套「靠人当传导管道」的科层结构——指令一层层往下传、报告一层层往上收,中间每一环都是人;AI 真正拆掉的不是某个具体岗位,而是「组织必须按层级搭、人是那个协调机制」这个从没被质疑过的默认假设。
花 500 多美元跑完 11 组对照实验后,他们撞上一个所有人都没料到的结论:完全不动 context、把完整历史原样留着,在「记得住 / 更便宜 / 更快」三条战线上同时打赢了所有 compaction(压缩,即把长对话历史摘要成短的再喂回去)技巧——因为一旦把历史 tool 输出裁掉,agent 就得为它本来已经拿到过的信息再检索一遍,反而更慢更贵。
harness(外壳/骨架,即包在模型外面那层负责调工具、管上下文、决定下一步做什么的代码)的本职只有一句话:在正确的时间点,把正确的 context 送到模型面前。 今天外面几乎所有 agent 的内核都是同一个「LLM 在循环里不停调工具」,所谓高级 harness 不过是在这个循环的几个固定位置上挂了钩子。
Yana Welinder 一个人在做 AI 原生时装品牌 Yana Banana,AI 不是她的工具而是她的岗位——「换作平常,这种事我肯定得雇一支技术团队,比如工程师什么的。但我没有」,网站、支付、投票数据库全是她直接让 Codex 建出来的,「它简直就是我的技术联合创始人」。
GrokBot 的魔力不在模型,在 plugins——杀手锏是「一个 connector 能接多个账号」:她接了四个 Gmail 还能横跨账号一起查,原话是「这件事 Codex 没搞明白,Claude 也没搞明白」。
sovereign AI(主权 AI)= 公司自己拥有智能、一路拥有到模型权重那一层——但这不是劝你弃用 Opus 或 GPT,而是说产品里越来越多的环节值得垂直整合进来自己做。
做一件事所需的资源(时间 + 专家深度)正在坍缩——过去几十个强产品工程师加 PM 干好几个季度才能交付的东西,现在一个人、几周、不写一行代码就能做出来;后果不是"效率变高",而是应用层的护城河正在被抹平,竞争被推着从"在现成黑盒 API 上搭壳"转向"拥有自己的智能"。
RL environment(强化学习环境,说白了就是给 AI 搭一个能反复动手、又能被逐条打分的仿真工作场景)拆开只有三样东西——worlds(世界:真实项目里的消息、文档、表格)、apps(应用:Salesforce、Microsoft 365 这类主流软件的高保真复刻)、tasks(任务:一条 prompt 配一个负责判对错的 verifier);前沿实验室想把「你在笔记本上能干的活」全自动化,卡点就是把这三样铺满整个经济体。
Rich Sutton 的核心指控只有一个技术事实:今天的大语言模型在上线前做完预训练和后训练之后,权重就被冻住了——「它们的权重从来不变」,你跟它聊多久它都不再从经验里学;所以在他看来,怪的不是他,而是那些「声称一个完全不再学习的东西能有博士级的经验和专业水准」的人。
设计师是 Lenny 那份全行业心态调查里最不开心的人群——每一个维度都垫底(最不堪重负、最焦虑、最不乐观、最疲惫、最不愿把这行推荐给新人)。Ian Silber 的诊断不是"要被取代了",而是"不知道别人期待你干什么":工程师那边的转型已经走完了一轮,设计这边还悬在半空。
AI 时代活不下来的只有两类人:一是「纯 people manager」(只管人、不碰活儿的管理者——日程排满一对一、像员工的心理咨询师那种),二是僵化、不肯改变的人。Chesky 的判断是往后每个人都必须是「管人 + IC(individual contributor,一线亲手做事的人)」的混合体:工程主管得写代码,律师得亲自读判例,设计负责人得亲手做设计。他的原话是「你管的不是人,你管的是活儿」。
ChatGPT 的增长可以拆成三个整齐的三分之一:三分之一来自「消除摩擦」(最大的一笔是去掉登录墙)、三分之一来自研究与产品合力做的核心产品投入(搜索、个性化、写作块)、三分之一来自纯模型进步——而分发本身证明不是护城河,Google 和 Meta 手握三四十亿用户也没能一按开关就赢。
黄仁勋当面否认「护城河 = 供应链锁定」这个流行叙事:近 1,000 亿美元采购承诺(外部估算 2,500 亿)只是「我们能做而别人难做的事情之一」,真正的飞轮是四件事叠加——每美元性能最低的 token 成本、全世界最高的每瓦 token 数、几亿块 GPU 的装机量、以及「每一朵云里都有」带来的客户触达。
「什么会稀缺」这个问题,本质上就是「价值最终沉淀在谁手里」的问题——AI 让智能变便宜之后,稀缺性只会挪到别处,而不会消失;两位经济学家反复强调:真正决定答案的不是直觉,是两个我们现在根本没有数据的量——需求弹性,和「人在环」到底值多少钱。
一道简单的减法逼出全部结论:实验室收入每年 10 倍、可拿到的算力每年只有 3 倍——这个缺口只能由「实验室利润率上升」或「算力价格上涨」来填,而 Dwarkesh 认为利润率超过 90% 还不被竞争抹平不现实,所以只剩算力涨价这一个出口。
上下文工程之所以一年后还没过时,是因为它不押在某个模型上,而押在「Transformer 注意力是二次方的」这个物理事实上——你唯一能影响 AI 输出质量的手段,就是精心挑选和排列输入;而输入不只有「信息预算」,还有大家常忽略的「指令预算」(前沿模型大约 150–250 条指令后就开始跟不住)。
"我们会不会发自己没读过的代码"不是一个是非题,是一个时间题——Charity 说争论"会不会 / 什么时候"没意义,正确的问法是「要满足什么条件,你才会觉得这可以接受」;而答案是一本信任账户:你在"代码创作"这一栏支取了信任(没人读过),就必须在测试、evals(自动化打分)、一致性测试、护栏、遥测上把它补回来。
ElevenLabs 600 人、6 亿美元 ARR,从成立到今天一个 PM 都没招过——替代方案不是"CEO 兜底",而是三件事叠加:5–10 人的小团队 + 在每个非工程团队里都嵌一名工程师 + 招"一专多通"的人(至少一个领域是专家、另一个领域理解得非常好),再让 AI 把每个人在其余领域从业余抬到进阶。
AI 把「被颠覆的概率」整体抬高了一档,长期投资的第一问从「这门生意好不好」变成「斯坦福车库里的两个人能不能把它干掉」——算力、资本、人才三样接近无限可得,Ackman 说他绝大部分研究时间就花在这一个问题上。
一个 20 年没换过的镜头:S 曲线 + 竞争优势 + 被低估的盈利能力。 踩对 S 曲线那一段,销量指数增长;再叠一个强商业模式,利润就不是线性长而是指数长——所以他能用 4 倍市盈率买 2023 年的 NVIDIA、5 倍买 2019 年的 Tesla、买 Amazon 时 AWS 相当于白送。
上一个周期(云)的完整历史,就是这一个周期(AI)最好的推演模板:2007 年 30 个最聪明的投资人对 AWS 全判错,2014 年「AWS 会吃掉一切」也错得离谱——不是因为具体反例,而是因为所有人都把市场估小了;最后的结构是 AWS/Azure/GCP 大致 40/30/20 的寡头,外加 Cloudflare 这样在缝隙里长成 1000 亿美元的「小赢家」。Eric 认为 AI 会重演同一个结构,「Anthropic 会吃掉 98% 的价值」这类零和叙事站不住脚。
OpenAI 对「护城河」的最新自我认知,是这期最值钱的一段:Sam 直说智能本身正在走向商品化——"卓越的智能可以从任何一个产品迁移到另一个产品",产品优势会被下一个更好的产品夺走;真正持久的只有算力集群的规模与造算力的能力,其次才是工作流、集成、团队协作与品牌熟悉度。
Anthropic 传出以 2 万亿美元估值、最快 10 月上市,年化运营收入将在 1000–1200 亿美元收尾、连续三年同比 10 倍;三位嘉宾一致把明年退出 ARR 的大小盘线划在 4000–5000 亿美元,并认为它的招股书会成为整个 AI 行业最重要的需求信号——「领跑车」一脚急刹,后面就是连环追尾。
AI 资本开支这轮不是在见顶,而是在「单位变现率上涨」这个反直觉的方向上加速——2027 年全球 capex 大概率逼近 1.5 万亿美元,而每吉瓦算力的年变现从年初的约 200 亿美元涨到现在 300–400 亿,「所有人以为 token 会平滑通缩」是今年被打得最狠的一条叙事。
七月 AI 股一个月直线跌 40–60%,但基本面同时在改善——Gavin 在硅谷待了一周,把「你有没有听到过哪怕一个负面的量化指标?」这个问题问遍了所有人,答案是没有:GPU 可得性、GPU 租赁价、DRAM 现货价、token 增长,全在加速。价格和基本面之间正在拉开一条肉眼可见的缝。
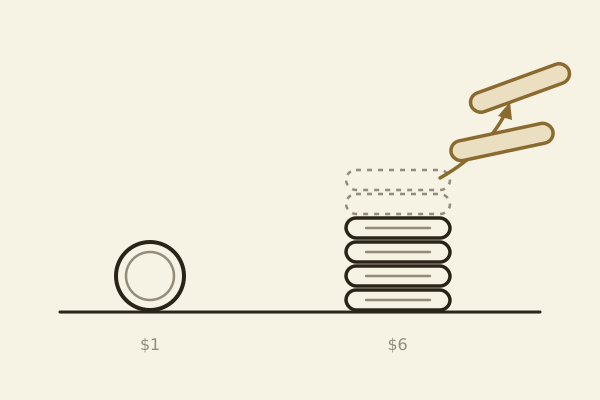
企业软件有条老规律:客户每花 1 美元买软件,就要再花 6 美元把它用起来——AI 时代这 6 美元的生意正在被重新分配,这是 OpenAI、微软(25 亿美元 + 6000 工程师的 Microsoft Frontier Company)、亚马逊集体从 C 端杀回 B 端的原因。
1945 年,Vannevar Bush 在《As We May Think》里一口气预言了屏幕上的文档显示、文档扫描与 OCR、语音转文字与文字转语音、编程语言、超文本、搜索引擎、数据网络、类似 GoPro 的随身相机、语音界面和脑机接口——在这些东西一个都不存在的时候。讲者说,我们今天的处境和他一样:站在一个新时代(智能时代)的开端。
核心论点:个人化的 AI codegen 会打破传统云基础设施。今天的软件是"开发者在象牙塔里做好、往下发给所有人跑同一份钦定版本",用户的功能请求被产品经理"一股脑丢进 Jira,从此再没人见过它们";要让每个人当场把 app 改成自己要的样子,这套底座必须换掉。
Wisedocs 处理的是动辄上万页的医疗理赔 PDF(有些文件比视频文件还大),跑这条 AI 管线的代码散在十多个 repo(repo =代码仓库,一个独立管理、独立发布的代码包)里、已经存在六年多、没人愿意去碰;2025 年他们决定用六个月把它合并成一个 monorepo(单一大仓库,所有代码收进同一个仓里管),这场演讲就是讲者的诚实复盘——这一步到底该现在做,还是该等模型再变强两代?
三行大白话,换回一整份作业手册。 Idan Gazit(GitHub Next 负责人,GitHub 的实验室团队)像给团队里一个初级开发发 Slack 消息一样写了三行字——"每天看看有没有新版本、读 changelog(更新日志)和文档、想个升级方案出来、开个 PR"——Copilot 就把它展开成一份完整的 playbook(作业手册,即一步步该怎么干的流程稿),真的把他的个人网站从 Astro 5 跨两个大版本升到了 Astro 7:改好被升级弄坏的代码、跑构建验证、还把他自己必须动手的手工步骤单独标了出来。
这是一场"把 Codex 的引擎盖掀开给你看"的工程分享:讲者 Dominik Kundel 用 2 倍速讲完 20 分钟,视角是「你按下回车之后,harness 里到底发生了什么」——harness(可以理解成"挽具/外壳",就是承载模型干活的那层程序:给它工具、组装上下文、跑循环、收结果)。他反复强调:这一切都是开源的(「it's MIT it's Apache 2 license」——他现场自我更正了一次),用 Rust 写的,你可以学它、可以拿它去问 Codex、也可以 fork 一份改成自己的。
便宜模型的总账更贵:拿 terminal bench(一类让模型在命令行环境里实际动手完成任务的评测)去跑,Opus 的分数大约好 3 倍,总成本却只有 Haiku 的十分之一——尽管 Haiku 每 token 便宜得多。原因是小模型一旦被推出自己的训练分布,就会疯狂调工具、陷进循环,轮次多到把单价差距吃干净还倒贴。
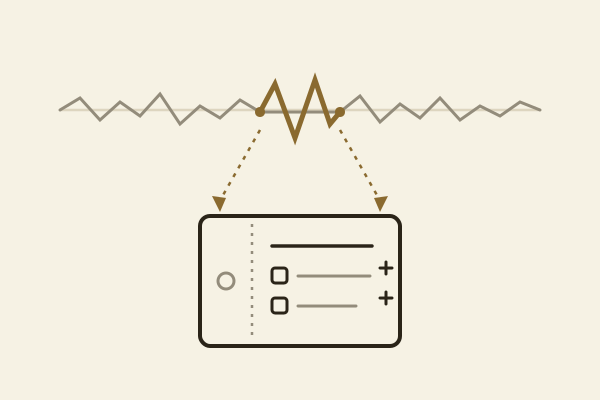
展台上一台会议 bot 听了 4 小时 Google Meet,自己从对话里捡出一个想法、自己开了 ticket、自己给产品的建单表单加了两个「验收标准」字段——全程没有任何人做任何手工操作。 这是全场最实的一幕,也是他整套主张的证据:每一通客户电话、每一次 onboarding、每一条 bug 报告,都是可以直接变成代码的需求信号。
Grace Clarke 不是工程师——市场顾问出身的 AI 讲师,今年一月才开始自学,把 Claude Code 下载好晾了两个小时才第一次打开,对着它一顿说,现在整个服务型生意(线索推进 → 提案 → onboarding → 课前作业 → 进度追踪 → 收件箱)都跑在她自己造的几个 skill 上。
「模型能力已经够了,要卷就卷 infra。」 全场暴论,也是标题来源。依据是他的一线体感:最新一代旗舰模型跟他之前用的 Claude Opus,「对于开发者来说没有本质上的区别」,爬坡「已经开始放缓」。卡住智能体落地的不是智商,是基础设施和 harness(harness = 包在模型外面那层"外壳程序",负责读文件、调工具、管上下文——Claude Code、Codex 都是 harness)整块没跟上。
AI 让 PR(pull request,一次「请把我这段改动合进主干」的申请)多到审不完,但正解不是「人审得更快」,而是「不是每个 PR 都需要人来审」——Intercom 已经把这条路走通了:AI 批准的 PR 比人审的快 5 倍,上线后要返工/回滚的比例反而更低。
「速度病」(velocity sickness)= AI 让产出突然暴增所带来的那种压力,个人和团队都会得,结果是「有产出,没影响力」。 最锋利的一刀来自一个用 agent 管线写 newsletter 的人——他说"我基本上每周写一本书",Matt 问"那你的读者每周读一本书吗?",对方说"大概不会吧"。
agent(智能体,即"能自己调工具、自己跑多轮、直到把任务干完的 AI")的本质就是"把 LLM 放进循环里反复调用",但 Linear 一年实践下来最重要的一条是反直觉的:指令给得越少越好。 Jacob 的原话是"你要尽可能少给它指令。给它能加载 context(上下文,即模型做判断时手上有的那些材料)的工具,而不是直接把 context 喂给它——这是我们摸出来的一条挺重要的原则"。
Anthropic 三月刚发布的 Claude Certified Architect(CCA,Claude 认证架构师)考试,与其当成一张证书,不如当成一本 agent 工程的「反模式手册」——它给六个生产场景、考试随机抽四个出题,而答对的钥匙常常是"知道什么不能做"。
一个 harness(外壳/脚手架:包住模型、替它跑循环、管上下文、调工具的那层程序)里编码的,是一整套关于「模型自己做不到什么」的假设——而这些假设会随模型变强而过期。 Anthropic 的教科书级案例是 Sonnet 4.5 的「context anxiety(上下文焦虑)」:模型快撞上下文上限时会提前收尾任务,于是他们在 harness 里加了上下文重置来补偿;Opus 4.5 出来后这毛病彻底消失,那个补丁就变成了纯开销——增加延迟,还导致缓存被错误丢弃。
卡内基梅隆(Carnegie Mellon)的研究发现:用 AI 工具写代码带来的生产力提升只持续约三个月就掉回原位,但 static analysis(静态分析——不运行程序、直接扫源码找隐患的自动检查)的告警数和代码复杂度却是持续上升的。省下的时间被后面的返工吃回去了,这笔账就叫「验证债(verification debt)」。
产品判断力可以被写成 skill,跑在跟工程师同一个 repo 里。 Oji Udezue(Typeform / Calendly / Parable 三度出任 CPO,前 Twitter 创作与创新产品负责人)的判断是:GitHub 上的 skill 仓库全堆在写代码这一层,但一家科技公司其实是三层——软硬件、产品(客户与商业模式)、生意(资源怎么分配);只优化最底下那层,工程一提速,PM 就成了整条链的瓶颈。
使命、愿景、价值观是"死"的,战略是"活"的。 这是全场的骨架:使命 / 愿景 / 价值观一旦定了就不许改,它们的用处只在一个时刻——公司生死攸关、要在两条路里选一条的时候,"平时没有用的";而战略必须能往东跑往西跑地迂回,"能复制的都是复制品,不能复制的才叫战略"。
7 月 27 日月之暗面放出 Kimi K3 完整权重,一个不到 3T 参数的开放模型追平了传言 8–10T 的闭源前沿——硅谷赖以安心的那句"闭源永远领先开源一个世代",第一次失效了。
一种新面试轮次正在铺开:vibe coding 轮——不是 product sense,也不是工程 coding,而是两者的混合:45 分钟里拿出 30 分钟,当着面试官的面把一个功能从想法推到能在浏览器打开的原型。Google、Meta、OpenAI、Anthropic 这类岗位年薪 30 万到 100 万美元以上,有的 CPO 会直接让你共享屏幕看你怎么用 AI。
今天几乎 100% 的 LLM 都是 RLHF 训出来的,而 RLHF 优化的目标是「人类偏好」——所以模型不是碰巧有个人在回路里,是它的目标本身就是取悦回路里那个人;过度承诺不是 bug,是设计出来的 feature。
分数和体感对不上,病根在激励和方法论,不在「基准」这件事本身。 开场四问四答直接给完:benchmaxxing(刷榜)为什么发生——因为激励机制;传统基准为什么不准——因为方法论太烂;这是所有基准的绝症吗——不是;我们最终能不能知道哪个模型最好——能。
Netic 把 AI 塞进「必需服务」企业和它们客户之间的那道缝——HVAC(暖通空调)、水暖、屋顶、宠物、酒店、健身会员这些年收入十亿美元级的公司,从接电话、判断需求、匹配运营规则一直到派工,全跑在 Netic 上;今天超过 70% 的客户是「Netic 优先」,客户与公司的第一次接触就是跟 AI 说话。
Hermes 跟 Claude Code / Codex 的差别不在模型,在"谁的 reward"——Karan 的核心判断是:模型的 reward 从来不是"让你满意",而是"拿到 reward 本身",所以助手会 reward hack("你说得完全对"就是典型症状)。Hermes 这套 harness 的全部设计目的,就是把模型的首要效忠对象从 Anthropic / OpenAI 换成你这一个具体的人。同一个 Claude,第三方 harness 横评里跑在 Hermes 里比跑在 Claude Code 里表现更好。
瓶颈已经不是规模,是架构本身——过去六年我们只是在同样两种运算(MoE + attention)上不停堆参数;Jerry 的定性是 transformer 天生做不了 continual learning(持续学习,即模型边用边长本事),没有任何办法把它装上去。
新语音界面不是「语音转文字」,是「口述委派」——按快捷键弹出一个能看见你屏幕的光球,它把 ChatGPT 早就有、但没人发现的几个底层能力(开新 thread、给正在跑的 thread 追加消息、thread 之间互相说话)编排起来,你说一句就能同时派出五六个后台任务。
AI 擅长写代码,这不是模型的属性,是代码的属性。 代码能拆解、能验证、能执行,所以好训;设计和写作难,难在没人把它拆开过——"你怎么拆解它?怎么验证它?怎么判断它到底好不好?"
一套六步的 AI-native 设计流程,全程不开 Figma:定义用户问题 → 找灵感写 design.md → 在 Claude Design 里探索原型 → 用 HTML 写一份含产品/设计/技术三个 tab 的 spec → 让 spec 驱动出全部核心界面 → 最后才让 Claude Code 把 app 建出来。
MCP tasks 就是"让一个工具变成长跑作业":你调用它,拿回来的不是结果而是一个 handle(把手,可以理解成取件码),工具在后台慢慢跑、汇报进度、能停在"等人批准"这一步不动,最后你再凭把手取结果——而规范白纸黑字要求:task 一旦启动就必须是 durable(持久)的,client 挂了、server 宕了、人休假去了、连接断了,它都得活着,等基础设施回来还能接着交互。
MCP server 从此不必只回一段文字:MCP Apps 是 MCP 的官方扩展,从 Ido 去年 5 月做的 MCP UI 演化而来,和 Anthropic、OpenAI 一起共建——server 把一段 HTML 装进 MCP 早就有的 resource(资源,MCP 的一种标准原语)里,让 tool call 关联到它,host(宿主,就是 Claude / ChatGPT / VS Code 这类跑 agent 的客户端)拿到后把它渲染成一个真能点的界面。
「我们后悔产品经理这个岗位存在」不是要裁 PM,是要炸掉「每招 6 个工程师就配 1 个 PM」这条 HR 默认配比。 Whatnot 首席产品官 Tom Verrilli(前 Twitch CPO、前 Twitter 增长产品总监)的论证很硬:产品管理「是一门手艺,不是一纸资格证」,靠一组组练(reps)才长出来的肌肉;你越是把工程师和设计师从产品决策里抽离,他们那块肌肉越萎缩——「招这么多 PM,其实是在把工程师和设计师当小孩养,他们本来完全有能力做好决策,只是从来不需要做,因为身边永远有个 PM 替他们兜着」。跑出美国史上增长最快市场平台体量(GMV 已超 80 亿美元)的 Whatnot,今天只有 21、22 个 PM,而且不绑团队、只绑问题。
在心理健康 AI 里「凭感觉」(vibes)不算数——什么叫「回应得对」,由持证的临床团队定义,不由工程师、更不由模型自己定。 通用大模型本来就不是为心理健康照护造的,这个缺口已经酿成过真实的悲剧。
连造模型的人也说不准下一步会发生什么——能力是「不连续地跳」上来的(模型可能一夜之间从算不对 1+1 变成稳定算对),而没有 eval,你根本不知道这次跃迁已经发生了。所以这行的核心功夫不是预测,是「适应力 + 第一性原理」:新信息一来,你敢不敢当场推翻原计划。
在生成式 AI 时代,把「产品该做成什么样」讲清楚的最好方式不再是 PRD 里那些描述细节的段落,而是给一组例子——这组例子就是 eval:一批 prompt + 标准答案 + 一套判分方法;跑不达标就三条路,换模型、改 harness、改产品。
别把 FDE 当"派人去客户那儿干活",它是帮客户搭一座「软件工厂」——外部信号流进来(客户对话、bug 报告、Slack 讨论、高管一句话)→ 有人分诊排优先级、变成计划 → 计划变成对代码库的改动 → 改动过验证关卡(review / QA / 安全 / linter / 类型检查)→ 上线 → 上线的软件又产生新信号。这个闭环每个组织都在跑,但"老实说,在大多数组织里,这个闭环的可观测性做得非常差"。
执行已经不是瓶颈,「搞懂这门生意到底怎么跑」才是。 模型智能够用了、工具层(harness)也够健壮了,AI 端到端干完一件事今天人人都做得到;真正卡住的是——医疗公司的销售部和 SaaS 公司的销售部压根是两回事,你能不能把上下文从员工脑子里掏出来、喂进系统还不崩。
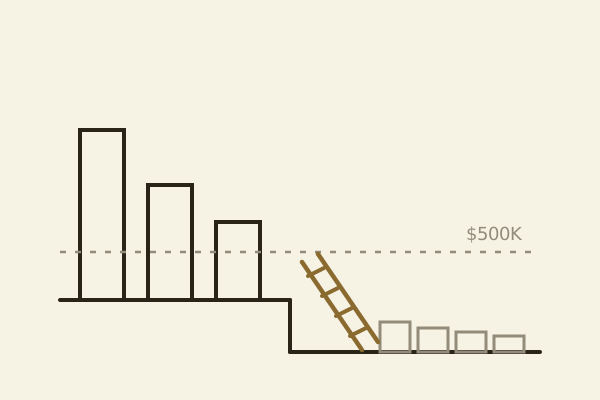
按 ACV(average contract value,平均合同价值,即单个客户一年在你身上花多少钱)排,Fortune 500 里的上市 SaaS 公司是 Palantir 400 万美元、ServiceNow 120 万、Workday 60 万,再往下没有任何一家能突破 50 万——这道悬崖就是 FDE(forward deployed engineer,前置部署工程师)存在的地方。
agent 今年真正走出 demo:95% 的受访者在用 agent(约去年两倍),其中 89% 拥有写权限(去年 52%),全体样本中"用带写权限 agent"的比例同比涨了三倍多。
HTML、CSS、JavaScript 是 LLM 的「母语」——它们的训练数据里绝大多数就是网页,所以与其教 agent 一门新的 DSL 或你自造的 JSON 结构,不如让它用母语说话,HeyGen 把整个视频生成栈押在了这一点上。
今天的分水岭是 harness,不是 agent。 去年在 AI Engineer 大家还在聊 agent loop、agent 和 workflow 怎么选;现在拉开差距的是 harness(外壳/驾驭层,即包在模型外面那层帮它拿上下文、调工具、管流程、扛失败的工程)——planning mode、并行 subagents、skills、后台任务这套开发者体验,才是它区别于「一个会调工具的 agent」的地方。
把 browser use / computer use 想成「一个能把手放到你键盘上的虚拟同事」,装好桌面 App + Chrome 扩展就有了;Claire Vo 说这是「AI 里最能改变生活的功能之一」,用完的评价是「满分 10 分我给它 100 分」。
Clay 被叫做「七年的一夜成名」,但 Kareem 自己的拆法是「两年在做东西、两年处在很迷茫的状态,然后我们才终于做了决定、重建了一些东西、全力投入,接着几乎立刻就看到了结果」——难的从来不是想点子,而是有勇气公开选定一个听起来很蠢的小方向,并停止听所有人(包括客户)的意见。
数据能取到不等于上下文对:text-to-SQL(自然语言自动转成 SQL 查询)和向量检索(把文字变成一串数字、按语义相似度捞相似段落)在几张表、几百份文档时够用,但表一多、文档一多,答案会「自信地给出错误答案」——真正缺的不是访问能力,是给 agent 一个能看清全貌的形状。
AI 程序应该像写函数一样写:给一个会反复执行的任务定死"输入什么、输出什么"的契约,把模型、prompt、agent、工具这些实现细节全关进盒子里——外面的集成代码永远不用改,里面爱怎么换怎么换。
当各家大模型能力趋同、参数不再是差异,留住用户的变成"AI 懂不懂你"——而这种品味/语感/共情,正被一群前记者编辑反向工程成可定义、可打分、可训练的工程,这个离用户最近却最不为人知的岗位最早叫"内容工程师(Content Engineer)"。
Notion AI 工程负责人、"靠谈 AI 合同为生"的 Sarah Sachs 拆穿每月准时上演的两个陷阱:推理模型"升级"后单价没变、却偷偷多烧 3 倍 output token(输出 token);或新版本贵 40%、还逼上一代在 4 个月内弃用——可你并没有同期增长 40% 或营收翻 3 倍,所以无脑自动升级就是在坑客户或坑投资人。
2025 年 7 月,HumanLayer 创始人 Dex Horthy 亲手跑了一个"熄灯软件工厂"(lights-off:没人读代码,需求和故障全塞进队列交给 AI agent),几个月后它崩了——一个 agent 怎么都修不好的问题冒出来、网站宕机,他被迫回去 debug 一个自己三个月前就停读的代码库。
讲者 Mike Phipps(Gates Foundation) 的核心论断:AI 前沿跑得越快,模型、chat 界面、agent 框架就越会被商品化,唯一持久、有防御力的 moat(护城河,能长期挡住对手的东西),是你对内部流程的理解——即"一个问题该按什么口径回答"的 tacit knowledge(隐性知识,写不进文档、只在老手脑子里的经验),连同承载它的 data model(数据模型,即业务对象及其关系的组织方式)。
ZS 把药企分析师"信号检测→找原因→定行动→看展望"四步各拆成一个 agent、再用一个 orchestrator(编排器,把多个 agent 串起来调度的总控)连起来,系统给的结论却"对因错药"——每一步事实都对,却没有任何一个 agent 统筹端到端全局。
AI 没有让职能消失,但让"极窄极深的专精"贬值、让"系统思考者"升值——Netflix 现在招的是能横着看完所有业务领域、然后抽象出"我们需要哪几块积木"的人,而不是"我是支付专家/我是前端专家"。
模型变聪明之后,「管得少」反而更好——Anthropic 把 Claude Code 的 system prompt(系统提示词,给模型的底层出厂指令)砍掉了 80%,因为示例会把模型往例子的模子里限制、硬约束里的 "never" 你其实很少真的是「永远」;Thariq 直说「现在大家的 CLAUDE.md 基本都太长了,你应该越删越短」,很多 skill 同理。
设计圈头部作者 Meng To(Design+Code 创始人)已全面弃用 Cursor、也不用 Claude,改押 OpenAI Codex 做设计与开发——理由是 token 慷慨得多、"项目=本地文件夹"的组织范式、computer use + 技能生态,"你能想到的一切、任何契合你工作流的事,都可以在 Codex 里完成"。
Company OS = 把整个公司的知识与流程沉淀成 GitHub 里的文件夹 + skill 文件,再装进 Claude:每个职能一个目录、每项活动一个 skill,让那 1% 重度 AI 用户设计出的最佳玩法,铺开给其余 90–99% 不知道"什么时候该用什么"的员工。
人人都在说"关键不是模型,是 harness",但没人解释 harness 是什么——Claire Vo(ChatPRD 创始人/CEO)一句话拆穿:harness 就是包在 AI agent 外面、让它更好用的一层代码,可以含 AI 也可以不含,目标只有一个:让 AI 在某个特定用例上表现更好。
构建 agent 别「逆着重力」:假设模型会持续变强,今天那些让模型听话的 prompt hack(就像当年手写 chain of thought)会越来越不重要、绝不是护城河——「让模型自己发挥(let the model cook),别硬把它往某个方向推」,真正的新关键是 tool engineering(给对工具)。
一个 PM 靠读懂一篇 Anthropic 博客里的「对抗性 agent」概念,在 Claude Code 里折腾一天,就在内部 hackathon 击败 30 个工程团队——秘诀不是代码,而是「系统怎么搭 + 让它测什么」的领域知识与品味(taste)。
造东西越容易,"想清楚该造什么"越值钱——品味、判断力、审美、真实性成了 AI 时代最稀缺、最难被自动化掉的资产;能吃到红利的人,是那些看清 AI 擅长/不擅长、还对它"将来会擅长什么"有嗅觉的人。
劳动力正悄悄裂成两半。 第二届科技从业者情绪调查(约 6000 名产品/工程/设计/研究/市场从业者)最大的发现:50% 的人觉得被 AI「放大」、干劲爆棚,另一半觉得根基被动摇、自我被贬低——AI 对「你怎么看自己工作」的影响,是「你的经理是谁」「你是不是创始人」这两大传统头号因素的约 3 倍,是史上最大的单一变量。
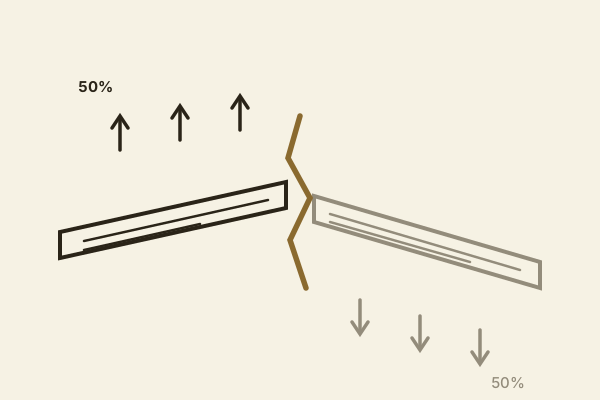
当写码被 agent 自动化,工程师的价值从"产出代码"转向"选择什么值得做、并为结果负责"——未来的工程师由"能选择什么值得做的人"来定义,掌握证据、理解与最终裁决。
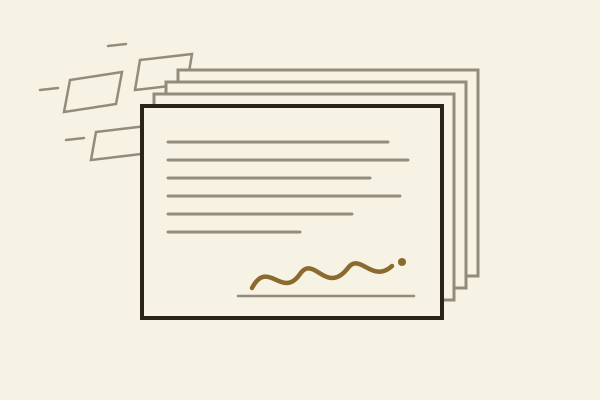
FDE 不是专业服务、更不是人力外包——先用「客户数字化成熟度 × 你产品的可定制性」这个 2×2 矩阵判断哪一格才值得投入你最贵的工程师,只有"高成熟高定制"和"低成熟需嵌入转型"那条带才是 FDE 的战场。
Anthropic 平台把能力叠成三层蛋糕——knowledge(知道怎么用 Claude)/ execution(让 Claude 真正干活)/ coordination(协调多个 token 一起干),团队路线图的重心正从底层一路往顶层的「协调层」爬。(harness = 套在模型外面驾驭它的"脚手架/驾驶舱",负责喂上下文、调工具、管循环;token = 模型处理文字的最小计费单位)
人人都在用 skill,却几乎没人给它做 eval:Skill Bench 从 GitHub 索引的 5 万多个 skill 里几乎没有一个带评测,大多是 AI 顺手写完、手动跑通两次、同事点个赞就上线——但 agent 是非确定性的,没 eval 你根本分不清任务失败是 skill 写得差、还是模型本来就搞不定。
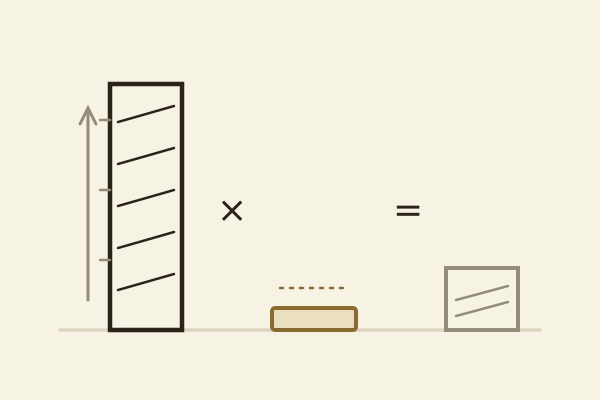
模型两年内从「考不过律师」变成「前 1% 高分」,却没变得更有用——只有 1/5 的 AI 用例上线、56% 的 CEO 说零财务收益;根因是 绩效 = 智力 × context,而 context(你业务的情境化知识)几乎原地踏步。
Claude Code 团队自曝产品内幕:内部版 Claude Tag(住在 Slack 里的多人版 Claude)已经承包了产品工程团队 65% 的产品 PR,几乎人人默认用 auto mode,外围代码的审查已完全交给 Claude——但这套"把人移出环路"是花六个多月、靠上千个 eval 一小步一小步建起来的信任,不是一夜之间的胆量。
硅谷今年最热的模型话题是 RSI(Recursive Self-Improvement,递归自我提升)——让 AI 自己出题、自己解、自己验证、再拿结果训练下一代自己;之所以今年才"从科幻走进现实",是因为模型跨过了一道能力坎:Claude 已能完成人类要 12 小时才做完的长任务,而"模型能干的活、按人类耗时算每 7 个月翻一倍"。
Naval 和三位创始人(YC 的 Garry Tan、做警务 AI 的 Daniel Francis(Abel)、做健康 super app 的 Farbood Nivi(A-LIST))圆桌聊「活在未来」——核心判断:未来约三年推理算力会涨 9 万倍(好几个数量级),每上一个数量级就涌现新能力;只要你愿意一年花 10 万美元买 token,现在就能过上「2028 年普通人」的生活。
500 天的主线是「GUI 退场 → Headless 上位 → CLI 复兴 → Skill 封装 → Agentic Economy 萌芽」,一句话总结:一切回到上下文管理(context)——变的是新概念不断被祛魅,不变的是模型能力持续进步、不断解锁此前想不到的技术奇观。
创业内幕请回纷享销客创始人兼 CEO 罗旭(深耕企业服务 CRM 15 年)回应"SaaS 将死"焦虑,核心判断是:AI 不会让 SaaS 消失,但会杀死"工具型 SaaS"——软件正从"给人用的工具/系统/平台"变成"给 agent 用的智能体操作平台",前端像一个数字化员工。
这是《科技早知道》在亚马逊云科技 AWS Summit 上海站录的 OPC(One Person Company,一人公司——一个人+一批 AI agent 撑起一家公司)线下圆桌,两位非技术背景的一线实践者——余一(自媒体一年从 2000 涨到近 20 万粉、把 AI 当能自主决策的"合伙人")和归藏(PPT skill 两万星、把 Agent 当要确定性的"工具")——拆解"一个人到底能用 AI 撑起多大生意"。
笔记多到 10000+ 条的真正瓶颈不是「上下文窗口不够大」,而是「记忆与上下文工程」——当 agent 把 context window 当成数据库+文件系统+记忆+推理空间一肩挑,对话一结束就全丢了;解法是给第二大脑搭一套「只在模型需要时加载它需要的那一点」的中间层。
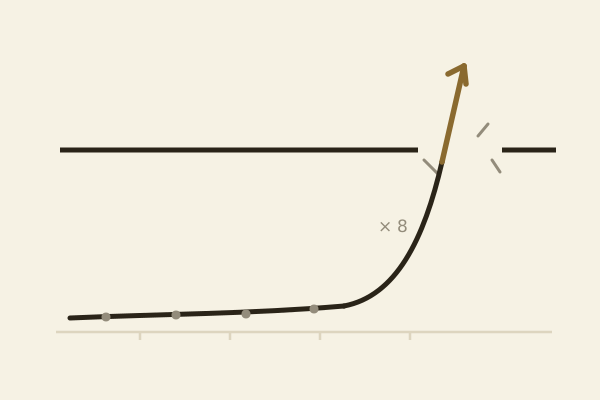
写代码不再是瓶颈,天花板被整个抬高,剩下的只剩"你能有多大野心"。 Anthropic 工程师如今平均每季度交付的代码量是 2025 年的 8 倍——曲线"平、平、平、平,然后砰地冲上月球";瓶颈从"写"转移到了"验证",而且现在工程师、设计师、PM 全在提交代码。理论上一切都做得到了,问题变成"你敢想多大"。
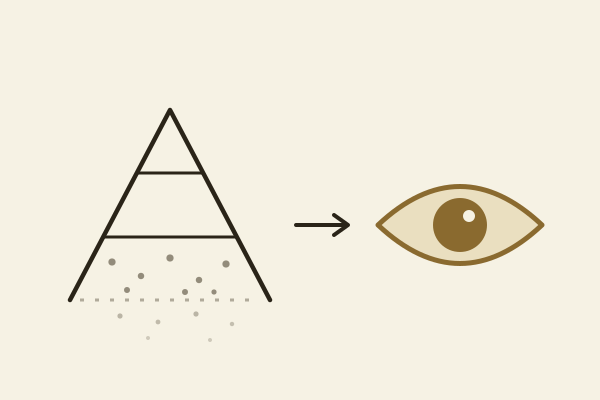
AI agent 正在把工程团队的"金字塔"拆掉、压成"眼睛形":过去成熟产品要靠经理 + 资深工程师 + 一大批初级人组成的金字塔来写代码修 bug,现在 agent 只要配上合适的 harness(脚手架/护栏)就能干掉大量杂活甚至部分设计活,团队变得越来越"头重脚轻",只留下真正懂"该做什么 + 该怎么做"的人。
别再往上下文窗口塞超长 prompt、也别一味外挂 RAG——把团队知识直接"烤"进模型权重,让模型像在你公司干了几年的老员工那样懂你。 这是 Engram(一家专攻"记忆 + 持续学习"的新实验室)两位联创 Dan Biderman(神经科学/架构出身)和 Jessy Lin(应用/持续学习出身)的核心主张:瓶颈已经不是"模型不够聪明",而是"模型不懂你这套新的、不断变化的上下文"。
大多数企业 AI 项目死在「一上来就选模型」:先 demo、再上线、几周后没人知道 AI 在干嘛——根因是缺了可观测性、评估、治理这三道关,钱和精力全打水漂。
MiniMax 创始人兼 CEO 闫俊杰(IO)罕见公开露面,定调公司打法:拿「token 消耗量」当唯一的客观尺子——M2 顶着争议只押注「写代码 + Agent」、放弃刷 Arena 排行榜,结果日消耗从目标的「1 万亿」冲到「10 万亿」(超目标 10 倍);下一步是连追两代,先把 3T(3 万亿参数)模型做扎实,再上 10T(10 万亿参数)模型。
FDE(Forward Deployment Engineer,前线部署工程师)是 2026 年硅谷最火的新工种——跟客户贴身把 AI 真正落地、再把一线教训反哺产品,本质是行业承认了"模型不等于产品,落地才是大头"。OpenAI 为此成立"部署公司"、收购 Tomorrow 打包带走 150 个 FDE,Anthropic 则和 Blackstone 等金融机构组合资企业,都在抢这件事。
Boris Cherny(Claude Code 的创造者)公开说"编程已被解决"——对他自己已经是 100% 的代码都由模型写、一天最多提过 150 个 PR;但他坦白这只在"一半"的场景成立,大而复杂的代码库、冷门语言模型还不擅长,"通常的答案就是等下一个模型"。
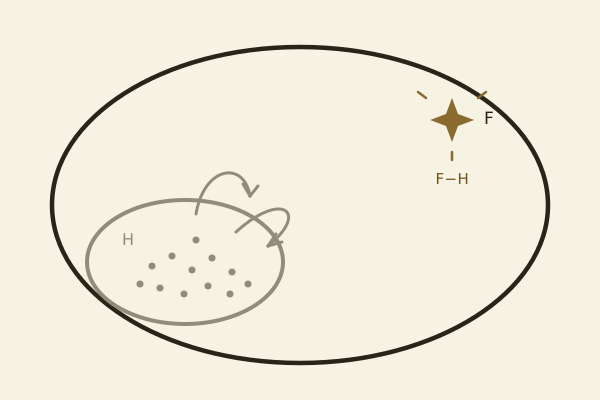
这是一场 YC 办的 AI 研究 meetup(线下小聚),组织者 François 开场抛出他认定的「AI 还剩两大未解问题」——intelligence per sample(每个样本能榨出多少智能)和 intelligence per watt(每瓦电能榨出多少智能)——再用一张「AlphaGo(被人类棋谱偏置、东游西荡)vs AlphaZero(不被人类偏置、纯自博弈)」的对比图框定全场基调;他的核心断言是:只在人类生成的数据子空间 H 上训练,无论投入多少可行量级的算力,都没法采样到完整解空间 F 里那块「人类没碰过」的 F−H,所以真正通往更强智能要靠 self-play、形式化验证这类「能自己造监督信号、自己去采样 F−H」的方法。
一个人靠自建的十来个 Claude Code skill(build / learnings / but for real 等)+ Conductor,把研究、设计、编码、营销、客服全流水线化,从而同时并行做 5 款以上 AI 产品。 Josh Pigford 卖掉商业分析公司 Baremetrics 套现 400 万美元后,不再聚焦一件事,而是当连续独立开发者(solo founder,没有团队、一个人从头干到尾)。他的核心是一个开源的 build skill,把每个功能按"研究 → 实现 → 分阶段 PR"拆成可单独验证的小块;这里的 skill 你可以理解成"喂给 AI 的一套固定操作手册 + 指令模板",让 AI 每次都按同样的高标准流程做事,而不是临场发挥。
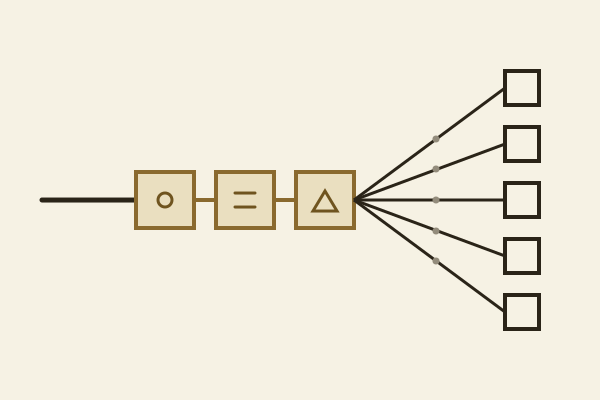
这期对谈解决一个「凡尔赛烦恼」:私人助理(chief of staff,帮你打理日常杂务的「办公室主任」式角色)该用 OpenClaw 还是 Claude Code 来搭。嘉宾 Moritz Kremb 干脆照着 OpenClaw 的架构在 Claude Code 里整套复刻了一份个人操作系统,取名 Claudia:核心是一个叫 cloud.md 的文件——相当于 OpenClaw 那边的 agents.md,是每次对话第一个被读取的「主指令」(相当于给 AI 的开机说明书 / system prompt),再由它把 user.md(关于他本人)、identity 与 soul(性格设定)、tools.md(工具清单)、memory.md(记忆)等文件一并拉进每次会话。所有内容放在 Google Drive 而非本地空文件,理由很朴素:云端存着,手机上随时能看。
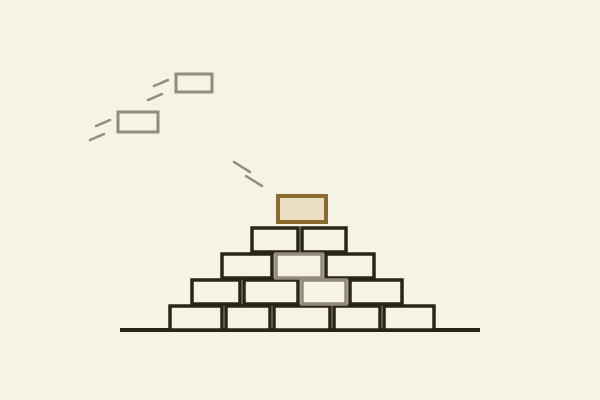
正因为 AI 让东西太好做,「想得透」才成了真正稀缺的差异化。 Tony 的原话:「正因为东西太好做了,真正能脱颖而出的,恰恰是那些经过深思熟虑、想得特别透的东西。」(the things that stand out are the things that are really well thought through)你今天写个 prompt「啪」一下就生成出来,可那是「建在一个特别糟糕、特别脆的地基上」,拿到的是「短期的爽快,换来的是长得多的长期损失」(short-term game for very very long-term loss)。真正脱颖而出的,是那些像奢侈品一样被精心打造、经得起反复使用的东西。
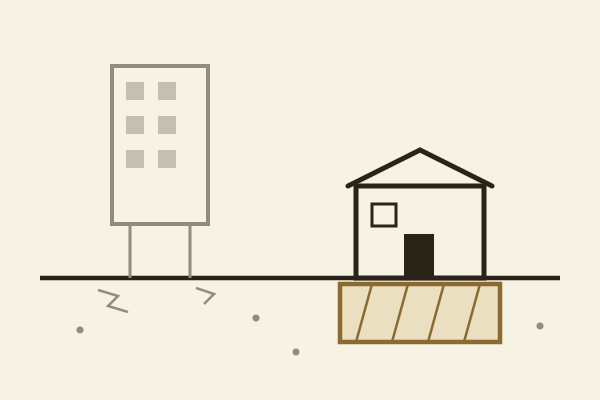
Anthropic 设计负责人 Jenny Wen 现在「除了细枝末节的生产代码」之外,几乎所有工作都用 Cowork——她把它定位成「垃圾进、珍宝出(garbage in, treasure out)」:擅长把 UXR 访谈、社交媒体(X、Reddit)、内部 Slack 反馈频道等大量杂乱来源挑出精华,再用并行任务把「多来源汇集洞察 → 反推功能清单(P0/P1) → 生成可分享演示文稿 → 设为每周一早 10 点定时任务并经 Slack MCP 自动分发」一条龙跑通,把「反馈到看得见摸得着的产出」之间的迭代循环压到极紧。
AI 时代真正变难的不是「动手建」而是「想清楚该砍什么」。 嘉宾原话:「今天的 model 很擅长往产品里加功能,但不太擅长判断该砍掉什么」——而「该砍什么」的直觉只能靠大量真实世界使用慢慢磨。Claude 能在几小时内把产品从零做到头(zero to end,不是 zero to one),但它一路替你拍了一大堆板。
builder PM 不是"配好 Claude Code/OpenClaw 就成",而是能跟客户聊、搞清该造什么、亲手把第一版造出来、做到 10 个客户全程不找开发者的人——原话:"builder PM 就是能跟客户聊、搞清该造什么、把第一个版本造出来、做到 10 个客户,全程根本不用跟任何一个开发者说一句话(without talking to any developer at all)的人"。以前写 PRD→出 mock→可跑原型→拉客户看信号要 2-3 个月,如今被 Claude Code 整体压缩。
一位谷歌 PM(Gabor Meer)用 Claude Code 把「一整家软件公司」复刻成一队专门化 agent——系统分析师、CTO、设计、品牌、实现、性能、可维护性、测试、UX 流程等十几个角色,由 system analyst agent(系统分析师 agent,相当于把需求翻译成开发任务的中间人)作中枢调度,真正做开发冲刺时 峰值 7-8 个 agent 并行,全程零真人员工。他的原话是:「我设置这些 agent 的方式,就是按照我在真实世界里跟一支软件工程团队协作时会想象的样子来配置的。」
企业跟不上 AI,根因不是技术不行而是「集成(integration,把彼此孤立的旧系统、旧数据打通对接)」过不去——这是 Aaron 全场的「主旋律」,他用几乎一字不差的同一句话开场和收尾:任何「超过 1000 人、或成立超过 10 年的企业」都堆着「一大坨东西在那儿等着被集成(a massive stuff that's sitting there waiting to be integrated)」,而「AI 其实根本帮不上集成的忙(AI actually doesn't help to integrate anything)」——agent 解决不了、什么都解决不了,这才是真正的墙。Gilfoyle 那种「我只写代码、别烦我」的硅谷工程师典型,到了企业「只会在集成这一关撞墙」。
Block 在 2025 年初执行了一次略超 40% 的裁员,刀口绝大部分落在开发侧(销售/客户管理几乎没动),背后是 Owen 口中"12 月第一周"那个非黑即白的拐点——Opus 4.6 与 Codex 5.3 让 AI 从"擅长写新代码"变成"能驾驭已有复杂代码库",人数与产出几十年的相关性就此断裂。
软件在底层 70 年没怎么变,最近几年却接连变了两次:从 Software 1.0(人手写的代码)→ 2.0(用数据"训"出来的神经网络权重)→ 3.0(直接用英语写 prompt 去指挥大模型 LLM)。Karpathy 自己的原话是"软件在这么底层的层面上,已经七十年没怎么变过了,然后在过去这几年里,它差不多以非常快的速度变了两次"。这件事的分量在于:世界上现存的海量软件——他用一张 "map of GitHub"(把人类写过的所有代码画成一张星图)来让你直观感受这片版图有多大——现在都面临被重写、重做。对刚要入行的学生来说,这是天大的机会窗口("有海量的活要干——海量的软件要写、要重写"),但前提是你三种"写法"都得会,而且要能根据任务在它们之间流畅地来回切换,因为"它们各有各的小优缺点",没有哪一种永远最优。
YC 自己就是最大的"AI-native 改造"样本。 嘉宾 Pete Koomen(Optimizely 创始人)一年多前从财务团队起步,搭出了一整套 YC 内部 agent 基建:一个跑在单一 Postgres 上的 agent loop + 从 20 个长到 350+ 个的 tool registry。本质上是把"工程师把财务口述的复杂工作流写成确定性软件再交回"的旧循环,换成"业务自己用英语/prompt 编排 agent"——把工程师从这个"疯狂循环"里彻底解放出来。Pete 原话:他在自己电脑上用 agentic 编码工具"感觉像有了超能力(superpowers)",而看着公司里老派的写软件方式,"两者之间的鸿沟越来越大"。
三位「自造工厂、不拼现成件」的创始人——Vercel 的 Guillermo Rauch、Boom 的 Blake Scholl、Science Corp 的 Max Hodak——与 Naval 圆桌。贯穿全场的隐喻:工程师从「交付产出 B」变成「搭建批量产出 B→Z 的工厂」;10 倍工程师在 AI 杠杆下已升级为 100/1000 倍(Satoshi、Brendan Eich、Carmack),衡量标准从代码行数/token 转向「别盯 token,只看你的时间 + 最终产出」。
瓶颈已经转移,旧流程会"悄无声息地不再奏效"(quietly stops working)——当编码(写代码)不再是瓶颈,从规划、评审到组织形态的所有团队规范(team norms,团队内部约定俗成的做事规矩)都得拿出成长型心态(growth mindset,相信能力可以持续成长、旧办法该被新办法替代的心态)重写一遍。 这不是行业第一次换瓶颈:21 世纪初"云"还不存在、一次只能合并 6 个 PR 时,瓶颈是构建队列;云和持续构建来了瓶颈就移走了。如今在 Claude Code 团队,"编码真的已经不是慢的那部分了",所以上下游流程都得改。
eval 是一切 prompt 工程的起点:prompt(提示词,就是你写给 AI 的那段指令)改一处到底有没有真的让效果变好,不能凭感觉,必须先有一套 eval(evaluation,自动化评测套件,相当于给 prompt 写的"单元测试")来提供严谨性。这套 eval 至少要覆盖三类情况——对照用例 / 边缘用例 / 能力边界(该转人工还是该直接拒答)。否则当你迁移到新模型、表现变差时,你根本分不清是"新模型能力不够、再调也救不回来",还是"新模型有能力、只是行为变了、调 prompt 就能纠正"这两种本质不同的情况。讲者原话:「我们需要 eval 来提供那种严谨性,好让我们搞清楚:对 prompt 做的某个改动,是不是真的对应着性能的提升。」
模型越强,越要克制约束它:照搬 Richard Sutton 的「苦涩的教训」(the bitter lesson,指机器学习史上一再重演的规律——靠堆数据和算力的通用方法,长期总能打败人手工塞进去的「聪明规则」)——讲者原话是「往里灌入更多的数据、更多的算力,最终得到的能力会超过你能想出来的任何方案」,所以与其用人类智慧提前把系统硬编码、定死需求,不如承认「模型从你身上提取需求的能力,很可能比你自己定义需求的能力还强」,让 Claude 反过来用 ask_user_question 工具一轮一轮地采访你(interview),把潜藏在你脑子里、你自己都说不清的需求挖出来。
今天的 agent 是相互隔离的——一次只跑一个 session(会话,即 agent 的一次独立运行实例),互相不记得、也不传递信息,这在真实工作流里严重限制了实用性;Anthropic 在 Claude managed agents(Claude 托管智能体,简称 CMA) 平台上推出 memory store(记忆库)——一个类文件系统的持久化存储,挂载到 session 容器上,模型可以像操作真实文件夹一样用 bash、grep(关键词搜索命令)去读写——来解决跨会话记忆问题。Kevin 原话把它类比成人类:"就像人类一样,我们引入了 memory 这个概念。"
Eval(评估)是把"感觉(vibes)"翻译成"可行动信息"的那座桥——eval 就是"给 AI 出一套题、定一套打分规则,看它在你这个具体活儿上到底行不行"。各家模型厂商发布时都会甩一张通用 benchmark(公开标准考卷)成绩单:衡量 agent 写代码能力的 SWE-bench、流行的 Terminal-Bench、衡量工具使用与 agent 操作的 Tau-bench / OSWorld、衡量推理与知识的 ARC-AGI 2。但讲者反复强调:这些通用分数只告诉你"模型整体多强、比上一代提升多少",对你那个非常具体的 use case(使用场景)"通常说明不了太多"——因为它们根本没在衡量你正在做的那件事。所以口号是"build your own evals(构建你自己的 eval)":它逼你把"成功长什么样"说清楚,并验证你每一次改动究竟是改进(improvement)还是退化(regression)。
一个原本好用的 agent(agent=能自己理解任务、自主调用工具、多步完成目标的 AI 程序;这里是库存管理 agent「Stock Pilot」),因为上线后被持续硬塞新能力却不升级架构,system prompt(系统提示词)膨胀到约 400 行、挂了 12 个 tool(其中 3 个其实是对 subagent 的封装),导致「原本被它加速的环节反而出现倒退」、eval 分数下滑;解法是用 tool / skill / subagent 三种 agentic 原语(搭 agent 的三类最基础积木)把它重新拆解。
Naval 主持的多人圆桌,参与者有政策方向的 Max、一位航空/硬件创始人(多次被叫 Blake、要"把我们都搞成超音速 supersonic")、一位 医疗/生物科技专家。核心观点:AI 当下被严重低估的故事不是"写代码",而是"碾碎繁文缛节"——把一架飞机扛雷击的 200 页认证文档从几个月压到几分钟,让监管从拖累迭代的负担反过来变成一道可被快速通过的"测试套件(test suite)":把监管条文当成软件里"必须全部通过才算合格"的自动检查清单,agent 跑一遍就知道合规没合规。
AI 彻底改变了软硬件工程师的分工:软件工程师搭架构,硬件工程师 vibe code(凭手感让 AI 写代码、自己不必精通编程)自己那部分——Boom Supersonic 靠这套,把"光是分析一片涡轮叶片就要 1 个工程师整整 1 天、而一台发动机有上千片"的死活,变成"2 个工程师设计一整台喷气发动机、改一下叶片形状就能实时看到气动和结构结果"。
工程师的衡量标准正从「亲手交付成果」转向「有没有造出那座把产出成倍放大(B→Z)的工厂」——Guillermo 原话:"以前公司内部衡量的是『A 这个人产出 B 这个成果做得有多好』;现在我评判你这个工程师的方式变成了:你有没有在打造那个能产出 B 到 Z、能成倍放大产出的工厂?"在想法 / 智力 / 虚拟数字领域里,差距"根本不止 10 倍,而是 100 倍、1000 倍。一直都是这样"。
「自动化是个谎言,每个 agent 背后都需要一个人」——Dan Shipper(Every 联合创始人兼 CEO)是个自相矛盾的人:一方面「极度信仰 AI」(extremely AI pilled),另一方面又「特别看好人」(very bullish on humans)。证据就摆在公司账上:Every 过去一年从 15 人翻倍到近 30 人、还在招工程师,他用了这么多自动化、这么多 AI,结果「反而工作得多得多」(I also work way more)。他的判断是,所谓「AI 抢饭碗大灾难」(AI job apocalypse)根本不存在,而背后的底层道理是——每自动化一件事,就得有一个人在上面盯着确保它跑得对。
Bun 用一套叫 RoboBun 的自动化流水线接管 GitHub issue——每个 issue 一上报,机器人先自动复现、再自动提 PR(强制带测试,且同一个测试必须「在旧版 Bun 里失败、在调试分支里通过」才算数),随后让 Claude 代码审查与 CodeRabbit 两个 agent 在 PR 评论区来回拉锯、逐条标记「已解决」;如今打开 GitHub 的 Insights 看最近三个月的 main 分支,RoboBun 的贡献量已经超过作者 Jarred Sumner 本人——而且这还是在它的 PR 并未全部被合并的前提下。
Karpathy 自 2025 年 12 月起进入"AI 疯魔"(AI psychosis)状态:每天 16 小时"向 agent 表达意图"而非亲手写代码——他原话是"写代码这个动词都已经不准确了,我每天得花 16 小时把我的意图传达给我的 agent,让它显化(manifest)出来"。亲手写码比例从 80/20 翻转到 20/80,"而且现在都不止 20/80 了,比那个比例还要悬殊得多","我从 12 月开始基本上一行代码都没亲手敲过"。所谓 psychosis(疯魔),就是这事像无底洞一样无限,做不成永远归结为"是你自己技术不到位(skill issue)"。
2025 年 12 月是 Karpathy 的明确转折点:此前他用 agentic 工具已一年,"它擅长生成一段段代码,有时出错你得手动改,但总体还算有帮助";12 月他在休假、时间更多,突然发现最新模型生成的代码"就是没问题(the chunks just came out fine)",不断追加需求也没问题,"想不起上次纠正它是什么时候了",于是越来越信任系统、一头扎进 vibe coding。这种又兴奋又不安的混合感,让他作为程序员"从未感觉如此落后"。
AI 时代真正稀缺的不是技能而是「能动性(agency)」。 过去你可以拿「我缺某项技能(skill issue)」当永远的挡箭牌;现在 LLM 把各种技能放在指尖(你身边有个「接近 AGI 的模型」在帮你),分水岭就变成了「你是否意识到周遭世界是由一群不比你聪明的人造出来的、因此是可被改变的」。Max 原话:「就算你随手就能调用各种技能,真正起决定作用的是能动性,而我不觉得它在世界上分布得很均匀。」培养它的唯一正道是「动手做东西(make things)」——不是去想着怎么绕过坏老板。
Naval 不相信"销售"这回事,他说人类天生抗拒被推销("如果你感觉自己正在被卖,那是一种倒胃口的体验"),比任何销售技巧重要得多的是可信度(credibility)——你必须真诚、说真话、有真才实学,并能站在对方角度把复杂的事打比方讲清楚,因为人生中你最想打动的那些"顶尖中的顶尖"恰恰是能一眼看穿所有套路的人。
这是 Naval 播客的"大杂烩"(popuri,无固定主题)一期,Nivi 提问、Naval 主讲,围绕"组织怎么搭、AI 在公司里到底有没有用、AI 格局会怎么演化、暴力的底层逻辑在变、以及为什么还应该乐观"展开。Naval 一上来就否掉"围绕 AI 重组公司"那套(点名 Jack Dorsey 重组了 Square、Shopify 的 Toby 也在试),坦白"我从来不擅长也讨厌组织管理,因为我讨厌组织、讨厌大群体";他现在的公司 Impossible 走"完全互联图 + 轻量中心辐射",连 Slack 和项目管理软件都不用、只有 GitHub,只雇能在这种结构里独立运作的"高智能节点"。AI 在这里不是显式沟通工具,而是隐性"力量倍增器"。
招聘是创始人唯一不能外包的四件事之一(与融资、战略、产品愿景并列):本期 Nivi 主持、Naval 主讲。开场引 Vinod Khosla"你打造的团队就是你打造的公司",Nivi 补"他们说这是技术的游戏,其实是招聘的游戏"。三层原因:早期成员就是公司 DNA;顶尖的人只想和顶尖的人共事(和不如自己的人共事是一种"认知负担");创始人作为招聘者/人/贡献者的素质,是组织里任何人的素质上限——"你永远没法雇到比你更强的人"。
AI 重构了软件分工:氛围编程(vibe coding,不写代码、直接用大白话向 AI 描述需求来"造软件")成了新的产品管理,训练调优模型成了新的编程;但传统软件工程师因为"用代码思考、能堵住有漏洞的抽象(leaky abstraction,任何封装好的工具底层细节都会漏出来咬你一口)"反而成为地球上杠杆最大的一批人——AI 替你写的代码会犯错、有 bug、架构次优,能看懂底层的人才补得上窟窿。
从八小时装机删日历,到三台电脑九个 Agent——Claire 从最大怀疑者变成"屏息的信徒":第一次安装她"真的花了整整八小时"才让 OpenClaw 跑起来,回报是"我的个人家庭日历被删了"。但就在它没删日历的时候,"它带给我足够的快乐和足够的实用性,让我知道这里面有东西"。她把这形容成"一种真正丑陋、明显的 product-market fit(产品市场契合)的感觉"——产品很糙,但你一眼看出它戳中了真需求。她现在自称"a breathless OpenClaw bro(屏息的 OpenClaw 兄弟)",在三台电脑上跑着九个 Agent,并说这是自 ChatGPT 以来她最震撼的 AI 体验。
Anthropic 正在用 AI 自动化它自己的增长:14 个月内 ARR 从 10 亿涨到 190 亿(这还是二月底的过时数字),且是在"历史上规模最小、资金最少"的处境下做到的——没有 Meta/Google 的现金流和分销,也没有 OpenAI 的先发优势。增长负责人 Amole 把大量工作交给 Cowork(Anthropic 桌面端 agent):每天扫 20-25 张图、每周用 Slack MCP 跨部门找"错位"、自动报销、清收件箱、甚至模拟经理 Army Vora 会给的反馈。这是"吃自己狗粮(dogfooding)"做到极致的活样本。
PM 角色正在根本性转变:嘉宾 Nikhyl Singhal(Meta、Google 前资深高管,Credit Karma 前 CPO,四次创业者,顶级产品负责人社区 Skip 创办人)定调——「信息传递者(information mover)本质上会变成恐龙」。未来 12-24 个月公司会先大规模裁员、再大规模重招,量级是「裁 30,000、招 8,000」,新招的 8,000 人 100% 是 AI-first。
Anthropic 把 PM 重塑成两件事:消除一切发布障碍 + 定义一个月后的产品长什么样。功能从想法到上线的时间线压到 6 个月→1 个月→1 周乃至 1 天;几乎所有 PM 都工程出身;research preview(明确标注"早期实验、可能不会永远支持"的发布姿势)是默认上线方式,用来把承诺成本压到最低;工程师内部 dogfood 满意后把功能贴进常驻的 evergreen launch room,文档/PMM/DevRel 第二天就能出营销公告。
产品愿景之所以重要只有两件事:让自己坚定——相信自己在做的、将要做的事情;让别人坚定——别人认同、相信并追随你。