← 主页 NO.245
专栏 · Agent 工程手艺 › 第 245 期 · AGENT 工程 · 收录于 2026 年 9 月 28 日
Jev-Mem:面向高效 AI 智能体、由系统一控制的智能体记忆——德州大学达拉斯分校
TL;DR · 三句话
- 一这篇论文把 agent 记忆里那些高频、答案只是「一个标签 / 概率 / 分数」的决定——给记忆打类型、判关系、路由查询、给候选打分、决定何时停——统统交给 TypeSafe AI 的类型化决策模型 Jev(不生成文字、直接返回概率,就是 ep229 讲的那个模型)当「系统一」,大模型(系统二,实验里是 gpt-4o-mini)只在最后综合作答时出场;论文强调真正的新意是这种「轻量控制 / 深思推理」的架构分离,Jev 只是它的一种实现。→ 详细
- 二在 LoCoMo 长对话记忆基准上,Jev-Mem 的 LLM 裁判总分 0.777,比最强基线 MAGMA 的 0.700 相对高 11.0%,对抗类 0.962 遥遥领先,唯一没拿第一的是时间类(0.637 对 MAGMA 的 0.650);同时记忆构建只要 158 秒(最快的对手 Nemori 要 1,044 秒,快 6.6 倍),平均每次查询 0.93 秒(比 MAGMA 的 1.47 秒低 36.7%)。→ 详细
- 三最值得抄的是附录 B 那套类型化提示词:入口不丢任何观测,找候选用确定性检索、判关系才叫 Jev(≥ 0.60 才建边);检索前先问「要不要时间线、要不要因果」再按需分预算,每轮分开问「证据够了吗(≥ 0.95)」和「再查还有用吗(< 0.15 就停)」,外加深度 8、Jev 16 次、15 秒等硬上限。读数字时要记住:只报了一个基准、正文和表 1 有几处对不上、Jev 的分数不是校准过的概率、论文未说明作者与 TypeSafe AI 的关系。→ 详细
01
Jev 是什么:TypeSafe AI 的「类型化决策模型」,这篇论文把它装进 agent 记忆当「系统一控制器」
- 出处:arXiv 预印本,作者是 UT Dallas(德州大学达拉斯分校)计算机科学系的 Dongming Jiang、Yi Li 和通讯作者 Bingzhe Li;代码已在 GitHub 公开。→ 详细
- Jev 本身:论文引用的是「Jev TypeSafe AI (2026)」——TypeSafe AI 公司的商用模型,卖点是不做自回归生成(autoregressive:像 ChatGPT 那样一个 token 一个 token 往外吐字),直接产出「类型化的概率决策」:你问的是一道有固定选项的题,它还你的是数,不是一段话。论文认为正是它让「快决策 / 慢推理」的拆分在工程上变得可行。库里 ep229(Ryan Vogel 讲 Jev 怎么用:邮件分拣、约 200 毫秒一次决策)讲的就是同一个模型的产品形态,这篇可以看成把它用在 agent 记忆上的学术版(见 ep229)。→ 详细
- 调用长什么样(附录 B.1):Jev-Mem 通过
TypeSafeClient.system_one一次提交一个共享的state(结构化状态)加一批questions。布尔型的题叫 Noul——用一条指令加明确的「真 / 假」判据定义一个是非命题,返回 0 到 1 之间的值,多个 Noul 各自独立判断(一条记忆可以同时是「情景型」又是「语义型」);互斥的多选一叫 Choice,返回选中的标签和各选项的分布。同一批里的题互不引用彼此的答案,所以每条指令都要自己写明用到了 state 里哪些字段。→ 详细 - 两层要分开看:论文自己强调,Jev 只是「为系统一控制器提供了一种具体实现」,Jev-Mem 的关键创新在于架构层面的分离:在记忆构建和检索两头,都把轻量的记忆控制与审慎推理拆开。所以读这篇要分两层——一层是这套分工思路(言下之意,系统一的位置不绑死 Jev),一层是 Jev 这个具体产品在这里跑出了什么数。→ 详细
02
问题:记忆越丰富,「管记忆」本身就越贵
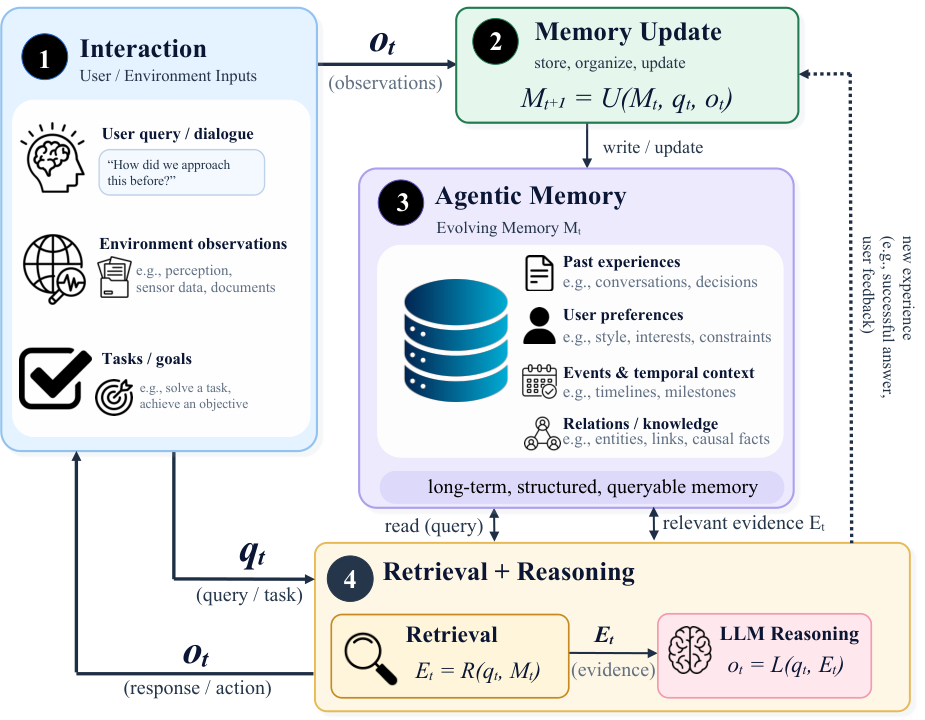 ▲ 图注:论文图 1「智能体记忆的工作流」。① 交互:用户提问、环境观测、任务目标;② 记忆更新:把观测存下、组织、更新;③ 不断演化的智能体记忆:过往经验、用户偏好、事件与时间脉络、关系与知识;④ 检索 + 推理:先按查询检索出证据,再交给 LLM 推理出回应或动作;成功的回答、用户反馈等新经验再沿虚线回流去更新记忆。
- 为什么要外挂记忆:LLM agent(智能体:能自己多步调用工具、把事办完的 AI)越来越被当成常驻系统长期运行,攒下的偏好、任务历史、环境知识很快撑爆上下文窗口(模型一次能「看见」的文字上限);单纯加长窗口也不管用,模型并不能可靠地利用长输入里的每个位置。→ 详细
- 代价出在「谁来做决定」:记忆已从「存下对话、按相似度捞回」演进到有选择地保留、整合、分层存储、存程序性记忆(可复用的技能与工作流),再到用知识图谱按语义 / 时间 / 因果 / 实体关系检索。越丰富越难管:存什么、连什么、查什么、何时停,固定启发式规则高效但死板,通用自回归 LLM 灵活但每个决定都要重新生成 token——于是「记忆控制本身就可能成为延迟与推理开销的主要来源」。→ 详细
- 被忽视的系统问题:图 1 的循环是「检索证据 → 大模型作答 → 回写更新记忆」,两头都塞满了语义判断,记忆「越来越像一个动态子系统」。论文于是问:「应当由何种计算机制来执行这些记忆管理决策」?自适应 RAG(检索增强生成:答题前先去资料库捞材料)已把检索看成「受控的决策过程,而非固定的 top-k 操作」(top-k:只取最相似的前 k 条),但它面对的语料是固定的;agent 记忆的库由 agent 自己的交互历史写成、要不断维护重组,Jev-Mem 把同一原则推广到整个记忆生命周期,并把这层控制写成架构里显式的一层。→ 详细
03
关键观察:很多记忆操作 "semantic but not generative"——要的是判断,不是作文
- 核心洞察:论文的出发点是一句话——许多记忆控制操作「是语义性的,而非生成性的」。构建时要给一条记忆分类、推断它和已有信息的关系;检索时要路由查询、给候选打分、决定何时停。这些决定的输出都是有界的:一个标签、一个概率或一个分数,而不是一段自由文本。→ 详细
- 用大模型做这种题不划算:拿自回归 LLM 做这类高频决策「不必要地昂贵」——再简单的判断也要逐 token 生成、排版格式、再解析回程序;这些操作又反复出现在记忆的关键路径(critical path:每次读写都必须经过、直接决定快慢的那条路)上,开销会迅速累积。打个比方:让一位资深律师来给每封来信贴「急 / 不急」标签,他当然贴得对,但每贴一张都要先写一段说明再签字。→ 详细
- 同一条系统原则的更细粒度版:成本感知推理早就表明「不同请求无需获得同等的模型计算量」——级联与路由(cascading / routing)把请求按难易分给贵贱不同的模型,推测解码(speculative decoding)让小模型先起草 token、大模型只做验证。Jev-Mem 把这条原则用得更细:不只在模型之间分派整条用户请求,而是把频繁、有界的记忆控制决策从开放式生成和深思推理里剥出来,前者交给轻量的结构化预测,系统二(慢而深的推理,本文里就是大模型)只留给复杂推理与答案综合。→ 详细
- 三个待答问题与四点贡献:论文要回答——系统一该如何融入记忆的整个生命周期?能力较弱的推理器怎样控制记忆而不拖累下游准确率?什么样的记忆结构与检索流程最适合轻量控制?自报贡献四条:发现用系统一式轻量决策提升记忆效率的机会;提出把轻量控制与昂贵生成推理分开的 Jev-Mem;做出同时管构建与检索的统一系统一控制平面(多关系组织、查询路由、自适应图遍历、候选打分、停止判定);在最先进基线里同时拿到最佳总体准确率和最高效率。→ 详细
04
三层架构:系统一控制平面 + 多关系记忆平面 + 系统二推理平面
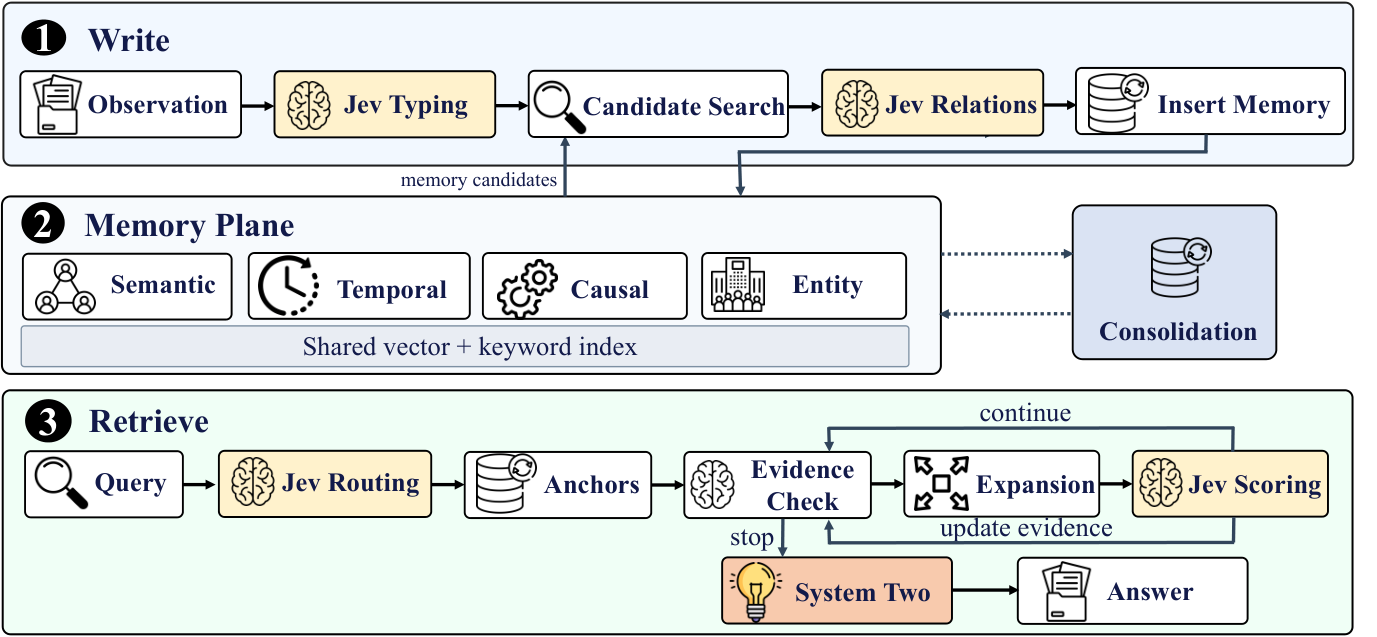 ▲ 图注:论文图 2「Jev-Mem 概览」。❶ 写入:观测 → Jev 打类型 → 候选搜索 → Jev 判关系 → 插入记忆;❷ 记忆平面:语义、时间、因果、实体四张视图,底下共享一套向量 + 关键词索引,右侧挂着整合;❸ 检索:查询 → Jev 路由 → 锚点 → 证据检查 → 扩展 → Jev 打分,再回到证据检查循环,检查通过才停下交给系统二生成答案。四个标着 Jev 的步骤用浅黄色框标出。
- 三个组件各管一摊(图 2):系统一控制器在写入和检索全程做轻量的结构化决策;共享的记忆数据平面保存规范观测(canonical observation:原样保存的那条原始记录,一条观测只存一个正本)及其语义、时间、因果、实体四类关系;系统二只负责答案综合,以及其他需要开放式生成或更深推理的操作。→ 详细
- 记忆的数据结构:每条观测 = 内容 + 可选时间戳 + 来源(provenance);整个记忆 = 一批规范节点 + 语义 / 时间 / 因果 / 实体四种边 + 向量索引与词法索引(lexical:按字面关键词匹配)两个入口。四张「关系视图」共享同一批节点,同一对记忆之间可以同时连好几种边。→ 详细
- 控制器接口 J(S, Q):S 是结构化状态,Q 是一批显式的决策问题;它要么给彼此独立的命题各出一个概率(两条记忆是否语义相关、候选是否与查询相关、证据是否已经足够),要么在互斥选项里出一个分布(比如两件事的时间先后选哪种)。它刻意不同于自由形式的提示词:每个决定只暴露一个小而已知的输出空间,直接用概率表示控制,不必先生成一段自然语言推理再解析;共享同一状态的多个决定还能一次批量调用。→ 详细
- 同一套控制贯穿写与读:写路径上打类型、挑候选、建关系,读路径上路由、分预算、查证据够不够、扩展与打分,全走同一个系统一决策抽象——记忆「并非由一套启发式规则构建、再由另一套启发式规则检索」,而是用「单一的自适应记忆管理架构」取代「一系列彼此孤立的启发式规则和反复的 LLM 调用」。→ 详细
05
写路径:入口先原样全留,「找候选」和「判关系」分两步,能用规则就不叫模型
- 不在入口做不可逆的取舍:每条有效观测都建一个规范节点。当前设计选择保留观测,而不是在摄入时就做一个「基于学习且不可逆的『存储或丢弃』决策」——起初看着不重要的信息,可能要等将来某个查询才显出价值,入口丢了就永远找不回来。选择性被挪到了后面两处:建结构的时候,和检索的时候。→ 详细
- 类型是打分,不是分箱:控制器先给每条记忆预测四个可以重叠的特征分——情景型(episodic:某时某地发生的具体事)、语义型(semantic:一般性事实)、程序型(procedural:怎么做某事)、偏好型(preference:用户喜欢什么)。这些分数只是贴在节点上的标注,不把它塞进某个互斥类别;节点里存着原始观测、来源、时间戳、嵌入向量、实体和类型分。→ 详细
- 「找候选」与「判关系」分开:新观测要和越来越大的记忆建立联系,若挨个比对所有旧节点,控制器成本会跟着记忆规模一路上涨。所以先用确定性检索(不调模型、按固定公式算分)综合向量相似度、词面重叠、共享实体和时间邻近,挑出至多 K_w 个候选,系统一只评估这些候选对。→ 详细
- 能用规则就不叫模型:对每一对,Jev 估计语义相关、有方向的因果影响、是否同属一个情景,必要时再判断是不是同一实体;但只要已有可靠的结构化信息就跳过学习式推断——时间戳先后直接生成时间边,完全一致的共享标识符直接生成实体边。只有时间顺序是隐含的,控制器才在 before / after / during / contains / overlaps / same_time / unknown 七个选项里选一个。推断出的边,概率达到阈值 θ_rel 才插入。→ 详细
- 多视图而非多副本:同一对节点可以同时有语义、时间、因果、实体四种关系——既不是把每条记忆只归到一张图里,也不是把同一观测复制进几个库。写路径一句话:观测 → 打类型 → 找候选 → 建关系 → 入库。好处有两条:保留原件,避免信息过早丢失;有选择地建边,压住没必要的图连通(边太多,检索时处处是岔路),同时留下日后撑得起语义、时间、因果、实体推理的关系。→ 详细
- 定期维护不删原件,生成只是可选后果:周期性维护在一个有界邻域里检查冗余、矛盾、过时,以及值得补上的链接,只丰富结构、不删原始证据;需要更高层的文本抽象(比如把几条合成一条概括)时,控制平面才把批准过的合并或提升(promotion)显式交给系统二——「生成只是结构化控制决策的一种可选结果,而非记忆维护的默认机制」。→ 详细
06
读路径(上):检索是闭环控制——先判「该走哪几张图」,按需分预算,再定走多深
- 先路由,而且可以几路并行:拿到一个查询,控制器先对四张关系视图各自预测相关度(这题需不需要语义 / 时间 / 因果 / 实体线索),同时预测「要不要多跳」(多跳:得把两三条记忆串起来才答得出)和「新近性有多重要」。这些概率各自独立评估,所以一个查询可以同时激活好几张图,而不是被硬归进某一个检索意图;相关度达到阈值 θ_act 的图才激活。→ 详细
- 按需分预算、按需定深度:给定总的图扩展预算 B,先给每张激活的图保一个最低额度 m,剩下的按预测相关度成比例分(参数 γ 控制分得有多集中);多跳预测再决定允许走多深——越像多跳题,允许的遍历深度越接近上限 D_max,最少走 1 层。论文说这套概率路由有两重作用:不在不太可能帮上忙的关系上平均撒力气;问题确实需要时,又能同时探索多种证据。→ 详细
- 混合锚点当起点:图遍历之前,先用向量(语义)和关键词(词法)两路检索找入口,两份排名用倒数排名融合合并(RRF:每条结果在各榜单上按「1 /(60 + 名次)」记分再相加,两边都靠前的胜出,κ = 60),排名最高的节点作为出发点——在控制器开始代价更高的图推理之前,先给它一个稳健的起点。→ 详细
- 每轮都问一遍「够了吗」:每轮检索后,控制器不是盲目跑到固定深度或节点数,而是估计四个量——证据是否充分、继续检索的预期收益、是否还缺必要证据、是否有没解决的矛盾。停法有两种:证据充分(充分度达到 θ_suff,且「缺证据」和「矛盾」都低于 θ_cont);或者继续检索的收益已低于 θ_cont——证据还不完全够,但再走下去也不太可能改善。→ 详细
- 为什么停止判定这么要紧:「停止得过早可能会遗漏必要的证据,而不加控制的扩展则会引入无关记忆,干扰下游推理」——所以 Jev-Mem 把证据完整度和继续搜索的预期收益都显式建模,而不是拍一个固定的 top-k。→ 详细
07
读路径(下):四维打分 + 束搜索回路,系统二只在最后出场,控制开销有硬上限
- 候选怎么打分:需要更多证据时,在各关系的预算以及节点数、边数、深度、控制器调用次数、延迟的全局上限内扩展邻居;系统一从四个互补维度评估每个候选——与查询的相关性、经由的这条关系有没有用、信息新不新、对当前证据的支持度;再和确定性信号(嵌入相似度、存储的边权重)加权合成一个转移分。有时间戳时,还按这个查询对新近性的需求给更近的记忆加分(按天衰减)。→ 详细
- 迭代回路:每轮取分数最高的 W 个候选作为下一轮的「束」(beam:每轮只保留最有希望的几条路往下走)并加入累积证据,循环是「路由 → 检索 → 评估 → 扩展 → 再评估」。它和固定 top-k 或静态图遍历根本不同:走哪几张图、力气怎么分、每轮留谁、要不要继续,全取决于查询本身和已收集的证据——「检索本身成为了一个由系统一控制的决策过程」。→ 详细
- 系统二只做最后一步:检索终止后,得分最高的 K 条记忆交给系统二 LLM 做最终综合,它不参与常规的图路由、候选扩展或停止决策——把昂贵的自回归推理「集中用在最能发挥价值之处」,同时用快速的结构化控制提升喂给它的证据质量。→ 详细
- 控制开销有明确上界:一次常规写入只要一次批量类型标注请求,有候选时再加一次覆盖至多 K_w 个记忆对的批量关系请求;一次查询要一次路由请求,每轮检索至多一次证据评估加一次批量候选打分。图扩展次数、检查的边数、访问节点数、深度、控制器调用次数和耗时各有独立上限,防止「控制过程本身无限膨胀」。→ 详细
08
实验设置:LoCoMo 一个基准、五个对手,作答统一用 gpt-4o-mini
- 考什么:实验从两头评——推理有效性(系统一控制的记忆构建与检索能不能提升长程问答)和系统效率(把快速记忆控制与系统二分开,能不能降低建记忆、查记忆的开销)。→ 详细
- 考题:LoCoMo(Maharana et al., 2024)——超长的多会话对话,考 agent 能不能找回那些需要时间推理、因果推理、跨会话推理才拿得到的信息。原文写「在两个广泛使用的基准上评估」,但只描述、只报告了 LoCoMo 一个(原文如此)。→ 详细
- 五个基线(baseline:拿来对比的参照系统,适用时都用同一个作答模型):Full Context(不用外部记忆,把完整对话历史直接塞给 LLM);A-MEM(按 agent 的经验动态组织、演化记忆);Nemori(情景分段 + 基于图的检索);MemoryOS(层级化的多级架构管持久记忆);MAGMA(用语义、时间、因果、实体多种关系表示记忆做结构化检索,四种关系和 Jev-Mem 的记忆平面是同一套)。→ 详细
- 指标:准确性用 LLM 裁判评分(LLM-as-a-Judge:让另一个大模型对照参考答案判生成的答案对不对);效率看两项——记忆构建总时间(把整段对话历史建成持久记忆的端到端耗时)和平均单次查询延迟(每个问题检索证据并作答的平均耗时)。表 1 注明「所用 LLM 基于 gpt-4o-mini」,即 Jev-Mem 里负责作答的系统二。→ 详细
09
准确率:总分 0.777,比最强基线 MAGMA 的 0.700 相对高 11.0%;时间类是唯一没拿第一的分项
表 1(LoCoMo,LLM 裁判评分,越高越好,作答模型基于 gpt-4o-mini;粗体照原表):
| 方法 | 多跳 | 时间 | 开放域 | 单跳 | 对抗 | 总体 |
|---|---|---|---|---|---|---|
| Full Context | 0.468 | 0.562 | 0.486 | 0.630 | 0.205 | 0.481 |
| A-MEM | 0.495 | 0.474 | 0.385 | 0.653 | 0.616 | 0.580 |
| MemoryOS | 0.552 | 0.422 | 0.504 | 0.674 | 0.428 | 0.553 |
| Nemori | 0.569 | 0.649 | 0.485 | 0.764 | 0.325 | 0.590 |
| MAGMA | 0.528 | 0.650 | 0.517 | 0.776 | 0.742 | 0.700 |
| Jev-Mem | 0.623 | 0.637 | 0.618 | 0.802 | 0.962 | 0.777 |
- 总分与分项:Jev-Mem 总分 0.777,最强基线 MAGMA 0.700,相对提升 11.0%;按表,它在多跳(0.623 对 Nemori 0.569)、开放域(0.618 对 MAGMA 0.517)、单跳(0.802 对 MAGMA 0.776)、对抗四个分项和总体上都是第一。→ 详细
- 差距最大在对抗类:0.962 对最强基线 MAGMA 的 0.742,其余几家都在 0.62 以下。论文的解释是,提升最大的正是那些要综合多条记忆的证据、或要把相关信息和「看似合理却具有误导性的干扰项」区分开的题。→ 详细
- 唯一没拿第一的是时间类:表里 MAGMA 0.650 最高,Jev-Mem 是 0.637(Nemori 的 0.649 也略高于它)。第 4.2 节正文却写成「与最佳的时间类得分 0.650 持平」,几个分项数字也和表对不上,集中放在第十五节「读这篇论文要记住的几条前提」交代,数字以表为准。→ 详细
- 长上下文替代不了记忆:把完整对话直接塞给模型的 Full Context 总分只有 0.481、对抗类只有 0.205,都是全表最低。→ 详细
- 论文的归因:提升来自自适应记忆控制——估计哪些关系视图对当前查询有用、据此分配检索力度、遍历时评估候选、判断证据何时够了;检索按每个查询的需要调整,不走固定搜索策略,推理模型拿到的是「更相关、更聚焦的证据集」,所以它不是只擅长某一种推理模式。→ 详细
10
效率:记忆构建 158 秒(最快的对手 Nemori 要 1,044 秒,快 6.6 倍),查询平均 0.93 秒(比 MAGMA 低 36.7%)
表 2(记忆构建总时间与平均查询延迟,单位秒;粗体照原表):
| 方法 | 构建时间(秒) | 延迟(秒) |
|---|---|---|
| Full Context | N/A | 1.74 |
| A-MEM | 3636 | 2.26 |
| MemoryOS | 3276 | 32.68 |
| Nemori | 1044 | 2.59 |
| MAGMA | 1404 | 1.47 |
| Jev-Mem | 158 | 0.93 |
- 构建:Jev-Mem 建完整个记忆只要 158 秒,最快的对比记忆系统 Nemori 要 1,044 秒——缩短 84.9%,即 6.6 倍加速;A-MEM(3,636 秒)和 MemoryOS(3,276 秒)都在 3,000 秒以上。→ 详细
- 查询:平均每题 0.93 秒,比最快的记忆型基线 MAGMA(1.47 秒)低 36.7%,比直接处理完整上下文(1.74 秒)低 46.6%;MemoryOS 每题要 32.68 秒,论文拿它说明「当复杂处理仍留在检索路径上时」,记忆管理会带来多大的运行时开销。→ 详细
- 快在哪:构建时,轻量的类型化决策在有界的候选集上批量跑,而不是反复叫通用 LLM 做自由形式的记忆处理;检索时,路由、候选评估、证据核查交给系统一,图探索受显式预算约束,证据够了就自适应停下,不做多余遍历。→ 详细
- 不以准确率换速度:论文强调「效率的提升并未以牺牲推理质量为代价」——同一组实验里准确率也最高;结论据此称,把记忆控制与生成式推理分开,是构建更有效、更高效长程 agent 的「一个有前景的方向」。→ 详细
11
相关工作(附录 A.1):别人在改「存什么、怎么组织、怎么查」,Jev-Mem 改的是「这些决定由谁来做」
- 别人改的是「存什么、怎么组织、怎么查」:从 Generative Agents、Reflexion、MemoryBank、MemGPT,到存可复用行为的 Voyager、ExpeL、Agent Workflow Memory,再到 A-MEM、Mem0、MemoryOS、Nemori、MAGMA、HAGE 这些结构化、会演化的记忆;GraphRAG、HippoRAG 等检索系统结构相近,但只在给定语料上检索,不维护 agent 自己不断累积的经验。→ 详细
- Jev-Mem 占的是哪一格:自适应检索(IRCoT、FLARE、Self-RAG、Adaptive-RAG)只在单次生成里决定查不查、查多少,且不改语料;SimpleMem、LightMem、Zero-Mem 在压记忆流水线的成本(Zero-Mem 把 LLM 生成从中间记忆操作里整个拿掉);模型级联与路由器决定「哪个模型来答」。Jev-Mem 针对的是剩下那一格——记忆生命周期内部的细粒度决策「应当以何种方式执行」。→ 详细
- 系统一 / 系统二只是类比:术语来自人类推理的双过程理论(Evans, 2008),论文明说「仅把这一区分用作计算分配方式的类比,并不主张二者的底层机制彼此对应」;System 2 Attention、Tree of Thoughts、Graph of Thoughts 是在单次推理内部加「慢思考」,Jev-Mem 则把这种区分放到架构层、用在记忆子系统本身。→ 详细
12
附录 B 提示词(写入侧):每个 Noul 在判断什么——类型、关系、整合
- 贯穿示例(虚构):两条记忆——m1(2024 年 5 月 14 日 10:00)「Mira:我的旧自行车坏了」,m2(5 月 16 日 10:00)「Mira:我昨天买了一辆新自行车,因为旧的那辆坏了」,都带实体
Mira、bicycle;查询是「Mira 是什么时候买的新自行车?为什么?」。时间戳记的是这句话被观测到的时间,不一定是事件发生的时间。论文声明示例记忆是虚构的,只演示请求结构,不把任何分数当作实测的 Jev 预测。→ 详细 - 写入不设门槛:当前配置关闭了准入过滤(
admission_enabled=false),每条有效的非空观测都进写路径,类型分不决定留不留。类型标注一次批量问四个 Noul——episodic、semantic、procedural、preference,附录给出了其中两个的原文判据(下两条)。→ 详细 episodic(情景):这条观测是否描述了某位参与者的一次特定经历或事件?真=具体的过去、当前或计划中的事件,哪怕没说确切时间;假=只是一般事实、流程或偏好。→ 详细preference(偏好):是否表达了某位参与者的偏好、反感或习惯性选择?真=能归到具体某人的喜欢、讨厌、偏爱选项或习惯;假=只是一次孤立的行为、没说是谁的偏好,或压根没有偏好证据。→ 详细- 候选与关系请求:打完类型,由确定性的向量、关键词、实体、时间戳信号选出至多 10 条已有记忆当候选;关系请求把语义关联和两个方向的因果放进一批判断,只有精确的实体标识符对不上时,才加一道实体别名消解(判断两种写法是不是同一个人或物)。→ 详细
semantic(语义关系):在新记忆和候选之间连一条语义边,是否有助于检索它们共有的某个具体话题或事实?真=有具体的共同话题、事实或事件,这条连接有用;假=只有泛泛的对话用语,或没有有意义的联系。→ 详细caused_by(有向因果):候选里的事件是否导致、促成或解释了新记忆里的事件?真=给出的记述支持这个方向的因果影响;假=只有相似、时间先后、共同实体,或因果证据不足。causes检验反方向;判据刻意把「真有因果」和「话题相同 / 只是先后发生」分开。→ 详细- 建边门槛 0.60:关系分数 ≥ 0.60 就建对应类型的边;精确的实体交集直接确定性连边——示例里两条记忆共享
Mira、bicycle,所以不必再调别名消解。→ 详细 - 每 20 次成功写入整合一次:四个 Noul 分别判冗余、矛盾、过时、链接有没有用,再由一个 Choice 选表示形式;这是插入之后单独做的决定,不是准入过滤。→ 详细
representation(Choice,四选一):这两条观测的关系最适合哪种表示?keep_separate(分开存)=记述矛盾、合并会丢独特细节,或是不同事实且没有证据支撑的一般模式;merge(合并)=同一事实或事件的相容记述,合并不丢细节;promote(提升为一般规律)=多次不同的重复情景明确支撑一个稳定模式、适合做语义抽象,重复事件优先选它而不是合并;uncertain(拿不准)=证据不足,没法稳妥地选合并还是分开。指令还特意叮嘱「依据所提供的记述作出判断,不要预设其他问题的答案」。→ 详细- 整合不替换原件,改写要过双门槛:常规的周期整合只记录决定和链接,不会自动替换源记忆;只有
merge或promote以 ≥ 0.85 的概率被选中、且矛盾分低于 0.85 时,调用方提供的系统二摘要器才能生成一条新的表示——卡门槛的是被选项自己的概率,不是另算的置信度汇总。→ 详细
13
附录 B 提示词(检索侧·路由与打分):先问「要不要时间线、要不要因果」,再问候选「是答案要的事实吗、是新的吗」
- 路由请求只看查询本身:一次问六个 Noul——语义、时间、因果、实体四种需求,加上
multi_hop_need(要不要多跳)和recency_importance(新近性有多重要);一个查询可以同时激活几种图。→ 详细 temporal(时间路由):回答这个查询是否需要事件的日期、持续时长、先后顺序或随时间的变化?真=要靠某种时间关系才能答对;假=日期或先后对答案只是附带信息。→ 详细causal(因果路由):回答是否需要解释某个原因、动机、促成条件或结果?真=需要因果或解释性证据;假=只问事实关联或时间先后。→ 详细- 预算怎么落地:当前配置的图扩展总预算是 80;需求分为正且 ≥ 0.10 的图保底 1 个额度,剩下的按需求分成比例分、用最大余数法取整,概率指数取 1.0(按需求分直接成比例,不额外放大或压平);图扩展前先由向量和关键词检索给出锚点,而且预算并不意味着每条边都要向服务方发一次请求。→ 详细
- 遍历请求把方向写明:包含查询、当前已选证据和拟议候选,每个候选附上记忆字段、图类型、关系属性和源 / 目标标识。示意:证据里有 m1,候选 m2 经一条 m1→m2 的因果边到达——论文说明这只是示意状态,不代表这个小例子实际运行时一定要扩展。→ 详细
relevance(候选相关性):候选内容是否包含回答查询所需的事实?真=能直接支撑答案的证据,或必要的中间事实;假=只是话题重叠,或内容无关。→ 详细new_information(新增证据):候选是否补上了现有证据里缺的、与答案相关的细节?真=一个不同于已有证据的相关细节,或一个缺失的推理环节;假=只是重复证据,或无关的新细节。→ 详细- 另两个 Noul 与综合分:
relation_usefulness(经由的这条关系有没有用)和supports_current_evidence(是否支持当前证据);这四个分数按第七节的方式与余弦相似度、图需求分、边概率合成综合分,按它排序,束宽 10——光是相关分高,并不能无条件进入检索证据。→ 详细
14
附录 B(停止):「够了吗」和「还值得再查吗」分开问——阈值 0.95 / 0.15 / 0.15,外加五道硬上限
- 停止请求:包含查询、当前选中的 top-k 证据和检索深度,评估
evidence_sufficient、continue_useful、missing_evidence、contradiction四项,刻意把「对答案的支撑」和「再查一轮的预期效用」分开问。→ 详细 evidence_sufficient(证据充分):证据是否为答案里每一个事实性部分都提供了支撑?真=不用编造缺失事实,就能凭这些记忆给出有依据的答案;假=任何一项必需的事实或推理环节没有支撑——「仅有相关话题并不充分」。→ 详细continue_useful(还值得再查吗):再查一轮是否有可能填补某个具体缺口,或化解某个冲突?真=存在可识别的缺失事实或冲突,能从更多检索中获益;假=已没有可识别的检索需求,或更多记忆不太可能帮上忙。→ 详细- 时间类查询多带两个字段:证据和候选对象还带
timestamp_role与temporal_references,把时间戳标明为「观测时间」,并附上锚定过的时间表达及其精度——判断充分性时用的时间锚定,和交给作答方的保持一致,不把每个对话日期都当成事件日期。→ 详细 - 阈值与上限:证据停止要求
evidence_sufficient≥ 0.95,且missing_evidence与contradiction都 < 0.15;continue_useful< 0.15 时也可以停。另有五道各自独立的上限——深度 8、访问节点 60、检查边 2400、Jev 尝试 16 次、检索时限 15 秒,证据不完整时它们也可能把检索叫停;时限只在操作与操作之间检查,对本地计算不保证到点立刻打断。→ 详细 - Jev 不写答案:Jev 只控制证据选择,不生成最终的自由形式答案,选出的记忆交给独立的系统二语言模型;所以附录里这些提示词都是记忆控制决策,不是作答或评估用的提示词,而且 Jev 看到的状态里不含标准答案和基准的证据标注。→ 详细
- 整套参数一张小抄:写入候选至多 10 条、建边门槛 0.60、每 20 次成功写入整合一次、整合改写门槛 0.85;图扩展总预算 80、保底门槛 0.10、束宽 10;停止 0.95 / 0.15 / 0.15;上限 8 / 60 / 2400 / 16 次 / 15 秒。→ 详细
15
读这篇论文要记住的几条前提:一个基准、几处数字对不上、几件没有说明的事
- 只有一个基准:第 4.1 节写「在两个广泛使用的基准上评估」,但全文只描述、只报告了 LoCoMo 一个(原文如此)。所以「准确率最高、效率最高」目前都是这一个长对话记忆基准上的结论。→ 详细
- 正文与表 1 的分项数字对不上:多跳正文写 0.625、表里 0.623;开放域正文 0.610、表里 0.618;单跳正文 0.797、表里 0.802。正文还说「在六个类别中的五个上表现最佳,并在时间推理上与最佳结果持平」——表 1 是 5 个分项加 1 个总体,把总体算进去,Jev-Mem 确实是 6 列里 5 列第一;但时间类它是 0.637,0.650 属于 MAGMA(Nemori 的 0.649 也比它高),谈不上持平。原文如此,本总结的数字一律以表为准。→ 详细
- 几处编校小问题:公式编号在 (17) 之后直接跳到 (21);MemoryOS 的引用在基线列表里写作 Kang et al., 2025b,在相关工作里写作 2025a(原文如此)。→ 详细
- 论文没有说明的事:Jev 以「Jev TypeSafe AI (2026)」的形式被引用,论文没有说明作者与 TypeSafe AI 是什么关系,也没有资助说明;全文也没有单独的局限性讨论。→ 详细
- 分数不是校准过的概率,附录示例是虚构的:附录明说 Jev 返回的数值「并不假定」是校准过的概率——0.95、0.60 这些门槛是划在模型自报的分数上,不能直接读成「95% 的把握」;附录里的 Mira 自行车记忆是虚构的,只演示请求结构,不是实测预测。→ 详细
- 效率数字只有两项总耗时:表 2 报的是记忆构建总时间和平均查询延迟,没有单独报 Jev 调用本身的耗时占比或费用,也没有交代计时所用的硬件与网络环境;作答模型 gpt-4o-mini 之外,LLM 裁判用的是哪个模型也没有单独写明。→ 详细
16
闪电问答 / 收尾
本期是论文,没有闪电问答;结论段(把记忆控制与生成式推理分开「是构建更有效、更高效的长程智能体的一个有前景的方向」)已并入第十节最后一条,读数字前的注意事项集中在第十五节。
17
联系方式
作者 Dongming Jiang、Yi Li、Bingzhe Li(通讯作者),均属 UT Dallas 计算机科学系,邮箱见论文首页;论文 arXiv 2609.23986,代码 GitHub · libingzheren/Jev-Mem。