软件工厂如何自我改进——Suraj Gupta(Warp)
- 一Warp 的 harness 开发负责人 Suraj Gupta 认为,软件工程师正从「造产品」转向「建工厂、维护工厂」,而很少有人讲的是工厂本身怎么随时间变好;他把答案拆成三种回去就能落地的机制:skill、持久记忆、模型路由。→ 详细
- 二skill 和记忆共用一个套路:一个外层循环 agent 盯着干活的内层 agent(例子是 Warp 开源仓库里的 issue 分诊 agent、查线上报错的 Sentry agent),从赞踩、评论和运行记录里提炼经验;skill 的改动以 PR 的形式进 Git、由人评审后才合并,记忆则进一个有版本、人可增删改、每条都能追回来源运行、跨 harness 通用的事实库。→ 详细
- 三模型路由针对的是「简单活也全用 Opus,成本会高到吃不消」:按任务类别把活分给不同模型(他的配置示例把数据库迁移交给 GLM、运维手册和 API 文档交给 Qwen),他承认目前「更像艺术而不是科学」;Warp 内部用 eval 旁路加 best-of-k 在真实任务上比模型,跑出「UI 任务用 GLM 就够」,下一步是让客户按自己的任务类别做 eval。→ 详细
开场:我们正从「造产品」转向「造工厂、维护工厂」,却很少有人讲工厂本身怎么变好
- 讲者 Suraj Gupta 在 Warp 负责 harness(包在模型外面、管提示词 / 工具调用 / 循环逻辑的那层程序)的开发。Warp 从一个现代化终端起家,先做了 agentic 开发环境(让 agent 在里面帮你写代码、跑命令的开发工具),按他的说法「现在大约有一百万活跃用户在用」;如今在做一个云端 agent 平台,帮团队搭建软件工厂(同批 249 的 Warp CEO 讲了这套工厂的全貌)。→ 详细
- 他的切入点:「自我改进」(agent 和模型随时间变好,同时逐步把人从循环里撤出来,让改进自动转起来)和「软件工厂」(开发范式从一个个单独的编码 agent,转向一整套把工作从分诊一路推到生产环境的自动化)这两个词,大家在大会上都听过,但多半是分开听的;很少有人讲软件工厂本身怎么随时间自我改进,让工厂变得更好、更高效、更快。→ 详细
- 他的判断是:「随着我们从做产品转向建工厂、维护工厂,这会成为我们软件工程师工作中极其重要的一部分。」他也自嘲这个题目「听起来可能有点像在追热词」,所以承诺拆成具体、回去就能落地的三种机制:skill、持久记忆、模型路由。→ 详细
skill 为什么会过时:程序性记忆跟不上人的反馈和 agent 自己的运行
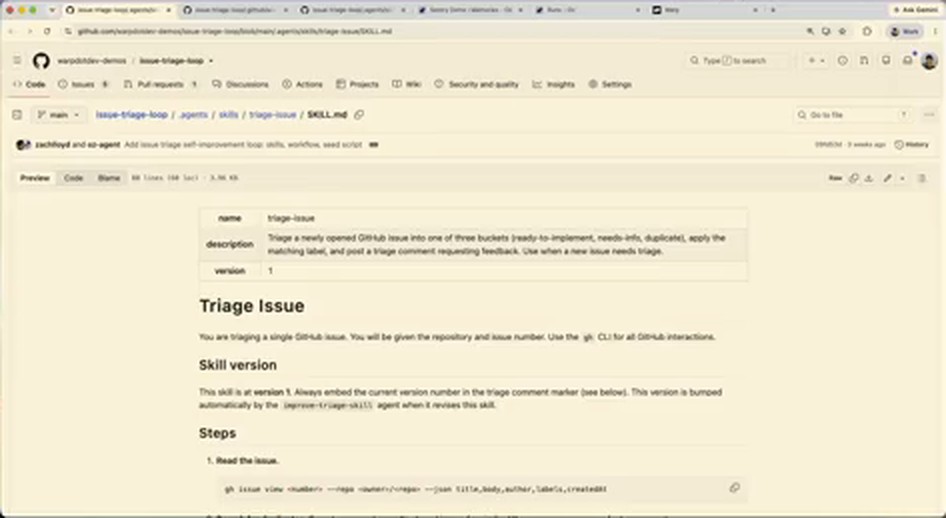 ▲ 图注:GitHub 仓库 warpdotdev-demos/issue-triage-loop 里分诊 agent 的 SKILL.md:把新开的 issue 分进可直接实现、缺信息、重复三个桶之一,打上对应标签,再发一条征求反馈的分诊评论;文中注明当前是第 1 版,版本号由负责改进它的 agent 修订时自动递增。
外层循环 agent:专门盯着干活的 agent,找它的错、读人的反馈
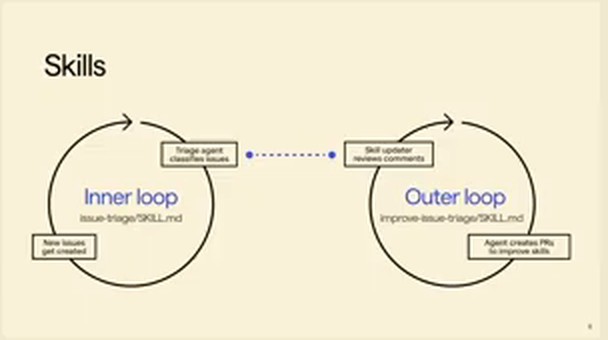 ▲ 图注:「Skills」这页幻灯片:左圈是内层循环(issue-triage 的 SKILL.md:新 issue 进来,分诊 agent 给它分类),右圈是外层循环(improve-issue-triage 的 SKILL.md:skill 更新者读评论,agent 开 PR 改进 skill),两圈之间一条虚线相连。
- 他的答案是部署一个外层循环 agent——「这正是我们在自己内部的软件工厂里做的,效果一直很好」。分工是:内层循环 agent 负责真正应用 skill,也就是实际去做分诊;外层循环 agent 观察内层的每次运行,找出它犯过的错、查看人给它的反馈,据此随时间改进它的 skill。一个干活,一个专职复盘干活的那个。→ 详细
- 现场演示的是 Warp 内部真在用的 skill。Warp 已经把客户端代码仓库开源,「而且它完全是按工厂的方式在运转」。分诊 agent 的活是:GitHub 上进来一个 issue,自动弄清用户少提供了哪些信息,而这些信息能帮团队判断——这是该去做的东西、是某个已有 issue 直接去重就行,还是别的情况。驱动它的 workflow 很简单:仓库里每提交一个 issue,就跑一次。→ 详细
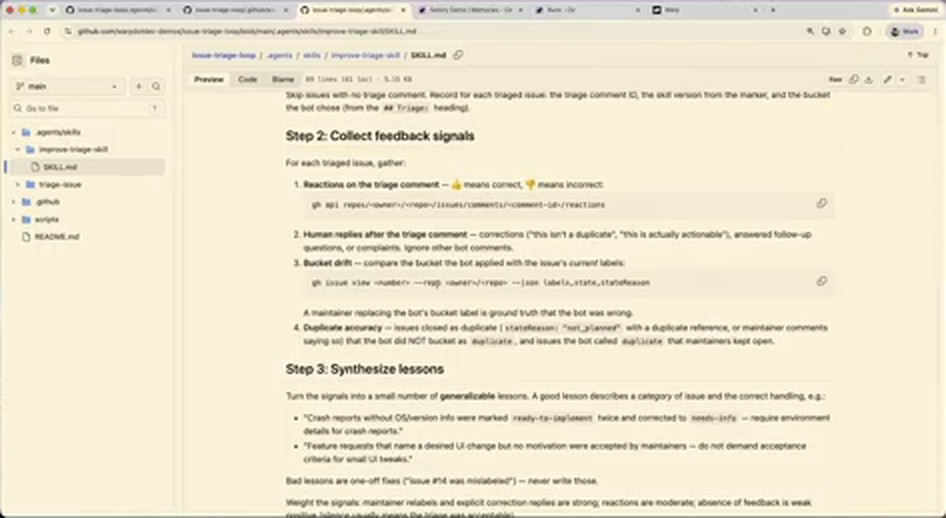 ▲ 图注:外层 agent 的 improve-triage-skill/SKILL.md 写明了收哪几类反馈:分诊评论上的赞和踩、之后的人类纠正回复、维护者把机器人打的桶标签换掉、重复判定对不对;再把信号提炼成少量可推广的教训(示例:缺系统和版本信息的崩溃报告两次被判成可直接实现、又被改成缺信息,以后崩溃报告要先要环境信息),一次性的纠正不写;维护者改标签和明确的纠正回复分量最重,表情反应中等,没有反馈算弱信号。
- 外层循环 agent 审视内层分诊 agent 做出的各个决策,并收集三类反馈信号:issue 上的点赞 / 点踩、用户在 issue 下的评论、Warp 员工在 issue 下给 agent 的点评(告诉它这次做得怎么样)。→ 详细
改进落成 PR:skill 的每一次变化都进 Git、都有人审
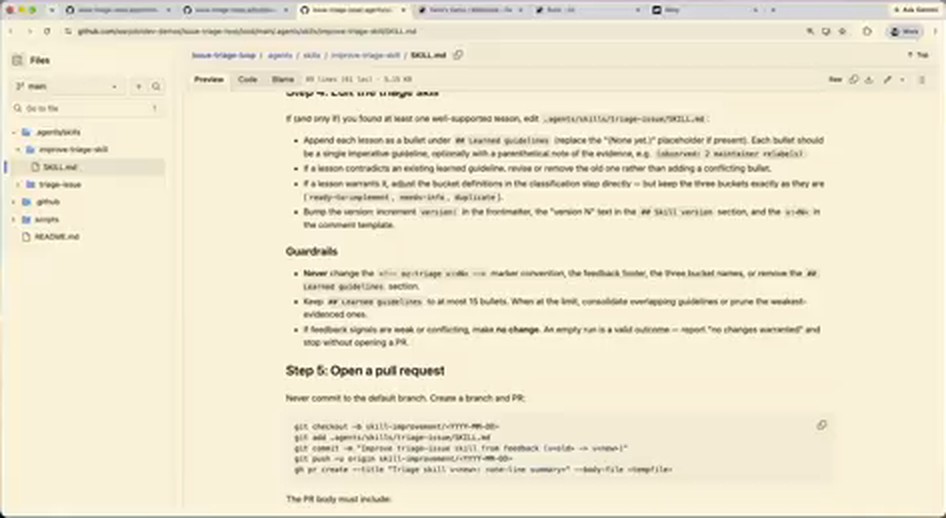 ▲ 图注:同一份文件的后半:至少有一条证据充分的教训才改分诊 skill,每条以一句话追加到 Learned guidelines 下(最多 15 条,满了就合并重叠项或删掉证据最弱的),并递增版本号;三个桶名等约定不许动;信号弱或互相矛盾就不改、也不开 PR;要改就新建分支开 PR,绝不直接提交到默认分支。
- 外层 agent 把收集来的反馈汇总成对这一轮迭代的提炼,再拿它去更新内层 skill——「基于 skill 的自我改进循环就是这么来的」。→ 详细
- 他说这套做法「特别好」的地方在演示流程的第四步:外层 agent 改好分诊 skill 之后,不是直接生效,而是开一个 PR(pull request,合并请求:把改动提交给别人审、审过才并进主干)。好处有两层:一是对内层 skill 的所有改进都通过 Git(代码版本管理工具)留下记录,skill 随时间怎么演变,「你拥有完整的可观测性」;二是「真的会有人来评审这些对 skill 的更新」,这样就不会出现外层 agent 自己犯了错、最后反而让分诊 agent 表现变差的情况。→ 详细
- 也就是说,在他这套循环里,改 skill 的是 agent,拍板合并的仍然是人;「自我改进」省掉的是人去翻反馈、动手改写 skill 的那部分活,评审这道闸没撤。(同批 246 讲让 agent 定期自查 skill,同批 248 和 ep195 讲把运行 trace 接进改进循环,是另几种让系统自己变好的做法,可对照看。)→ 详细
持久记忆:skill 记住了流程,那「上次是怎么修好的」谁来记
- 转场问题是:「skill 很适合用来记住流程,那其他的东西呢?」他的例子是 Sentry agent(Sentry 是一个错误监控服务,这类 agent 专门查线上报错):它查到一个 issue、花功夫收集相关上下文、把它修好了;之后又遇到一个类似的 issue。它也许运气好,能找出和第一次一样的根因,「但这没法保证」;就算找出来了,你大概也已经浪费了大量 token(模型按 token 计费,大致相当于读写的字数),在一个以前修过的问题上重新收集上下文。→ 详细
- 解法是持久记忆,他的定义是「一个限定在单个 agent 范围内的事实库」。机制和 skill 循环同构:仍然由一个外层循环 agent 从内层 agent 的运行里提取事实、经验和结果,让 agent 之后再跑时能借助过去已经做过的东西。skill 管「怎么做」,记忆管「做过什么、学到了什么」。→ 详细
Oz 的记忆库:有版本、人能增删改、每条都能追回它来源的那次运行
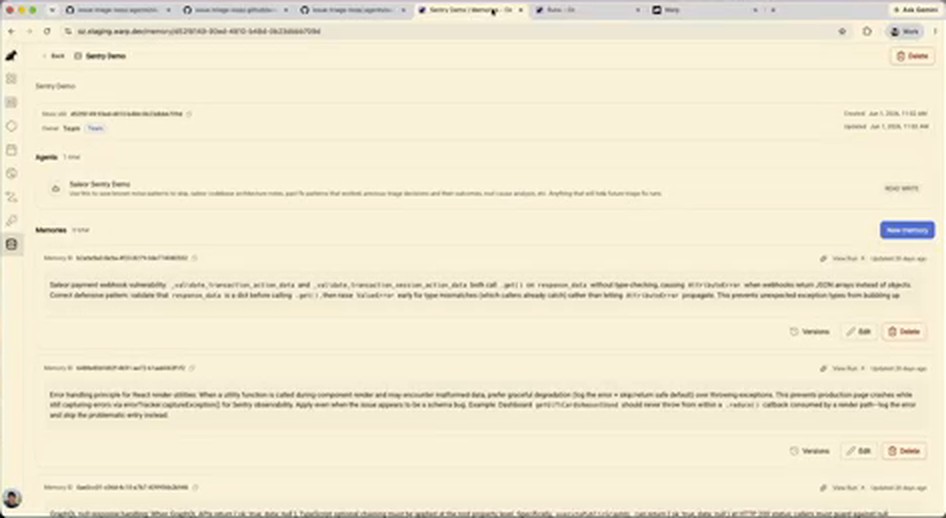 ▲ 图注:Oz 预发环境里名为「Sentry Demo」的记忆库,挂在「Saleor Sentry Demo」这个 agent 上(可读可写);每条记忆旁都有 View Run(点回产生它的那次运行)和版本、编辑、删除入口。第一条记的是 Saleor 支付 webhook 里一处缺少类型检查的漏洞及正确的防御写法,第二条是 React 渲染期工具函数的错误处理原则。
- 演示放在 Oz 上——Warp 的云端 agent 平台(他先说成 Warp,随即改口「准确说是在 Oz 里」),平台上的所有 agent 都可以挂载记忆库,记忆库就是「一组事实的集合」。例子里的 Sentry agent 已经随时间积累了一批关于过去根因分析的记忆。(同为 Warp 的 Safia Abdalla 讲过 Oz 平台的四个原语,见 ep191。)→ 详细
- 他强调的三个设计点:记忆可以做版本管理;人可以更新、新建、删除记忆,但「这个生成记忆的循环主要是由 agent 来驱动的」;每条记忆都能看到是从哪儿来的,可以点开它来源的那次运行。这样你就能判断:「这条其实算不上重要的记忆」,或者「那条有点像是局部最优(只在当时那次情境里看着对、换个场景未必成立的结论),我不想把它放进我的记忆库」。(现场他想点开那次运行,但 IP 地址一直在变、预发平台限定 IP 访问,没打开。)→ 详细
- 记忆真正用起来的样子:这个 Sentry agent 生成记忆之后又跑了很多次,分诊新 issue 时真能借助它们。演示里的一次运行做完根因分析,最后汇报了自己用到了哪些记忆——用上了记忆库里的五条,加快了这一轮的工作。→ 详细
- 在 Oz 上,持久记忆跨 harness 通用:Warp 自己的专有 harness、Claude Code、Codex,「你在 Oz 上跑的是什么其实都无所谓,记忆都会自动帮你生成」。→ 详细
- 收束这一节时他又强调了一遍控制权:你可以随意评审这些记忆、做版本管理、删除或编辑,「而且这一切全程可追溯」。→ 详细
模型路由为什么重要:简单活也全用 Opus,成本会高到吃不消
- 第三种机制是模型路由(按任务把活分给不同的模型)。他先抛出「这跟工厂的自我改进循环有什么关系」,但先讲它为什么在工厂里本来就重要:如果你所有的 agent,哪怕干的只是分诊、修简单的 CI 失败(CI:持续集成,每次提交代码都自动跑构建和测试)这种简单活,都用 Opus(Anthropic 最贵的顶配模型档)来跑,「成本可能会高到让人吃不消」,时间一长会非常贵。他还补了一句:「我相信在座有些人可能已经在这上面吃过亏,或者听说过有的组织在这上面栽了跟头。」→ 详细
- 所以「决定哪个任务用哪个模型,其实非常重要」,这也是 Warp 一直在做的事。现成的做法是 Warp 开箱即用的模型路由器,叫 auto 模型(自动选模型):每当有新模型出来,他们都会持续评估,从帕累托效率(在效果和花费之间取最划算的那一档:同样的钱效果最好,或同样的效果花钱最少)的角度看哪些模型最好。对只想先上手的新用户,这「比把模型固定死成 Opus 或者 Haiku(Anthropic 的轻量便宜档)之类的要好得多」。→ 详细
自定义路由规则:数据库迁移交给 GLM、运维手册交给 Qwen,但「更像艺术而不是科学」
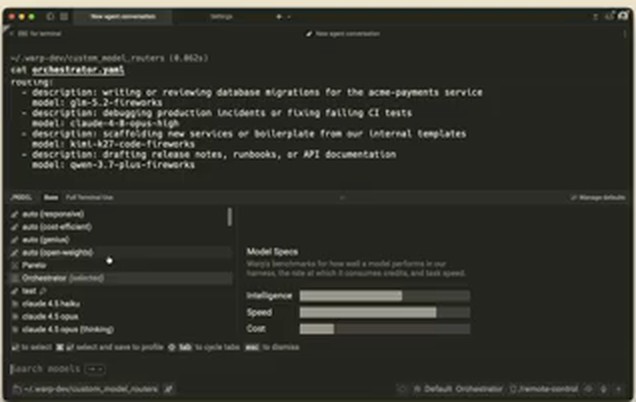 ▲ 图注:Warp 桌面端终端里打开的自定义路由配置 orchestrator.yaml,写了四条规则:acme-payments 服务的数据库迁移交给 GLM,排查生产事故和修失败的 CI 测试交给 Claude Opus,按内部模板搭新服务交给一个 Kimi 系代码模型,发布说明、运维手册和 API 文档交给 Qwen。下方的模型选择器列着几档 auto 模型(responsive、cost-efficient、genius、open-weights)、Pareto 和当前选中的 Orchestrator,右侧用智能、速度、成本三根条对比模型。
- 演示在 Warp 桌面端:指定模型的地方,auto 模型是其中一个选项;你也可以定义自己的路由模型,「说白了就是一组规则」,交给 Warp 按规则做路由决策。他展示的配置文件里写了几条规则,比如数据库迁移用 GLM(智谱的模型)做,runbook(运维手册)和 API 文档用 Qwen(阿里的通义千问)做——把任务划成不同类别,说「这一类任务我要交给这个模型做」,依据是你实际看下来的结果。→ 详细
- 但他坦白:「就目前来说,这更像是一门艺术,而不是科学。」所以接下来在做面向客户的 eval(评测:用一批任务给模型输出自动打分):你定义自己在意什么、想在这些配置上调哪些旋钮,然后真正看到「在某一类具体的问题上,到底是 Haiku 更好,还是 GLM,还是 Opus」——这是针对你自己的工作流的,「而不只是网上某个人贴出来的某个通用 benchmark」。→ 详细
Warp 内部怎么做:路由规则加一个 eval 旁路,用 best-of-k 跑出「UI 任务用 GLM 就够」
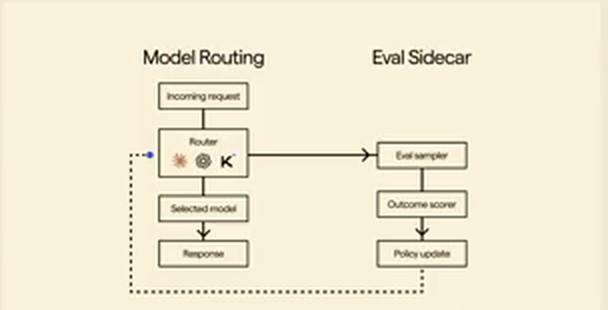 ▲ 图注:「Model Routing」这页幻灯片:请求进来,经 Router 选出模型再返回结果;Router 旁连着 Eval Sidecar(评测采样 → 结果打分 → 策略更新),策略更新再用虚线回连 Router。
- 他给的 Warp 现状概览:内部有自己的模型路由规则,同时挂着一个 eval 旁路(sidecar:挂在主流程旁边、不挡道的辅助程序),专门判断哪类任务用哪个模型效果更好。方法是简单的 best-of-k(同一个任务并行跑 k 份、取最好的那份):你输入一个 prompt,他们就在 Oz 上用一组不同的模型同时跑一批 agent,拿结果来比。→ 详细
- 这样跑出过实在的结论,原话是:「UI 类任务用 GLM 做得非常好,其实没必要用 Opus 跑,用 GLM 跑效率高得多。」他口头没有单独点明路由怎么接进自我改进循环,但他放的原理图(见上图)里,旁路的「策略更新」回连着路由器,挂钩点就在这里:哪类任务配哪个模型,由旁路在真实任务上比出来,而不是靠人凭感觉定。→ 详细
- 这套目前是 Warp 内部在用,他说「很快」会做进产品,让客户在自己的工作流里也能用上。→ 详细
闪电问答 / 收尾
本期为大会单人演讲,无闪电问答环节。收尾只有一句:今天要讲的大概就这些,Warp 的展台在会场那一侧,对这类话题感兴趣的欢迎去找他聊。→ 详细