关键词搜索正在消亡,你的商品目录为 AI Agent 准备好了吗?——Nixon Dinh(PayPal)
- 一购物正在从「搜索时代」(人敲关键词、自己翻目录)走向「意图时代」(人用大白话描述需求,AI 把商品送到面前),下一站是「委托时代」(agent 直接替人下单);而商家手里的商品目录,是照着 Google Shopping 这类广告 feed 和人的关键词搜索建的,agent 读不好。 → 详细
- 二agent 背后的模型怎么排序是个黑盒,没有 SEO 那样的现成打法,所以 PayPal 自己做了对照实验:把商家的商品数据按五个维度富化(补属性、写厚描述、加买家情境、加信任信号、统一商品身份),再看 agent 的检索和推荐怎么变。 → 详细
- 三结论是三句:富化有效,目录越单薄的商家收益越大;但文字更多不等于更好——幻灯片上关键词检索(BM25 Top 10)的图例从 4.27 升到 8.89,语义检索(Semantic Top 10)却从 6.09 降到 3.87,给出的原因是一段长文本压成一个向量会失焦;最后胜出的是结构化的高质量内容,套话和堆砌只会稀释信号。 → 详细
讲者和议题:PayPal 的产品总监讲「商品目录怎么为 agent 就绪」
- 讲者 Nixon Dinh 是 PayPal 的 Agentic Commerce(代理式电商:由 AI agent 参与、甚至代办的购物)产品总监,职业生涯大部分在做电商和支付,现在牵头 PayPal 关于「AI agent 怎样重塑购物和支付」的工作。本场只讲其中一块:商品目录(catalog,商家那份「我卖什么」的结构化清单)怎么做到 agentic ready(为 agent 准备就绪),以及 PayPal 一路的实验所得。 → 详细
- 读的时候留意立场:PayPal 自己在卖 Agentic Commerce Services,讲者结尾请听众去展位了解;文中的实验由 PayPal 自己完成,台上没有交代样本量、用了哪些 agent 和模型、查询集怎么来的。 → 详细
商业演化的五段路,和两条不变的规律
购物行为的三段迁移:搜索 → 意图 → 委托
- 搜索时代(今天):关键词、在目录里一层层翻、点进去看,过去十年企业都朝 SEO 优化。这套管用,但把「找到东西」的负担压在购物者身上。 → 详细
- 意图时代(正在过渡):人不再敲「学习用品」,而是说「我女儿九月开学、上五年级,我要采购开学用品」。用自己的话表达需求,由 AI 来迎合你——变成品牌来找你,而不是你去找品牌。 → 详细
- 委托时代(下一波):前提是顾客先信任 agent 给的推荐,信任建立起来之后,才会把越来越多动作交给 agent;幻灯片上的例句是「把开学采购办完,控制在 300 美元以内」。讲者说 PayPal 正朝这个方向建设。 → 详细
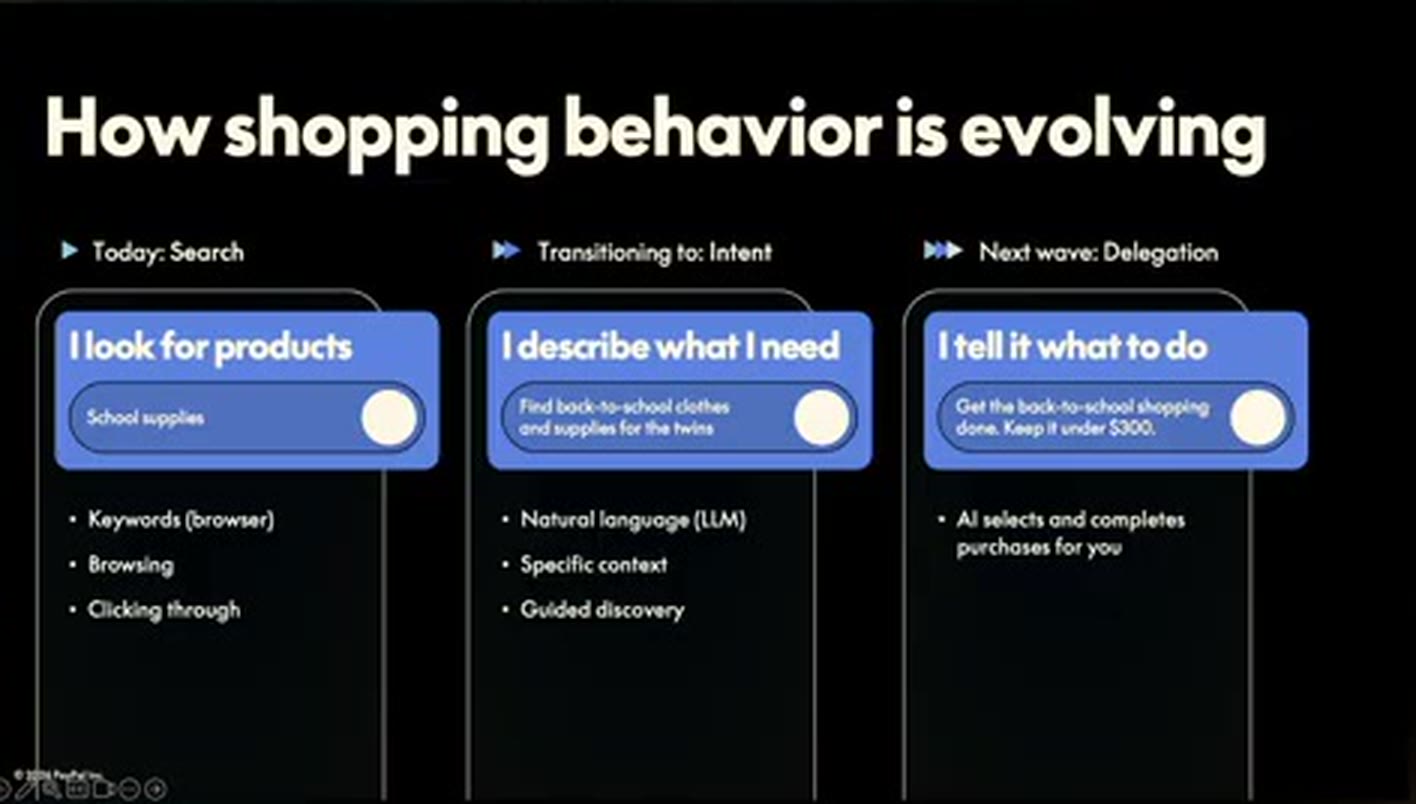 ▲ 图注:幻灯片「How shopping behavior is evolving」:今天是 Search(I look for products,搜的是 School supplies);正在过渡到 Intent(I describe what I need);下一波是 Delegation(I tell it what to do,例句是把开学采购办完、控制在 300 美元内)。
为什么现在就要动:台上给的几组数字
- 贝恩公司(Bain & Company)预测:到 2030 年,15%–25% 的商业交易由 agent 执行。另一条预测是十年内网上的 agent 数量会超过人类(幻灯片脚注标的出处是 Fortune 的一篇报道,360p 截图看不清细节)。讲者据此说,这不是可以忽略的边角变化,而是整个电商生态的结构性转变。 → 详细
- 市场规模(幻灯片注明来源是麦肯锡 2025 年 10 月的《The agentic commerce opportunity》,口径是到 2030 年):美国 B2C 零售约 1 万亿美元(讲者口述 1.1 万亿,幻灯片写 $1T),全球 3–5 万亿美元。另有「20 亿以上」这个数:口述是未来几年将有超过 20 亿用户用 AI 开启购物,幻灯片写的是 ChatGPT、Gemini、Copilot、Meta、Amazon 等平台合计 20 亿以上活跃用户。 → 详细
- 商家侧已经看到的三个数:AI 引荐到零售网站的流量同比增长 693%(幻灯片注明是 2025 年假日季对比 2024 年);39% 的美国消费者已经在用 AI 购物;购物者在访问过程中和 AI 互动时,转化率高到 4 倍,讲者的解释是这时能拿到关于商品更丰富、更深入的信息。 → 详细
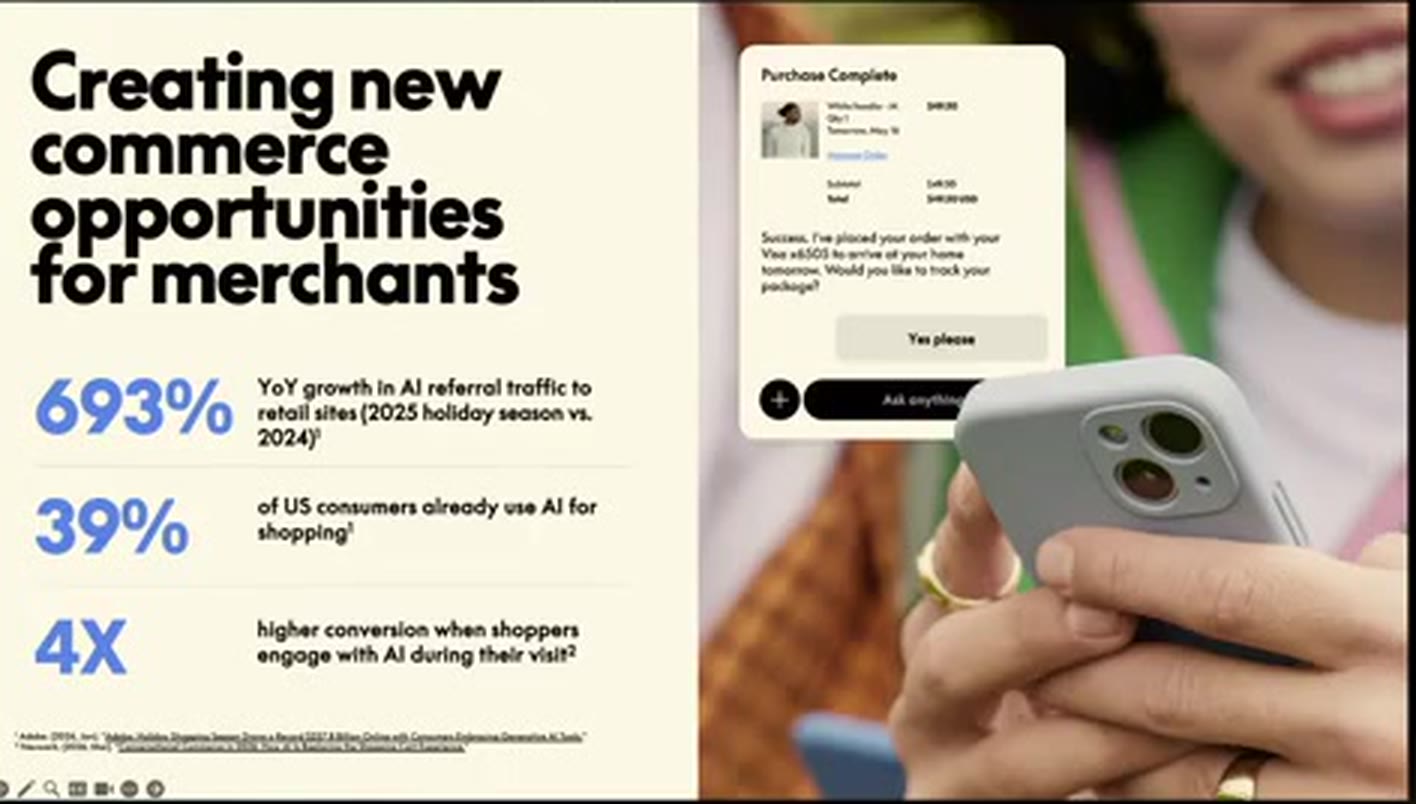 ▲ 图注:幻灯片「Creating new commerce opportunities for merchants」:AI 引荐到零售网站的流量同比增长 693%(2025 年假日季对比 2024 年)、39% 的美国消费者已用 AI 购物、购物者访问中与 AI 互动时转化率高 4 倍。
三个时代里,商家各自要解决的问题
- 搜索时代:投 SEO、做自己的 App 去接住需求(讲者举的例子是针对 sundress 这样的词做优化)。意图时代:得在 AI 带来需求的地方「能被发现」。委托时代:得以安全、可信的方式,在对话式体验里把需求转化成订单。 → 详细
症结:目录是为人的搜索建的,不是为 agent 建的
- 讲者的核心判断是商品目录当初不是为 agent 建的。今天多数商家有一份目录,分发给 Google,或者 Meta 等广告平台去投广告;那套规范是为广告和人的搜索设计的,没有针对「让 agent 发现商品」做过优化,对 agent 的可读性也差。 → 详细
- 幻灯片把这句话拆成三张卡,比口述更具体。第一张:人们现在通过 AI agent 发现商品,ChatGPT Shopping、Perplexity Pro、Google Gemini 把人直接导向「一件商品」,而不是一个页面——换句话说,被检索、被推荐的单位是一条条商品数据,不是商家做的落地页。 → 详细
- 第二张:目录为人的搜索而建——描述里塞满关键词、用的是自家私有的 ID、schema(字段结构)照着 Google Shopping feed 设计,而不是为 AI 检索设计。第三张:「能被发现」没有标准——每种富化方法都自称「AI 可发现」,但没有办法验证,也没有简单的办法横向比较各家的方法。 → 详细
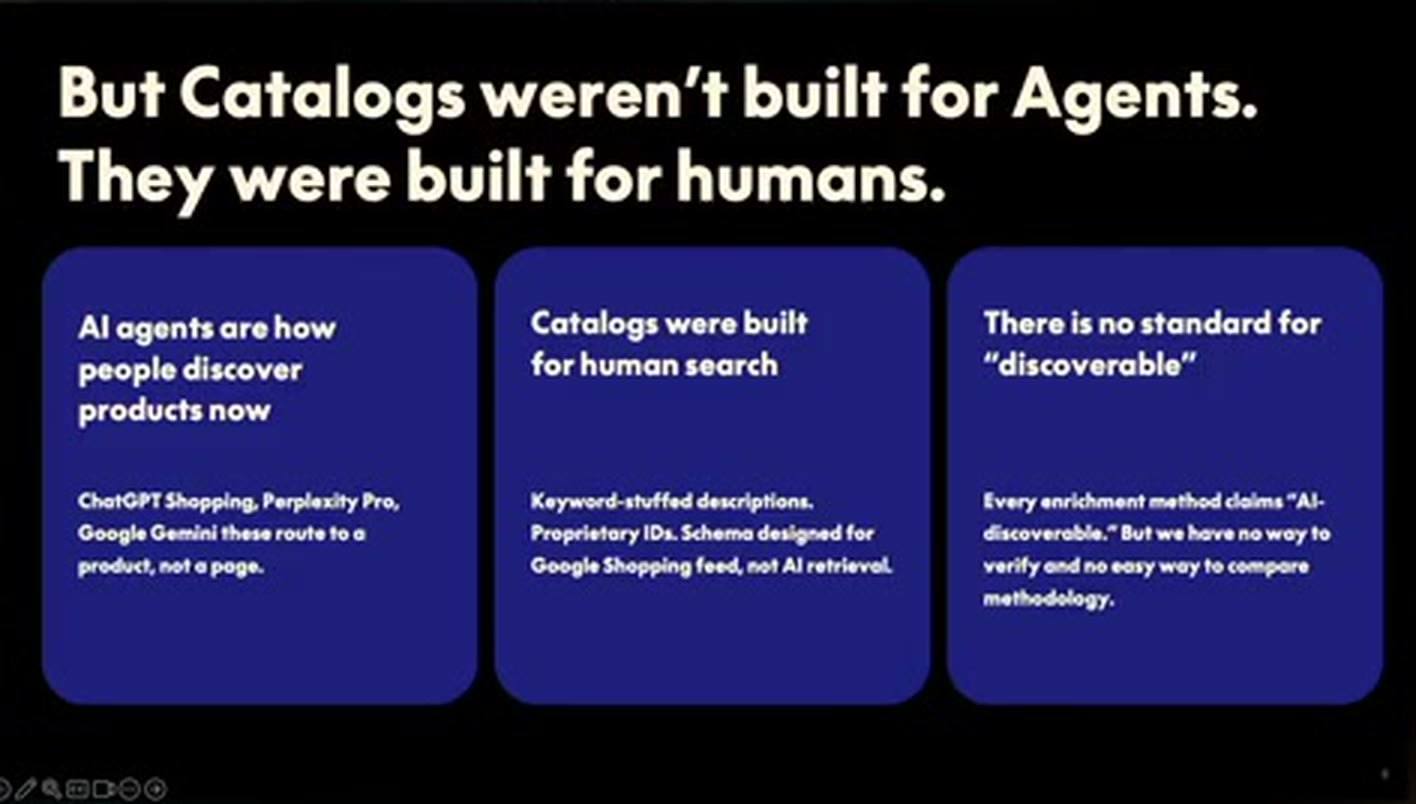 ▲ 图注:幻灯片「But Catalogs weren't built for Agents. They were built for humans.」三张卡:agent 把人导向一件商品而不是一个页面;目录里是关键词堆砌的描述、私有 ID、为 Google Shopping feed 设计的 schema;「可发现」没有标准,无从验证和比较。
更麻烦的是模型是黑盒,所以只能做实验
先对齐概念:关键词搜索精确但字面,语义搜索聪明但会失焦
- 关键词搜索(幻灯片标注 BM25,一种经典的按词匹配打分的算法):拿查询里的字面词去匹配商品文本里的词。搜 blue running shoes,只返回含这几个词的商品。优点是精确、快、可预期;盲区是抓不住同义词和意图——搜 footwear for jogging(慢跑穿的鞋)可能什么都不返回,只因为词对不上。 → 详细
- 语义搜索(幻灯片标注 Embedding/Vector,即把文字转成向量):把查询和商品都转成向量,按意思和意图匹配。输入「适合马拉松训练、穿着舒服的东西」能找到跑鞋,哪怕这些词一个都没出现。优点是懂意图、同义词和上下文。盲区,讲者口述是「注入太多含义,它会失焦、会产生幻觉」;幻灯片的说法更精确——当一个向量要代表太多文本时,它会失焦。 → 详细
- 讲者的一句话总结:关键词搜索「相当精确、非常字面」,语义搜索「聪明但很模糊」;现实里的答案不是二选一,而是两者结合,PayPal 用的就是混合方案(hybrid)。 → 详细
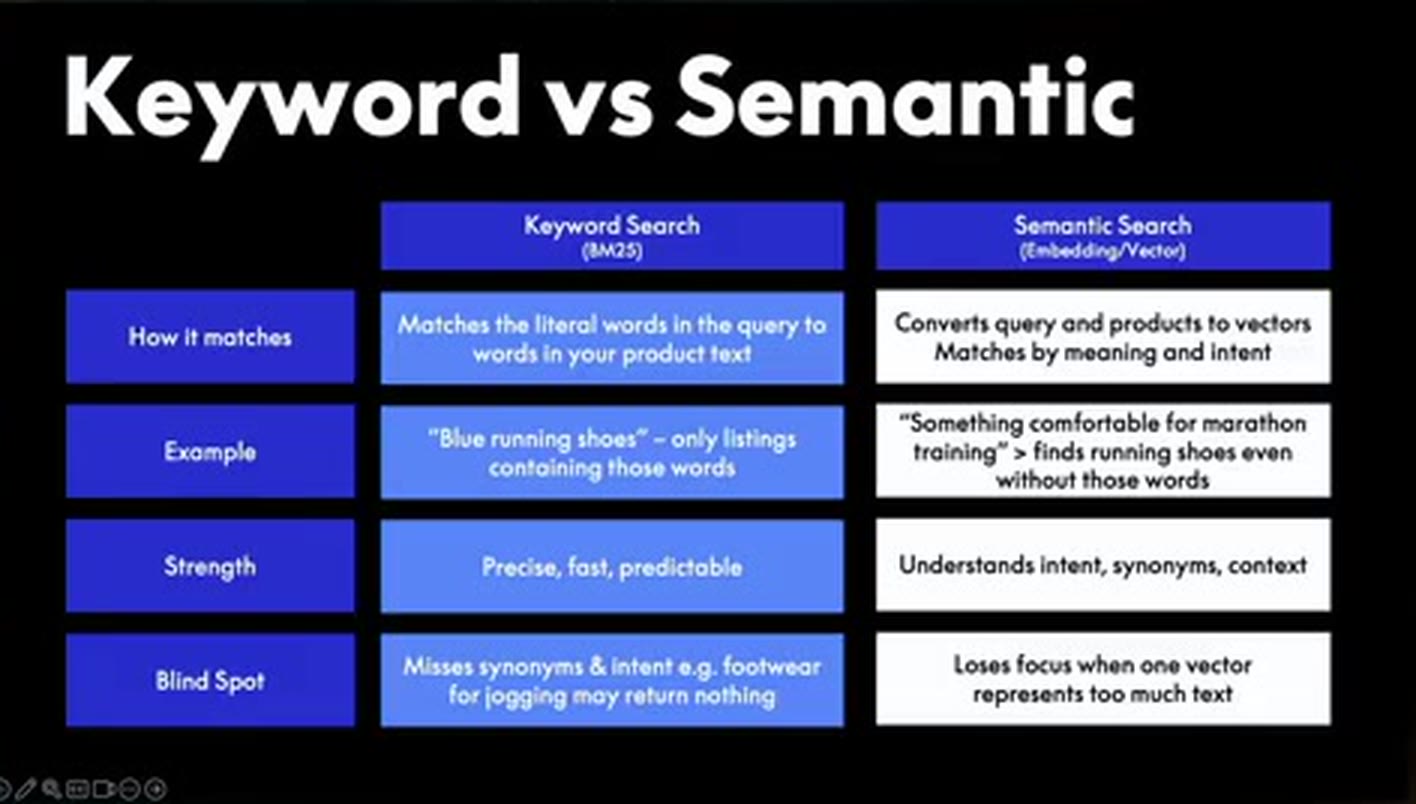 ▲ 图注:幻灯片「Keyword vs Semantic」四行对照:怎么匹配、例子、长处、盲区。关键词搜索(BM25)的盲区是漏掉同义词和意图;语义搜索(Embedding/Vector)的盲区是一个向量代表太多文本时会失焦。
富化没有唯一做法:五个数据维度,各有适用和不适用
- 讲者先立了一个前提:动手之前,先看清自己手上是哪种目录——是单薄的(thin catalog),还是偏重规格参数的(spec heavy)。富化不是一刀切,合适的做法取决于起点。实验把富化手法归成五个维度;讲者在台上只念了名字,下面每个维度的「做法、适合、不适合」来自幻灯片。 → 详细
- Attribute Fill(补全属性):补齐必填规格和类目特有的属性。适合规格稀薄的目录和小商家;对本来就很丰富的 feed 帮助不大。 → 详细
- Description Depth(描述深度):写出有内容的商品叙述,并交代使用场景。适合标题很泛的 SKU 和大路货;对已经紧凑、结构化的目录作用弱。 → 详细
- Buyer Context(买家情境):打上人群、场合、场景标签。适合生活方式、礼品、时尚类;对纯拼规格的商品作用弱。 → 详细
- Trust Signals(信任信号):评价、品牌的商品详情页、评分与情感倾向。适合家具、耐用品、电子产品;对限时促销和时尚类作用弱。 → 详细
- Product Identity(商品身份):规范化的实体,加上组级别的 ID(把同一款商品的各个变体归到一起)。适合多变体、多渠道的商品;对一次性的单品作用弱。 → 详细
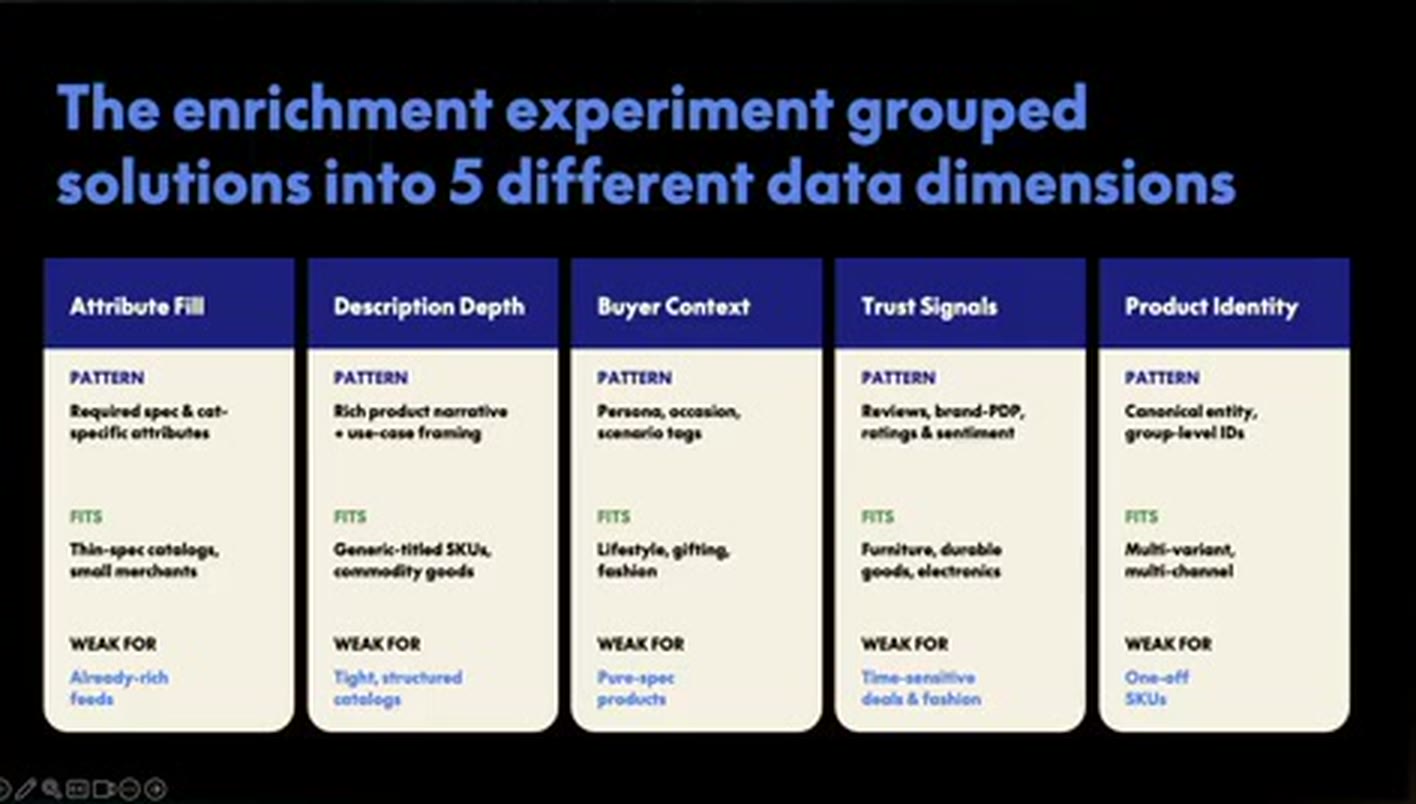 ▲ 图注:幻灯片「The enrichment experiment grouped solutions into 5 different data dimensions」:Attribute Fill、Description Depth、Buyer Context、Trust Signals、Product Identity 五列,每列写明做法(Pattern)、适合谁(Fits)、对谁作用弱(Weak for)。
一双跑鞋的前后对比
- 富化前:标题是 Men's Shoe 8543, Blue;描述是 Blue Running Shoe. Available in Multiple sizes;属性只有 Color: Blue。关键词搜索只对得上 blue、running、shoe 三个词;语义搜索拿到的上下文太少,只能做很弱的泛匹配。 → 详细
- 富化后:标题变成「男士轻量跑鞋,透气网面,蓝色」;描述写明缓震、透气,为长距离训练和日常慢跑打造,轻量网面让双脚保持凉爽;属性补上了用途(跑步、马拉松训练)、合脚度(尺码标准)、脚感(缓震)、材质(网面);还加进了评价数据(幻灯片上是 4.6 星、1,240 条评价)。 → 详细
- 结果:关键词现在对得上 running、training、mesh、lightweight、cushioned;语义搜索能为「适合马拉松训练的舒服鞋子」这样的问法找到丰富的含义。讲者点名这个例子用了三种手法:补属性、买家情境、围绕评价的信任信号。 → 详细
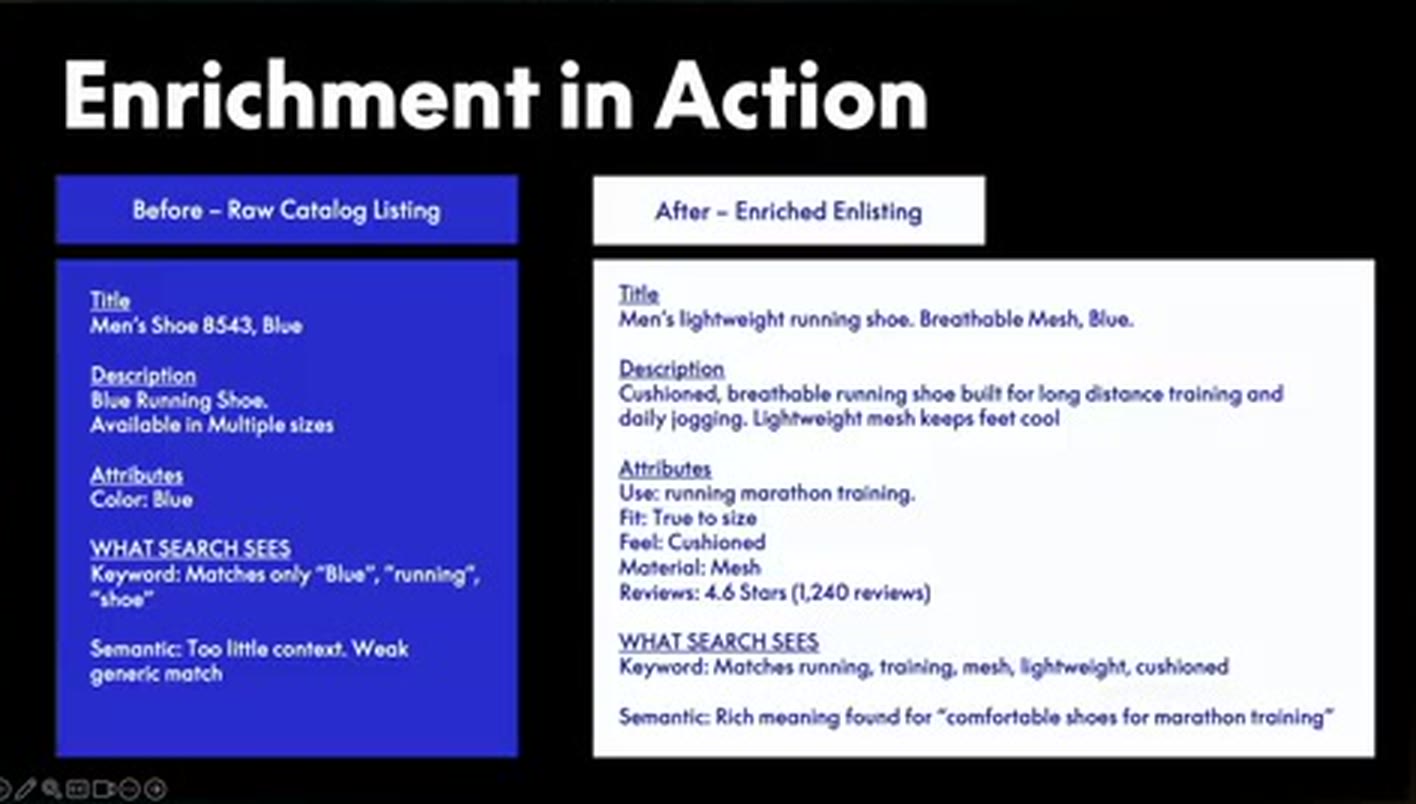 ▲ 图注:幻灯片「Enrichment in Action」:左侧是原始记录(标题 Men's Shoe 8543, Blue,属性只有颜色),右侧是富化后的记录(用途、合脚度、脚感、材质、4.6 星 1,240 条评价),两侧底部各写了关键词搜索和语义搜索分别「看到」什么。
实验结果:三条发现
- 发现一:富化提升关键词检索的命中。讲者说,没富化的基线在正面对比(head-to-head,拿富化后的数据和未富化的基线直接比)里「完全落在下风」。幻灯片的图是 BM25 Top 10,图例写着未富化 4.27、富化 8.89——幻灯片没有解释这个数的口径,结合旁注「在每个 top k 位置上,被检索到的富化商品都更多」看,比的是前 10 条结果。旁注还列了提升的三个来源:更长的文本命中更多关键词;长描述里用词更多样;从图片里提取出来的属性和段落。 → 详细
- 发现二:目录越单薄,收益越大。商品数据薄弱的商家,改进空间也最大。幻灯片是一张按商家排列的柱状图,蓝色是基线、绿色是富化带来的提升,横轴上约二十家,能认出 Newegg、Steve Madden、StockX、LEGO Shop、Temu 等(截图只有 360p,个别名字看不清)。 → 详细
- 发现三:非结构化的富化会稀释语义信息。讲者口述是「驱动结果的全在内容质量,而不是 schema;堆砌非结构化数据反而会稀释信号」。幻灯片的图是 Semantic Top 10,图例写着未富化 6.09、富化 3.87——在语义检索这一侧,富化版的数字反而更低。 → 详细
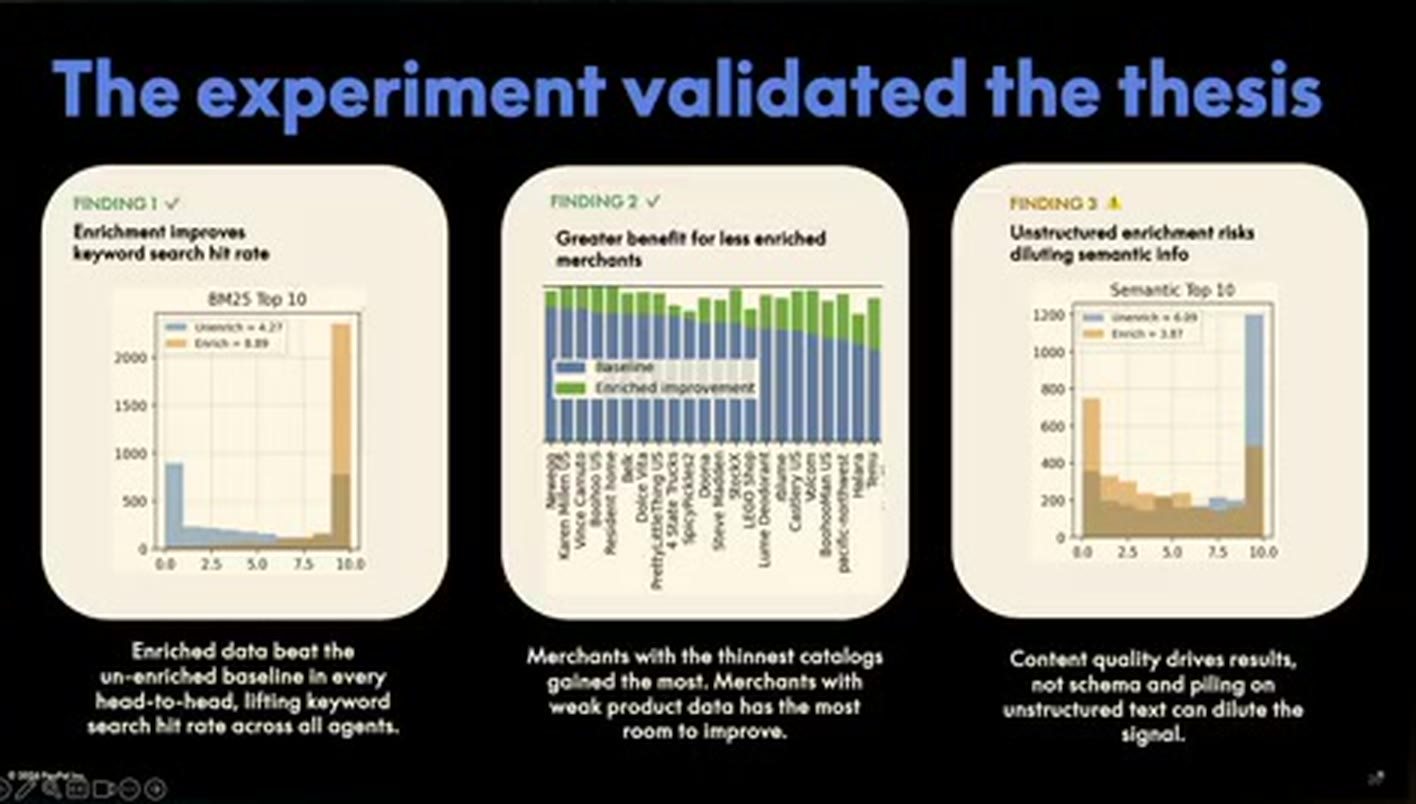 ▲ 图注:幻灯片「The experiment validated the thesis」:发现一,BM25 Top 10 图例未富化 4.27、富化 8.89;发现二,按商家排列的柱状图,越薄的目录提升越多;发现三(带警示标记),Semantic Top 10 图例未富化 6.09、富化 3.87。
为什么多写反而变差:一个向量装不下太多话题
- 讲者解释「非结构化数据」指什么:不是什么词都往上下文里塞,也不要放套话式文案,比如「欢迎光临本店」「我们是家族经营的企业」——这些对 agent 很多时候是无关信息。他的原话是:你怎么富化、往数据里结构化地放进什么,「非常非常重要」。 → 详细
- 幻灯片 Our learnings 给了口述里没有的机理:传统的富化策略单独用,不足以支撑语义检索,有时被检索到的富化商品反而更少。原因两条——长文本同时传达很多话题;单个语义向量要代表全部信息时会失焦。给出的设计含义是:agent 的商品发现链路必须配上额外的技术,才能把富化的好处吃全(幻灯片没有说是哪些技术)。 → 详细
- 口述和幻灯片有一处对不上,按原样记:讲者说「只要做了富化,正面对比里推荐效果总是更好」,收尾页也写着「所有数据点都显示它提升排名」;而语义那张图的图例是富化 3.87 对未富化 6.09。讲者紧接着补了一句——某些情况下过度富化时,agent 幻觉得更多、表现反而变差——没有进一步解释这两处怎么对上。 → 详细
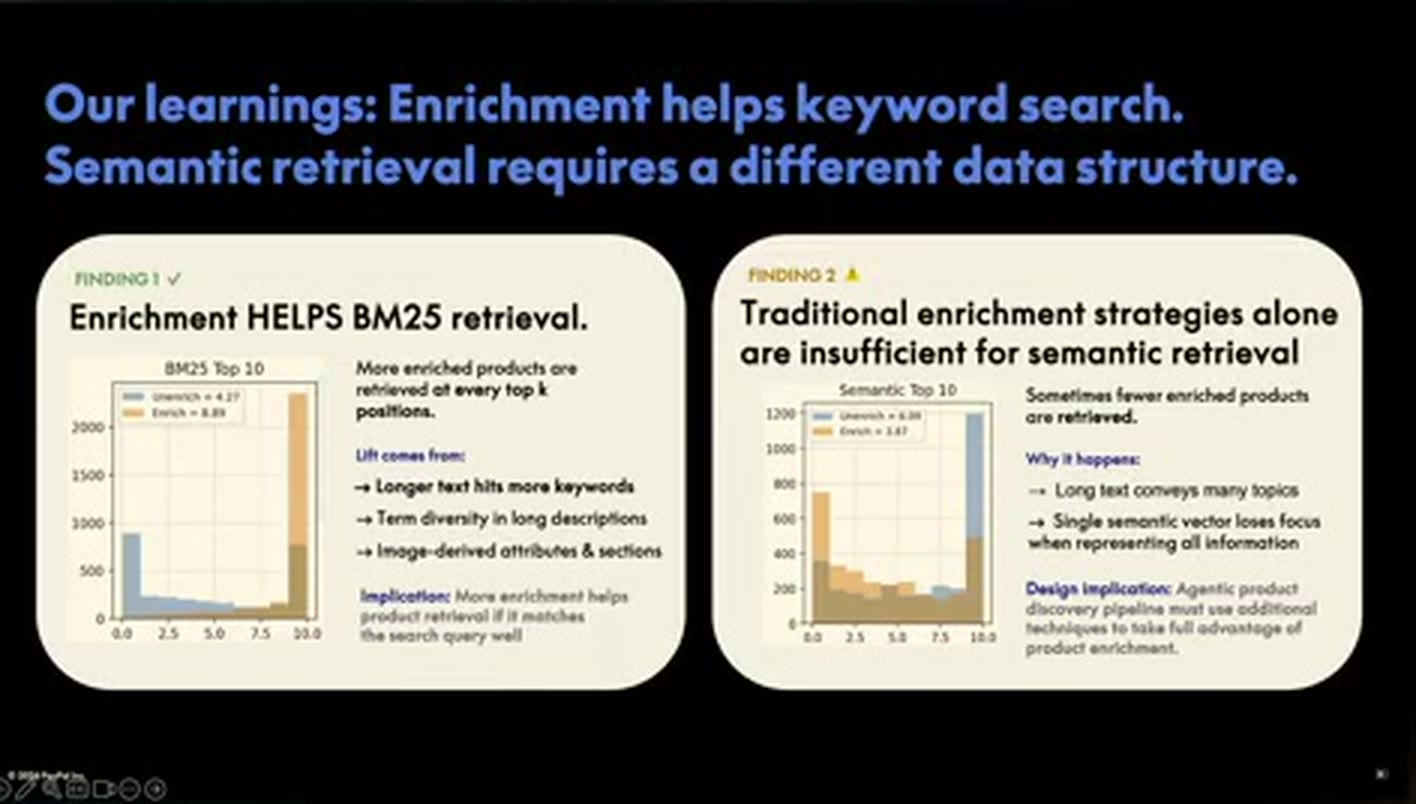 ▲ 图注:幻灯片「Our learnings: Enrichment helps keyword search. Semantic retrieval requires a different data structure.」:左侧写富化对 BM25 检索有帮助及三个提升来源;右侧写传统富化策略单独用不足以支撑语义检索,原因是长文本话题多、单个向量会失焦。
收束:三条结论,加一句「AI 奖励内容质量,不奖励品牌」
闪电问答 / 收尾
本期是单人演讲,没有闪电问答,也没有现场提问环节;讲者的收束已写在主题十三。结尾他请想了解 PayPal Agentic Commerce Services 的听众去 P11 展位。 → 详细
联系方式
- 讲者:Nixon Dinh,PayPal Agentic Commerce 产品总监。LinkedIn:https://www.linkedin.com/in/nixon-dinh/ (来自视频简介,台上未提)
- PayPal Agentic Commerce Services:https://developer.paypal.com/agentic-commerce-services/about
- Agentic commerce 文档:https://docs.paypal.ai/growth/agentic-commerce/overview
- 现场:AI Engineer World's Fair,PayPal 展位 P11。 → 详细