Anthropic 自己怎么用 Claude Code:别写 200 行 markdown,改用 HTML 写 spec
- 一模型越强,越要克制约束它:照搬 Richard Sutton 的「苦涩的教训」(the bitter lesson,指机器学习史上一再重演的规律——靠堆数据和算力的通用方法,长期总能打败人手工塞进去的「聪明规则」)——讲者原话是「往里灌入更多的数据、更多的算力,最终得到的能力会超过你能想出来的任何方案」,所以与其用人类智慧提前把系统硬编码、定死需求,不如承认「模型从你身上提取需求的能力,很可能比你自己定义需求的能力还强」,让 Claude 反过来用 ask_user_question 工具一轮一轮地采访你(interview),把潜藏在你脑子里、你自己都说不清的需求挖出来。→ 详细
- 二用 HTML 文件取代超长 markdown 做 spec 与 review:一位同事说 markdown 是「AI 原生软件开发生命周期的通用语(lingua franca)」,讲者觉得这话「挺有诗意」,但这种格式「有点受限了,它变得太长」——一旦超过约 200 行,你大概率就不会读了,你的同事就更不可能去读;HTML 信息密度高得多、对人更顺手,可点击交互、配截图、后续用 Playwright MCP 操作,这正是内容原作者 Tar 那篇博客《HTML 文件出人意料的有效性》(the unreasonable effectiveness of HTML files)的主张:从 markdown 往前走一步,改用 HTML。→ 详细
- 三把验证(verification)做成 agent-native、内建进产物本身:让 React 组件把自己的状态以 data-verify 等属性「发布(publish)到 DOM」,形成 agent 能直接读的「数据契约(data contract)」,这样 agent 就不用去爬(scrape)整个 DOM;同一套验证可在三个界面跑——人类可读 dashboard、agent 从浏览器经 Playwright MCP 驱动、CI 里
bun verify无头跑——还能把过程录成视频片段存 S3 当「验证通过的证据」,这就是 Tar 所在的 Claude Code 团队当前对所有前端改动的真实做法。→ 详细
讲者与场景:Anthropic 内部「我们怎么用 Claude Code」
讲者自我介绍叫 Ara,是 Anthropic applied AI 团队的架构师(architect),开场问全场「有谁特别喜欢 Claude Code」、笑说「那你们来对地方了」。这是一场现场满座(pretty full house)的 workshop,观众可「跟着一起写代码(code along)」。→ 详细 现场配套很实在:会拿到一些额度(credits)、扫二维码配环境、clone 一个 repo 跟着做,现场有人走动帮忙,讲者还特意确认了没有「完全没用过 Claude Code」的人。→ 详细 全场内容基于 Tar 大约一周半前在旧金山做的同一个版本,讲者点名问「有谁在 Twitter 上关注 Tar」;Tar 把那次内容写成博客《The unreasonable effectiveness of HTML files》,核心一句「我们要从 markdown 文件往前走一步,改用 HTML 了」。→ 详细 配套 repo 在 CWC workshops(Claude with Code workshops) 下、本场叫 "how we Claude Code",分三个阶段:基础、进阶、以及「相当有意思、也更深入」的验证部分;Anthropic 网站上还有很多关于 harness(驱动 agent 的外层框架) 和长时间运行 agent 的工程博客值得课后读。→ 详细
为什么必须改变工作习惯:agent 跑得越久,烧 token 的代价越大
因果链讲者讲得很完整:agent 能力越来越强 → 因为模型越来越强 → 模型更强则 agent 能跑更长、你也能交给它越来越复杂的任务 → 所以「我们得改变工作方式、改变习惯」。→ 详细 风险很具体:agent 跑很长一段,一旦「做错方向(does the wrong thing)」就可能烧掉大量 token,理想是「一开始就避免」。→ 详细 由此引出核心动作:把更多本由人做的验证「前置(frontload)」、塞进一个 HTML 文件里——相比 markdown,HTML 是「更丰富、对人更符合直觉(more human ergonomic)」的方式,让你提前接触 agent 即将构建的东西、提前纠偏。→ 详细
三个层次的总纲
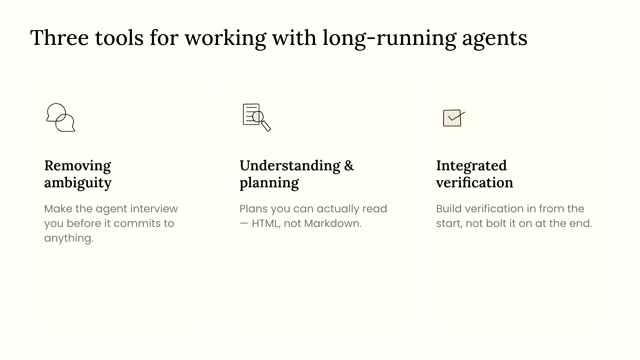
全场按由浅入深排三个层次:比较基础的(让 Claude 采访你、消除歧义)→ 进阶一点的(用 HTML 文件理解与做计划)→ 「相当有意思、也更深入」的(把验证做成 agent-native)。→ 详细 对应三段式工作流:prompting(让 Claude 反过来采访你)→ understand & plan(从 markdown 转向 HTML)→ verify(把验证内建进产物);讲者特意说不是要抛弃 markdown(「现在也还在用」),而是把信息「压缩进 HTML」。→ 详细 反复强调的是 verify(验证)而非 test(测试)——目标是让验证成为「这个东西本身自带的能力(native to the thing itself)」,使 agent 既能跟人一起驱动它、最终在无人值守(headless)下也能做;所以你产出的产物(artifacts)要被设计成「天生就可测试、可验证」。→ 详细
第一原则:模型越强,越要克制约束它(苦涩的教训)
- 讲者先现场调研「有谁听说过 Richard Sutton 的『苦涩的教训』」,再补介绍:Richard Sutton 基本上算「强化学习之父(the father of reinforcement learning)」,「如果你读一本关于强化学习的书,作者很可能就是他」。「强化学习」即让 AI 通过不断试错、拿奖励信号来自我提升的训练范式。→ 详细
- 「苦涩的教训」原话转述:「你可以花上所有时间,用你的人类智慧去提前把系统硬编码(hard code)、去约束它,但到头来,往里灌入更多的数据、更多的算力,最终得到的能力会超过你能想出来的任何方案。」 之所以「苦涩」,是因为它一次次否定了人类「我手工设计的精巧规则更聪明」的直觉。→ 详细
- 类比到 Claude Code,全场第一条原则:「你应该接受这个事实:模型从你身上提取需求的能力,很可能比你自己定义需求的能力还强。」 言下之意——别急着把需求一条条框死、硬塞给模型,那等于在重蹈「手工硬编码」的覆辙。→ 详细
- 配套金句把这层意思讲透:「需求是潜藏在你脑子里的(The requirements are latent within you)」——讲者打的比方是:就像你跟用户聊天,用户心里有个想法、「一看就知道是不是这个(know it when they see it)」,但往往说不清自己到底要什么;你自己也一样,「一看就知道自己要什么」,而 Claude 从你身上把「你想要、你需要的东西」提取出来的本事,很可能比你向 Claude 把它说清楚的本事更强。→ 详细
好 prompting vs 差 prompting:让 Claude 来采访你
- 差的 prompting:直接打 "make it better(弄好点)"、"make no mistakes(别犯错)"——讲者原话「我看到很多人用 Claude Code 时就直接打 make it better,那不是好的 prompting」。这类提示等于把所有判断都甩给模型,却没给任何可抓的方向。→ 详细
- 好的 prompting:核心是鼓励 Claude 从你这儿「提取出具体的细节」。具体三招:① 给出领域范围(give the domains);② 别把结果(outcome)过度指定死(don't overspecify the outcome);③ 转而指明你「关心的那些方面(the areas that you are interested in)」。讲者举例:可以「聚焦在受众(audience)上」,或者「用一种开放式(open-ended)的方式去引导回答,而不是一上来就把答案预先框死」——这样就能促使 Claude 一轮一轮地(iteratively)来采访你。→ 详细
- 关键机制:在 prompt 里明确点名
ask user question这个工具——讲者说「正是这个触发了整套流程(that's what triggers this workflow)」。而且「取决于你这个 prompt 写得多到位,你会得到更好的结果」。这把抽象原则落到一个可操作的开关上:想让 Claude 采访你,就在提示里显式叫它用 ask user question。→ 详细
现场演示一:用 AA 分账 app 让 Claude 采访需求
案例是一个 AA 分账 app(bill splitting app),场景「很简单」:跟朋友出去玩、想搞清楚谁该付多少;开始前他先对比了一下「你会怎么做、以及怎么能做得更好」,引出前面那套好/差 prompting 的对照。→ 详细 讲者把准备好的 prompt 复制粘贴进去(「等你们拿到 repo,会在里面看到其中一个这样的 prompt」),Claude 开始提问,用户用 Tab 键在各选项间切换回答:「我只想给朋友之间用」、问到「有没有次要受众(secondary audience)?」答「没有」;他再次强调 prompt 的关键就是「让 Claude 去用 ask user question」。→ 详细 提交后 Claude 就把那份 spec(对要做的东西的结构化描述)写出来,之后「可以转化成各种不同的方式来构建这个 app」。讲者点评效果:「它在一轮一轮地、越来越擅长从我这儿提取我真正想要的东西,而不需要我一上来就自己把所有事都说清楚。」→ 详细
模式与档位:fast mode、auto mode、effort 参数
- auto mode(自动模式,让 Claude 自动连续执行多步而不必每步都点确认):讲者先调研「有谁用 auto mode」,看到大家都举手后说「看到你们都用 auto mode,我太开心了……如果你还没在用 auto mode,那你真该用起来,它会让一切轻松太多了」;操作上用 Shift+Tab 循环切入,他直接断言「auto mode 是最棒的(the best)」。→ 详细
- effort 参数(决定模型为一项任务投入多少「思考力度」的档位):讲者调研「有谁会去设 effort 参数」,并给出官方口径——「我们的建议是用 X-high,不过你也可以设成 max effort」,他自己这次「大概是保持在 X-high」;操作上用斜杠命令
/effort设置。→ 详细 - fast mode(快速模式):用
/fast打开;现场调研发现用 fast mode 的人不多——讲者说「这正是我在这儿把它配好的原因」(特地现场演示给大家看)。三个开关的入口他也现场点了一遍:/effort是 effort 参数,/fast是 fast mode,auto mode 则靠 Shift+Tab 切进去。fast mode 的取舍他留到收尾才补:很棒、但更贵,胜在「快速迭代 spec」。→ 详细
为什么用 HTML 而不是长 markdown 做 spec
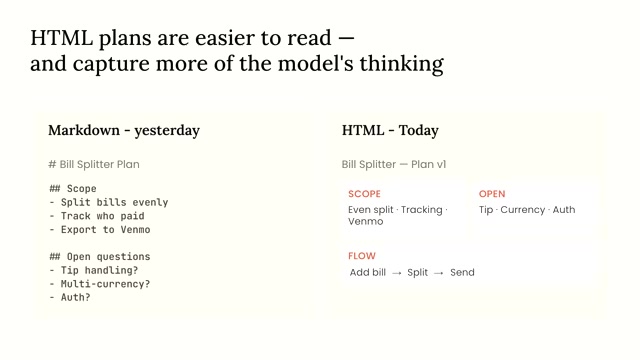
- 同事金句:「markdown 文件是 AI 原生软件开发生命周期(AI native software development life cycle)里的『通用语(lingua franca,意为跨群体共用的交流语言)』」——讲者觉得这话「挺有诗意」,但话锋一转:「这种格式好像有点受限了,它变得太长——要读的 markdown 行数太多了。」 所以他们想把更多信息「压缩进 HTML 文件里」。→ 详细
- 关键数字与论据:「尤其是当 markdown 文件长到超过差不多 200 行的时候,你大概率就不会去读它了,你的同事就更不可能去读了。」 反观 HTML——信息密度高得多(much more information dense)、对人更顺手(ergonomic),让你「更容易理解这东西最终会长成什么样」,还能点击交互、配上一张截图一起看,后续更可以用 Playwright MCP(一个让 Claude 通过标准接口去操控真实浏览器的工具)去操作它。讲者对比说:你能用「比一份超长 markdown 文件丰富得多的方式去跟它交互」。→ 详细
- 逻辑闭环:「你让一个 agent 跑得越久,spec 写得是否全面就越重要,而你越不可能在一开始就把所有东西都定义清楚」,所以更好的做法是以「跟 Claude Code 一起迭代」的方式来做;那么「什么是更好、更高效、更顺手的形态(form factor)呢?那就是 HTML 文件」。这把第二原则和第二节「agent 跑得久→烧 token」的风险扣回到了一起。→ 详细
演示二:用 Opus 4.7 生成四个 HTML 设计方向
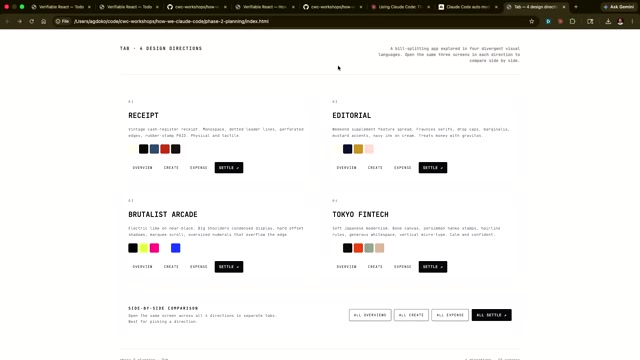
- 讲者预先让用 Opus 4.7 的 Claude 为分账 app 生成了例子(所用 prompt 也在 repo 里)。他给 Claude 的指令原话转述是:「给我几个不同的方向——四个不同的设计方向,去探索它们、把它们生成出来、做成 HTML,然后让它们互相参照、各自探索一下」。→ 详细
- 现场逐个点开,风格各异,讲者点名了两种:一个偏「粗野主义(brutalist,一种刻意粗粝、强调原始结构感的设计风格)」、一个「东京金融科技(Tokyo fintech)」——他评价「审美风格完全不一样」,而且每个都能「点来点去看(click around)」。→ 详细
- 价值说得很直白:「对我来说,拿这个去给 Claude 反馈,比起对着一个 markdown 文件去猜最终成品长啥样,要好太多了。」 而且可以进去截图、再把截图喂回给 Claude;讲者顺势调研「有谁会经常截图把信息提供给 Claude」,并鼓励「你们就该这么做,非常好」。→ 详细
用截图+视觉模型表达「说不清的前端问题」
痛点:做前端时常撞到语言表达的天花板——讲者原话「你很难用语言准确说清楚,比如这东西有点不对劲、这里有点没对齐,你会发现你很快就撞到语言表达能力的天花板了(run into the limits of what you can express)」。→ 详细 解法:Opus 4.7 的视觉模型(vision model,即模型「看图」的能力)比以前强多了,所以更适合「让它主动(proactively)从你这儿、从截图里把问题抽取出来」,而不是逼你用文字硬描述。→ 详细 讲者把这条当成该养成的习惯反复强调——「你们就该这么做」,尤其在前端场景;这也和第九节「截图喂回 Claude」连成一气:截图不只是给设计方向反馈,也是诊断前端 bug 的高效输入。→ 详细
最重要的部分:把验证做成 agent-native
- 讲者明确点题:全场「更重要的一部分,是怎么去验证 Claude 做出来的东西,以及怎么让它变得 agent native(原生适配 agent,即天生就方便 agent 来驱动)」——核心动作是把验证做成 artifact(产物)的一部分,内建进东西本身。→ 详细
- 用到的技术栈讲者一口气列全:Storybook fixtures(Storybook 是组件预览工具,fixtures 指预置好的测试用数据/状态)、一个测试库(testing library)、data emissions(数据发射,即组件把内部状态「吐」到外部可读的地方)与属性、再加上 Playwright MCP;对象是一个 React app,里面的组件「你们之前应该都见过,只不过被重新组合(remixed)了一下」,目的就是让 Claude 作为 agent 更容易从 DOM 里提取「数据契约(data contracts,指约定好的、外部可依赖的数据结构)」,然后跑验证、甚至把验证过程录下来。→ 详细
- 这正是 Tar 所在的 Claude Code 团队的真实做法,也是他那个 demo 所指的东西:它会生成一连串验证步骤,跑一遍、录下来,然后放到 S3(亚马逊的云端对象存储)上、或者用别的方式分享给同事。讲者点出收益与方法:「你需要亲自介入的点(touch points)就越来越少」,这是一种「可以复用的模式,尤其是在那种重建(rebuild)场景里」,而实现的办法是「合理地做模块化(sensibly modularize)」。→ 详细
演示三的对象:一个 React to-do app 与三种验证方式
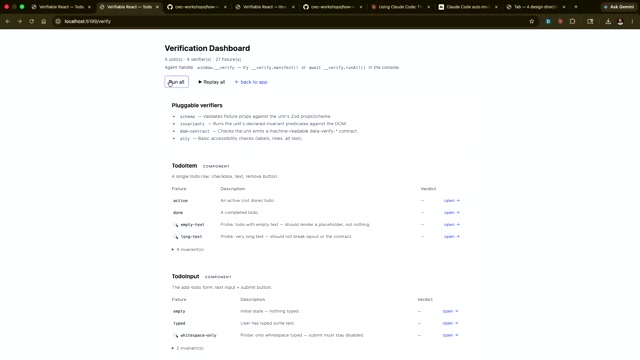
第三阶段(与分账 app 无关,是另一个上下文)是一个用 React 写的小型 to-do app:现场演示加一个条目 "test"、划掉、再拖动、还能「清掉已完成的条目」,并强调「从状态(state)的角度看,这里其实发生了非常多的事情」——状态变化多才适合演示验证;详细文档在 phase three 的 readme 和单独的验证细节文档里。→ 详细 三种验证方式明确列出:① 人类可读 dashboard;② agent 优先(agent first / agent driven)——从 Claude Code 或浏览器经 Playwright MCP 驱动;③ 完全无头(headless),比如在 CI(代码提交后自动跑检查的流水线)里;三者「原理是一样的」、只是入口不同。→ 详细 操作上直接在 repo 里运行 run verify / bun verify(bun 是一个 JS 运行时/工具链)就会跑那套「测试矩阵(test matrix)」;讲者提醒「从 repo 里跑跟在现场这儿跑,结果会略有不同,但原理是一样的」。→ 详细
核心机制:组件把状态发布到 DOM,形成数据契约
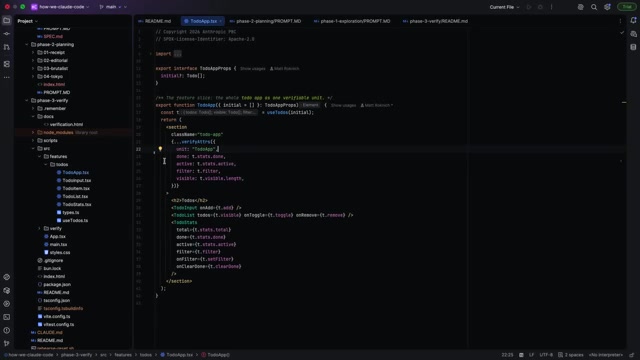
- 机制本身:组件把自己的状态以属性形式「发布(publish)到 DOM(即网页的文档结构树)」上;讲者现场指出具体的数据维度——data-verify 单元、total(总数)、done(已完成)、active(进行中)。他当场改状态演示:再加一个 "test",这些值就更新;再把它划掉,又更新一次,证明这些发布出来的数值是实时跟随状态的。→ 详细
- 好处:「这就是 agent 之后可以读取的东西,而不用去爬(scrape)整个 DOM」——「爬 DOM」指 agent 自己费劲地从一大堆网页元素里猜状态,既慢又脆;而直接读发布好的属性,又快又稳。→ 详细
- 设计要点:「如果你把状态在这里单独发布出来、跟 React 内部实现(internals)分开,你就能独立于 app 当前处于什么状态去跑验证」——也就是说验证不依赖 app 此刻是什么界面、停在哪一步,「这就是这套东西被设计成这样工作的原因」,而且「你在后续流程里也可以继续这么跑」。→ 详细
每个组件都带:schema、fixtures、known states、invariants、probes
- 每一个组件都配一整套东西,讲者逐项点名:会有 schema(数据结构的约定/模式)、fixtures(预置数据)、known states(已知状态),然后是 invariants(不变量,即任何时候都必须成立的约束条件)——他强调「这里有一些特定的不变量是任何时候都必须成立、必须 hold 住的」,而你用 probes(探针,指主动去戳一下、检验某条件是否成立的小检查)去测它们。→ 详细
- 关键技巧两条:① probes 要去「推它偏离 happy path(理想顺利路径,即一切正常、不出错的那条主流程)」——意思是别只测顺利情况,要主动制造异常去逼出问题;② 「这里面很多东西都会是由 Claude 生成、给 Claude 用的(generated by Claude for Claude)」,讲者说这是「一条进一步扩展规模(scaling)的路子」——让模型自己批量造验证,人就不必一条条手写。→ 详细
- 现场设计了一个硬编码(hardcode,即写死在代码里)的、一定会让验证失败的例子:流程是先让那个「人类验证的 dashboard」把它抓出来,然后也让 agentic(代理式)的方式同样把它抓出来,最后让 Claude Code 找到它并帮我们诊断(diagnose)——同一个 bug,三条路都能逮到,证明三种界面是对齐的。→ 详细
现场跑验证:故意失败的两个例子
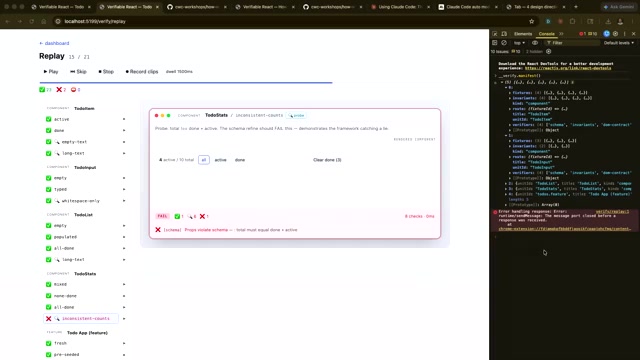
- 第一个故意失败:讲者在 dashboard 里把所有验证「全跑一遍(run all)」,结果「其中有一个会人为地触发失败,因为你之前埋了一个进去」;往下滚动找到根因——硬编码了「加总对不上」,3 + 4 在这儿不等于 10,状态对不上。讲者说每一项都「能看到它具体是怎么执行的细节」。→ 详细
- 第二个更狠的演示——「破坏契约但不破坏 app(break the contract but not the app)」:讲者去删掉 apps 下面 total stats(总计统计)那一块(并说「待会儿再撤销回来」),结果「下面这些验证全都失败了——不是因为我们把 app 弄坏了,而是因为我们破坏了那份契约」。这恰恰证明了「Claude 就能原生地去验证(natively verify)」:验证盯的是数据契约,而非 app 表面还能不能用。改完他用 Ctrl+Z 撤销、自动保存、重新跑,验证就恢复通过。→ 详细
- 跑验证这个动作的定位很微妙,讲者特意点明:「在这种情况下,我们跑这个不是为了执行验证,而是为了提供验证的证据(evidence)。」 也就是说,跑一遍的产出可以录成视频片段(clips,即抓取下来的运行录像),然后存起来、分享给同事、放到 S3 上当「这事确实验过、确实通过」的凭据。→ 详细
让 Claude headless 诊断 + 录屏当证据
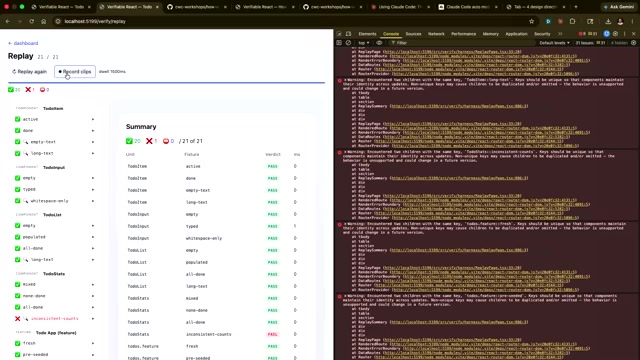
- 让 Opus 4.7 + Playwright MCP 以 headless(无头,即不靠人点界面、自动在后台跑) 的方式去找出那一项为什么失败:讲者说「我已经为此接好了 Playwright MCP」,跑出来结果是 「4 + 3 不等于 10」被拒(rejected)。→ 详细
- 一个重要且容易混淆的区分:「这次其实是故意把『验证』写错了,所以如果你去跑
bun verify,整个测试矩阵本身其实是会通过的」——讲者刻意制造这个反差,就是为了把三件事掰开演示:人类(在浏览器里手动)能做的事 / agent 以浏览器身份、用刚演示的那些命令能做的事 / 你能从 CLI(命令行)直接 headless 跑的事,三者是不同的层面、可能给出不同结果,要分开理解。→ 详细 - 录屏当证据是当前很普遍的做法:讲者两次强调——「Claude Code 团队基本上就是这么把他们做的所有代码改动都记录下来的,至少所有前端的改动都是,尤其是在我们现在这种发布节奏(pace of shipping)下」;他们内部还有一套「比我这儿演示的要更自动化」的版本,会真的把验证录下来,作为「一个常规节奏(regular cadence)的一部分」。最终产出是:每一段录像都可以全部下载、也可以单独下载,这「基本上就是那个证明验证确实通过了的成果包(bundle)」。→ 详细
三个界面收束 + 最终目标
- 把全场串起来,讲者收成三个不同的界面(surfaces):① 人类的界面;② agent 优先、从浏览器出发、用「同样的方式映射(mapping on the same way)」过来的界面;③ 你还可以直接在 CI 里用
run bun verify跑。一套验证逻辑,三个入口,互相对齐。→ 详细 - 最终目标一句话:「这里最终的目标是搞清楚:怎么把验证嵌入到产物(artifact)本身里面去。」 讲者再次号召大家去 repo 里「自己实际跑几个例子、跑几个测试,改代码、看看哪里会坏掉,再自己重新跑一遍」。→ 详细
- 真正新颖之处,讲者讲得很谦虚也很关键:「真正新的地方在于这种重新组合、重新编排(remixing / new arrangement)——把那些你已经熟悉、已经在用的基本元素(primitives)重新排布一下,让它们能优先服务于 agent(agent first)。」 而且这套东西「出现得相当快,大概一周半之前才进到这个 demo 里」,但已经是 Tar 和团队「已经在用的东西」。→ 详细
最终建议:用 Opus 4.7、配 fast mode、HTML spec 不更费 token
模型选择:强烈推荐 Opus 4.7——「Opus 4.7 之所以特别好用,是因为它的视觉模型更强,这正是它真正出彩的地方」,并明确「如果你用 Sonnet,我不太推荐」,再配 fast mode 来「快速迭代 spec」。→ 详细 回应一个常见质疑:「HTML 形式的 spec 不是更费 token、更不划算吗?答案往往是否定的」——理由是「从长远看,如果你有一份好的、内容丰富的 HTML spec,你迭代的次数会更少,哪怕单次生成它会多花一些 token」,一次性多花换长期少返工,总账更省;fast mode 的取舍也补全:「很棒,虽然更贵,但用来快速迭代 spec 非常合适。」→ 详细 收尾行动号召落到 repo 上:去看 repo(那里有「很棒的文档」)、自己跑几个例子和测试、改代码看哪里会坏、再重新跑,配合 Opus 4.7「你能从里面挖出很多东西」。→ 详细
闪电问答 / 收尾
(本场为单人演讲/workshop,无正式 Q&A 或闪电问答环节。)
过程中有少量现场互动、举手调研与收尾要点,一并记录:
- 现场举手调研口径很一致:几乎所有人都用过 Claude Code(讲者特意确认没有「完全没用过」的人);只有少数人用过 fast mode(所以讲者特地现场配好演示);多数人已在用 auto mode(讲者看到后说「我太开心了」);另有人举手表示在用 effort 参数、会经常给 Claude 截图。→ 详细
- 现场还有一句旁人插话的互动:有人问「如果你想这么做,你还可以把刚才说的那个结果记录下来吗?」讲者答「对」,并顺势演示了「延迟运行(delayed running)+ 一边跑一边录下来当证据」的做法。→ 详细
- 收尾原话:「That concludes really what I wanted to cover... I enjoyed speaking to you and thank you for your attention.」(我想讲的基本就到这儿了,很高兴跟大家聊这些,谢谢大家的关注。)→ 详细
联系方式
- 讲者:Ara,Anthropic applied AI 团队架构师(演讲中未给出社交账号/邮箱)。→ 详细
- 内容原作者:Tar,Claude Code 团队成员;讲者推荐在 Twitter 上关注他,并参考其博客《The unreasonable effectiveness of HTML files》及其个人 repo(「Tar 的 repo 里还有很多内容,你们也能在线上的 repo 里找到」)。→ 详细
- 配套资源:CWC workshops(Claude with Code workshops) 下的 "how we Claude Code" repo(含三个阶段、phase three 的 readme 与单独的验证细节文档)。→ 详细