我们如何打造一个会自我改进的 Agent——Zubin Aysola(Weights & Biases)
- 一W&B 工程师 Zubin Aysola 拆解自家刚正式发布的 ARIA agent 怎么评测、怎么自我改进(利益相关:ARIA、Weave 都是 W&B 的产品);他每晚睡前琢磨的难题是「benchmark、eval、agent 和它的配置全都一起变」,对策是让生产版和研究版 agent 逐字节一致,生产和离线的 trace 都用 Weave 按同一种格式记录,这样线上的任何一次运行都能原样搬回离线环境里做爬山优化。→ 详细
- 二评测这台机器这样搭:每道题是一份 YAML(起始条件 + 希望达到的结束条件),一共 886 道、按级别分类,开放给产品团队判断题目好不好;打分分「任务过没过」和「两个变体谁更好」两种;生产里每一次失手、每一次做对都会变成新题。他说打分是自己花时间最多的地方,而「轨迹才是真正的干货」。→ 详细
- 三现场演示「ARIA researches ARIA」把整条链路走了一遍:ARIA 把一条真实生产 trace 做成回归任务,查出沙箱里一个 SDK 调用没调对,跑多个变体、和生产版对标,最后的修法只是往 system prompt 或某个 skill 里注入一小段提示。他自称八个月没亲手写过代码,但 auto mode「并不能免除你去思考『我们到底想怎么改进』」;「从生产复现到仿真、再由 agent 定出改进模式」这条链路,是他最想留给大家的东西。→ 详细
讲者与来意:W&B 的 ARIA 周一刚正式发布,这场拆它的评测框架
- 讲者:Zubin Aysola,在 Weights & Biases(W&B,做机器学习实验记录与评估工具的公司)负责构建 ARIA agent——ARIA 在演讲当周的周一刚正式发布(GA,general availability:从内测转为所有人可用);他的同事 Tim 前一天在主会场也讲过。这场要深入讲两件事:W&B 评测和构建 ARIA 用的那套 eval(评测)框架,以及怎么让 ARIA 在「给自己做研究」的循环里自我强化。部分幻灯片来自他在 NeurIPS 上的分享(字幕听成 Nurups,按上下文应是 NeurIPS)。→ 详细
- 利益相关:这是 W&B 的工程师在演示自家产品——ARIA、Weave、W&B 平台都是他们的(W&B 的母公司是 CoreWeave)。下文「Weave 是最好的可观测性平台」这类评价是他本人的立场,他自己也加了「至少在我看来」。→ 详细
- 为什么自建 harness:harness 是套在大模型外面、管提示词 / 工具调用 / 循环的那层程序。他说在座多数人要么在自己搭 harness,要么在用 Claude Code 配各种形式打包的 skill;但同一个 AI agent,打包方式不同、配的工具调用不同,放到各种 benchmark 上表现差别相当大。受此启发,W&B 做了自己的 harness,让它在 W&B 平台里「替你做研究」。至于为什么要软件 agent、为什么要套一层 harness 而不是让大模型「放飞自我」想调什么工具就调什么,他说不必说服大家,没展开。→ 详细
他每晚睡前琢磨的难题:benchmark、eval、agent 和它的配置,全都一起变
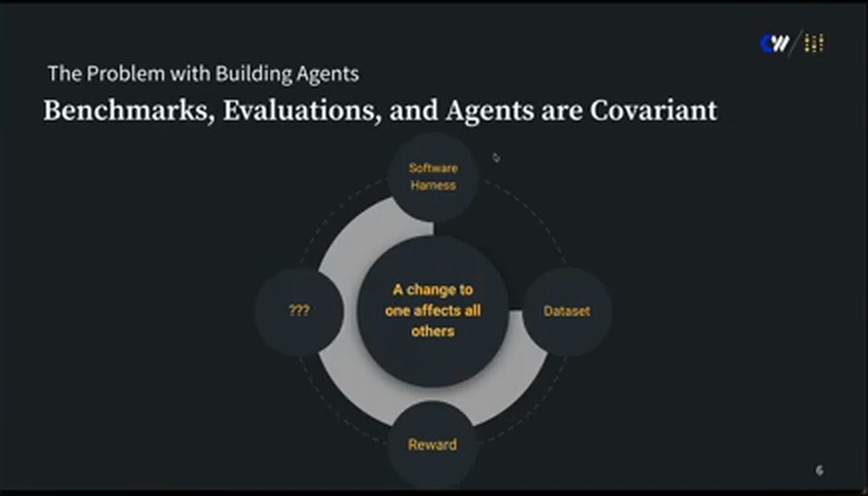 ▲ 图注:幻灯片「The Problem with Building Agents」,副标题是基准、评测和 agent 是协变的(Covariant)。环形图上四个节点:Software Harness、Dataset、Reward,外加一个问号;圆心写着「A change to one affects all others」(改动其中一个,就会影响其余所有)。这就是他每晚睡前琢磨的那个难题。
- 原话:「benchmark、eval、agent 本身,还有你怎么配置它们,这几样全都是相互牵连、一起变的」("…are all covariant"),他说这「基本上是我每天睡前都在琢磨的事」。所以想给任何一个动态变化的系统做严谨的 eval,就得有好的度量手段,才能看清「这个系统实际表现如何」。白话讲:agent 的配置在改、eval 任务在加、benchmark 本身也在更新,三样一起动,分数一变,你分不清是 agent 真变好了,还是尺子变了。→ 详细
- 生产和离线两头都要看:他要求同时看系统在生产环境(真实用户在用的线上版本)和离线环境(自己搭的仿真测试场)里的表现,并借强化学习的老概念打比方——sim-to-real gap(仿真到现实的差距:在仿真环境里练得好,搬到真实世界未必好)。这句开头字幕听不清,大意是「如果你早些年做过强化学习」。后面整套做法都从这里出发:离线环境要尽量贴近生产,生产里发生的事要能搬回离线复现。→ 详细
Weave:生产和离线用同一种格式记 trace,飞轮才转得起来
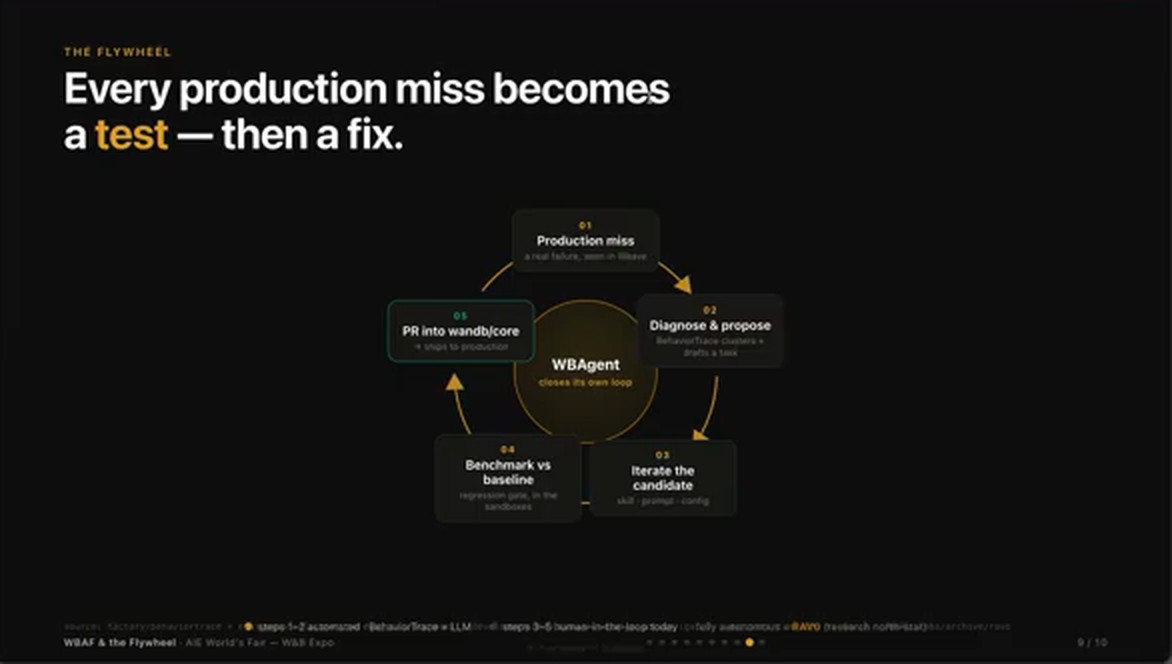 ▲ 图注:演讲后段的幻灯片「THE FLYWHEEL」:每一次生产失误都会变成一道测试,然后变成一次修复。一圈五步:生产失误(在 Weave 里看到的真实失败)→ 诊断并提出方案(BehaviorTrace 聚类,并起草一道任务)→ 迭代候选版(skill、提示词、配置)→ 在沙箱里和基线对比(回归闸门)→ 提 PR 进 wandb/core、上线到生产;圆心写着「WBAgent closes its own loop」(agent 自己把这个循环闭上)。
- Weave 是什么:W&B 面向 agent 的可观测性平台(observability:能看见 agent 内部每一步在干什么的监控能力),专门记录 trace(运行轨迹:agent 一次完整运行里每一步想了什么、调了什么工具、拿回了什么的逐步记录),生产和离线两边都能用。他的评价是:至少在他看来,这是目前做 agent trace 最好的平台。→ 详细
- 团队一分为二,记录格式一模一样:他和整个团队主要在离线侧——搭仿真环境、让 ARIA 在上面跑、在 Weave 里追踪,所以「我能从离线指标里看到我们所有的表现」;团队另一半在生产侧——部署 agent,并且「用一模一样的格式记录同样的东西」。正因为格式一样,他才能把生产 trace 直接「搬进」离线环境,拿来做爬山优化(hill climb:每次小改一点、变好了就留下,一步步往更好的方向爬),或者用来排查错误。他管这叫「一个挺漂亮的飞轮」。→ 详细
- 飞轮最后交给 agent 自己转:他说 ARIA 现在「已经足够成熟」,能自己完成离线爬山优化,所以「现在我们基本上就是用它来构建它自己」。这就是标题里「会自我改进」的具体含义:ARIA 在这套离线 eval 框架里替自己跑研究、写新变体(后面会看到,改的主要是提示词和 skill,而不是去训练模型)。→ 详细
现场演示「ARIA researches ARIA」:一条提示词让 agent 给自己做 autoresearch
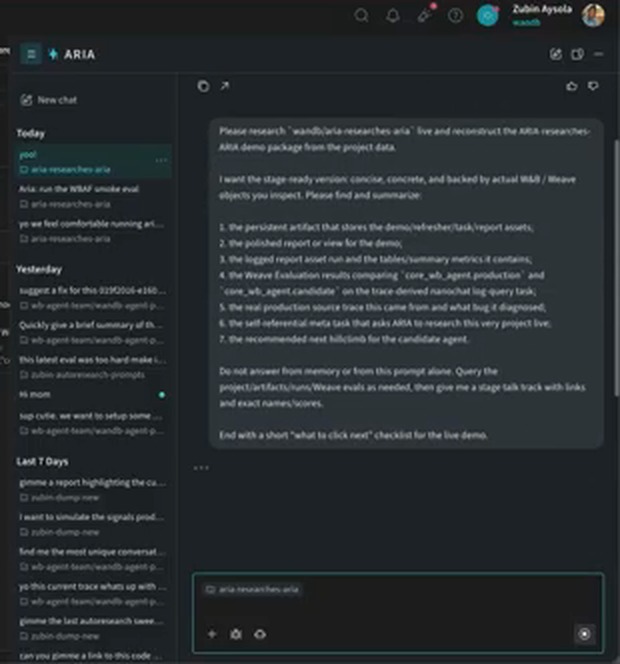 ▲ 图注:W&B 平台里的 ARIA 侧边聊天,发出的就是那条长提示词:让 ARIA 现场研究
wandb/aria-researches-aria 项目、重建这场演示的材料包,列出 7 项要找的东西(其中有生产版 core_wb_agent.production 和候选版 core_wb_agent.candidate 在一道由 trace 衍生的 nanochat 日志查询任务上的 Weave 评测结果、来源生产 trace 及诊断出的 bug、候选版的下一步 hillclimb),并要求别凭记忆回答,去查项目、artifact、run 和 Weave 评测。左栏历史会话里能看到「Aria: run the WBAF smoke eval」。
- 演示项目就叫「ARIA researches ARIA」:他在 W&B 平台里直接跟 ARIA 聊,让它给自己做一轮 autoresearch(自动研究:让 agent 自己读材料、提改动、跑实验、看分数)。用的提示词比较长,是他在另一个会话里让 ARIA 自己生成的。同批 253 用的是另一种 autoresearch 循环(只许改一小块策略面、分数涨才保留),可以对照着看。→ 详细
- 这条提示词让它做四件事:拿他的代码库——它作为一个 W&B artifact(W&B 里按版本存档的文件包)记录在案,本身就是他们的离线 eval 框架;针对这个代码库启动训练任务;复盘手上的生产 trace;再加一些新任务作为爬山目标。eval 要跑一阵子,之后就能看到 ARIA「在尝试给自己写一个新的变体」。→ 详细
- 等式的另一边是生产侧:他调出 ARIA 内部 trace 的脱敏视图,很快正在进行的这段对话本身也会出现在里面。他顺势现场演示第二件事:新开一个 ARIA 标签页,直接说「把这条 trace 记进我们的离线 eval 里,然后让候选版本和生产版 agent 都在上面跑一遍」(打错几个字也无所谓),eval 边跑边记录进 Weave。他自己也说这「多少有点自我指涉」。→ 详细
他每天的工作就是这一圈:看生产 trace → 跑离线 eval → 部署新版本
- 原话:「这基本就是我每天日常工作的浓缩版」——在 Weave 里看生产 trace,在代码库(也就是离线 eval 沙箱:隔离出来、怎么折腾都不影响线上的测试环境)里跑 eval,然后部署新版本的 agent,并和团队一起把这些事做下来。→ 详细
- 七周的夜间 CI 记录:生产项目里存着过去七周每晚 CI(持续集成:每晚自动跑一遍的检查与测试流程)积累的一大批 trace——每晚既评测生产形态的 agent,也评测团队切出来的其他候选变体,所以能看出相对表现随时间怎么变。其中有一阵 CI 挂了,「昨晚还得让 ARIA 自己把自己修好」;总体上在部分任务上「大概能拿到 66% 左右」。他们训练 agent 做的任务有很多种。→ 详细
做 skill 而不是做强化学习,但照搬强化学习那套搭环境的严谨
生产版和研究版 agent 逐字节一致:两边互为镜像,不许漂移
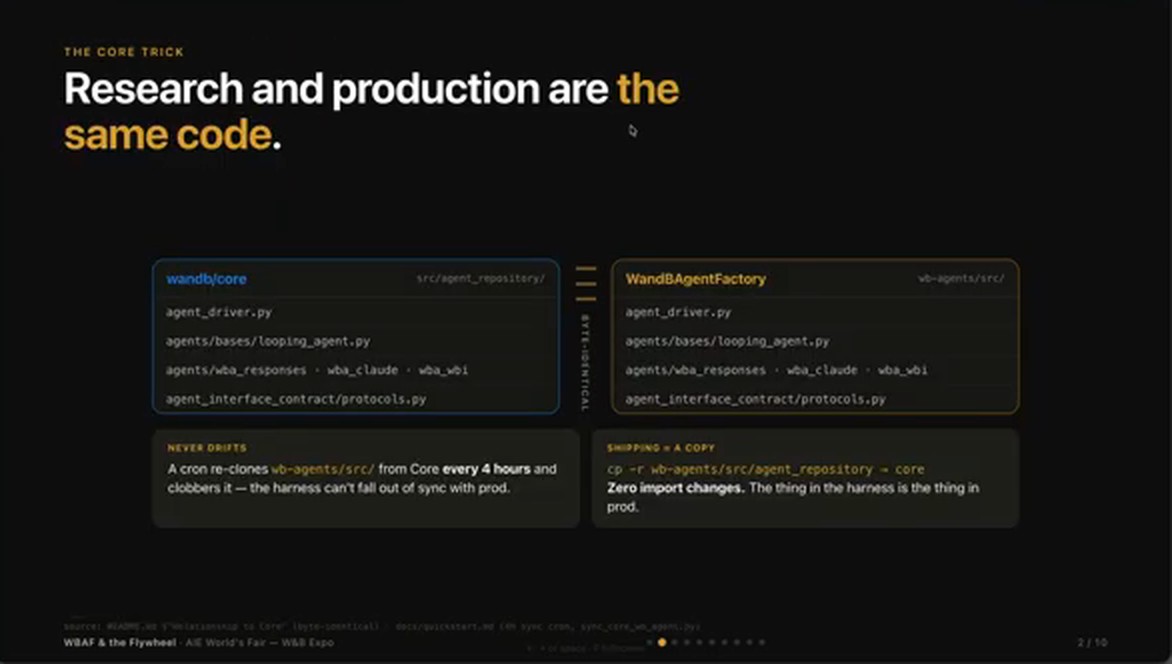 ▲ 图注:幻灯片「THE CORE TRICK」:研究代码和生产代码是同一份。左边是 wandb/core 里的
src/agent_repository/,右边是 WandBAgentFactory 里的 wb-agents/src/,中间标着 BYTE-IDENTICAL,两边列着同样的 agent_driver.py、agents/bases/looping_agent.py、agents/wba_responses · wba_claude · wba_wbi、agent_interface_contract/protocols.py。下方两行:NEVER DRIFTS,一个定时任务每 4 小时从 Core 重新克隆一次并直接覆盖,harness 不可能和生产脱节;SHIPPING = A COPY,上线就是把目录原样拷回 core,一行 import 都不用改。
- 原话:「我们会在生产环境和仿真环境里,对逐字节一致(byte-wise identical)的同一版 agent 做 benchmark」。一方面靠 Weave 的日志框架,一方面靠系统本身的设计方式,他们的研究代码和生产代码「是完全一样的」。→ 详细
- 靠同步任务防漂移:从生产环境到研究环境还有一个同步任务(原话 "a 4-hour sync job",口头没说清是频率还是时长;幻灯片上写的是定时任务每 4 小时从生产代码库重新克隆一次,见上图),为的是研究员切 agent 新变体、写新 skill、做爬山优化时「不会出现任何漂移」(drift:两边代码悄悄变得不一样,离线测出的结论就套不回线上)。→ 详细
- 结果是一个很紧的小循环:技术栈两侧——部署层和离线 benchmark 层——「基本互为镜像」。回到开头那个「几样全都一起变」的难题看:把 agent 本身钉死成两边一模一样,离线分数的涨跌才能归到你刻意做的那个改动上,而不是归到两套环境的差异上。→ 详细
- 小插曲:他说幻灯片上字很多,是「我和 Claude 一起随手糊出来的」,所以大家只看图就好。→ 详细
先攒海量 trace,再决定拿它们做什么:人工看,或者让 ARIA 复盘自己
- run eval 命令产出分数轨迹:团队内部开放了一堆 run eval 命令,专门生成分数轨迹;前面那个大项目里就是一大堆轨迹样本,点开任意一条,能看到它在各种指标上的相对得分。本质上拿到的是 agent 一次次运行留下的「非常扎实的 trace」,「从里面能挖出大量信号」。→ 详细
- 核心思路(原话):「先生成海量 trace,然后在搞清楚 agent 表现如何的过程中,再决定拿这些 trace 做什么」。理由是「你在度量的是涌现出来的特性,然后试着把 agent 往特定方向上对齐」——agent 会冒出什么行为事先想不全,所以先把每次运行全记下来,要问的问题留到事后再定。→ 详细
- 两种复盘法:一种是他手动去看这些任务;另一种是让 ARIA 复盘它给自己跑出来的那次 rollout(一次完整运行),或者复盘别的某次 rollout,判断「哪里出了问题、哪里做得好」,再「通过 prompt 或者别的手段去强化这些行为」。→ 详细
agent 背后的方法其实很简单:不绑模型的软件栈,加上用 YAML 批量造变体
- 不绑定具体模型:他们要在各种模型上做测试——既有通过 CoreWeave(W&B 的母公司)推理服务提供的模型,也有各家基础模型厂商的模型——所以定义了一套相对不绑定模型的软件栈,统一规定怎么做上下文压缩(compaction:对话太长时把旧内容压成摘要腾地方)、怎么准备上下文、怎么组装给界面用的数据包(UI payload)。→ 详细
- 让「变异」便宜到随手就来:背后的思路是「要让同一套配置衍生出大量变异版本这件事变得非常非常简单」——用 YAML(一种人和机器都好读的配置文件格式)定义 agent 的不同配置,一次得到多个并行变体,全部测一遍看看会发生什么,「因为最终你总能从中看出怎么把问题做得更好」。→ 详细
- 一句老话:借老派强化学习训练、或者说普通模型训练里的一句话——「实验多跑总比少跑好」,他说这也正是他们这套 agent harness 背后的核心思路。→ 详细
给 agent 一个「想干什么都行」的沙箱:它自己搭环境、并行跑自己
仿真环境怎么批量生成:配置 → 填数据 → 搭环境 → 热补丁 → 跑 → 打分 → 拆掉
- 一条通用流水线:幻灯片上有一行「six phrases per record」,他自己也说不太确定是什么意思;他要讲的是「一套生成这些仿真环境的好模式」——一个相对通用的 DAG(有向无环图:一步接一步、不走回头路的任务流水线),可以按传统机器学习的思路去理解。→ 详细
- 前五步:① 拿一份配置,也就是 YAML 文件;② hydrate(填充数据),把需要的实时数据加载进来;③ 搭环境——在 W&B 这一步成本相对高:有大量生产数据要拿来测,而且都是完整的机器学习训练日志,做 autoresearch 时可能还得模拟 GPU 执行,很吃资源,所以要并行;④ rehydrate(二次填充):很多运行时配置没法写进 YAML,就用热补丁(hot patch:不重建环境、直接把改动打进去)的方式打回配置里;⑤ 跑 agent——「跑 agent 本身是最简单的一步」。→ 详细
- 最后两步:⑥ 用和生产逐字节一致的版本跑完后打分;⑦ 如果是并行跑,跑完就把环境拆掉,好重新开始,也免得把队友的工作覆盖掉。→ 详细
打分是他花时间最多的地方:先问评测本身健不健康
- 原话:「打分是我花时间最多的地方」——基本上就是在琢磨衡量结果的方式到底够不够稳健。他认为一旦把跑评测的配置定下来,就「真的很值得花时间」想一想 eval 本身够不够稳健。→ 详细
- 一条让他开心的 Slack 消息:演讲当天,一个队友发来一条 Slack 消息(他说大概没法投到屏幕上给大家看)——这位队友把前一天一整天都花在琢磨两件事上:评测的健康状况,以及评测和生产环境之间的漂移。他说这种思维模式非常有用:「事情为什么顺利、为什么不顺利?这两者之间我们看到了哪些差距?」白话讲:评测题如果慢慢和线上用户真实在做的事对不上,分数再高也说明不了线上会变好。→ 详细
- 两种打分方式:ARIA 给自己打分分两种——规范性打分(normative),就是任务过没过;相对打分(relativistic),比如设定两种风格,一个变体会向用户提问、另一个不提问,再通过相对比较看哪个表现更好。他说从强化学习的角度看,这是「相当传统的一种设定」。演讲时好几个队友正在这个项目里跑 eval。→ 详细
eval 任务长什么样:YAML 写起点和终点,886 个任务开放给产品团队把关
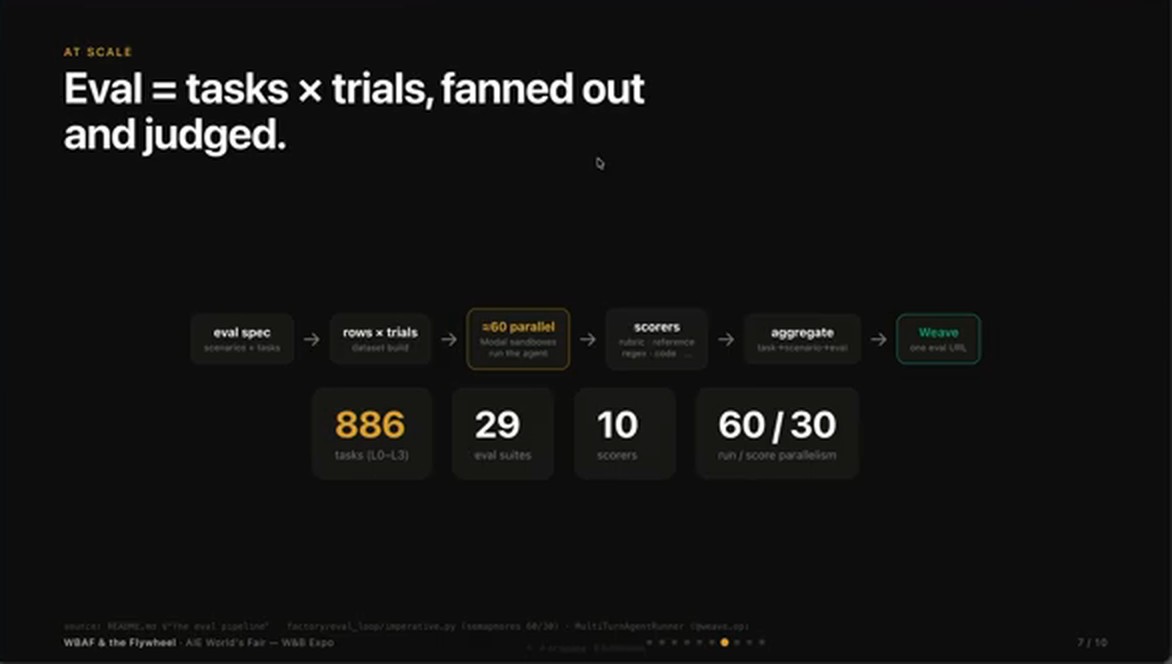 ▲ 图注:幻灯片「AT SCALE」:评测 = 任务 × 重复次数(trials),并行展开再打分。流水线依次是评测规格(场景 × 任务)→ 按重复次数展开成数据集 → 约 60 个并行的 Modal 沙箱跑 agent → 打分器(评分细则、参考答案、正则、代码等)→ 汇总 → 落成一个 Weave 评测链接;数字卡写着 886 个任务(分 L0–L3 四级)、29 个评测套件、10 个打分器、跑 60 / 打分 30 的并行度。
- 一条任务 = 起点 + 终点:eval 任务就是一份份 YAML 规格——定义环境的起始条件,外加一堆用户配置,再加一个「我们希望最终达到的结束条件」。在 W&B,任务就是用户的使用流程(flows from users)。→ 详细
- 怎么模拟用户:他说有三种方式,全文里讲清楚的是两种。一种是简单文本,就是给 ARIA 的一条指令——比如刚才对话里生成的那条「把一条生产 trace 记进本地框架」的任务,实际看起来就只是他问的一个简单问题,对 ARIA 来说就是单独一问;另一种是模拟一个带着某位用户人设(persona)的语言模型,跟它说「假装你是这个用户,按特定顺序问某些问题」,这样就能模拟多轮对话,模拟用户和 agent 之间的来回交互。→ 详细
- 886 个任务,产品团队来把关:「然后就是把这些跑上一大堆」——他们一共有 886 个任务,按级别分类,而且开放给产品团队,「让他们来判断这些任务够不够好、有没有反映我们在 benchmark 里关心的东西」。也就是说,考题出得对不对,由产品的人来判断,而不是工程师自己出题自己考。→ 详细
- 每道题跑很多遍:任务定好之后,「我们就把它们跑上很多遍」,呼应前面那句「实验多跑总比少跑好」。→ 详细
「轨迹才是真正的干货」:线上每一次失手、每一次做对,都变成一道新考题
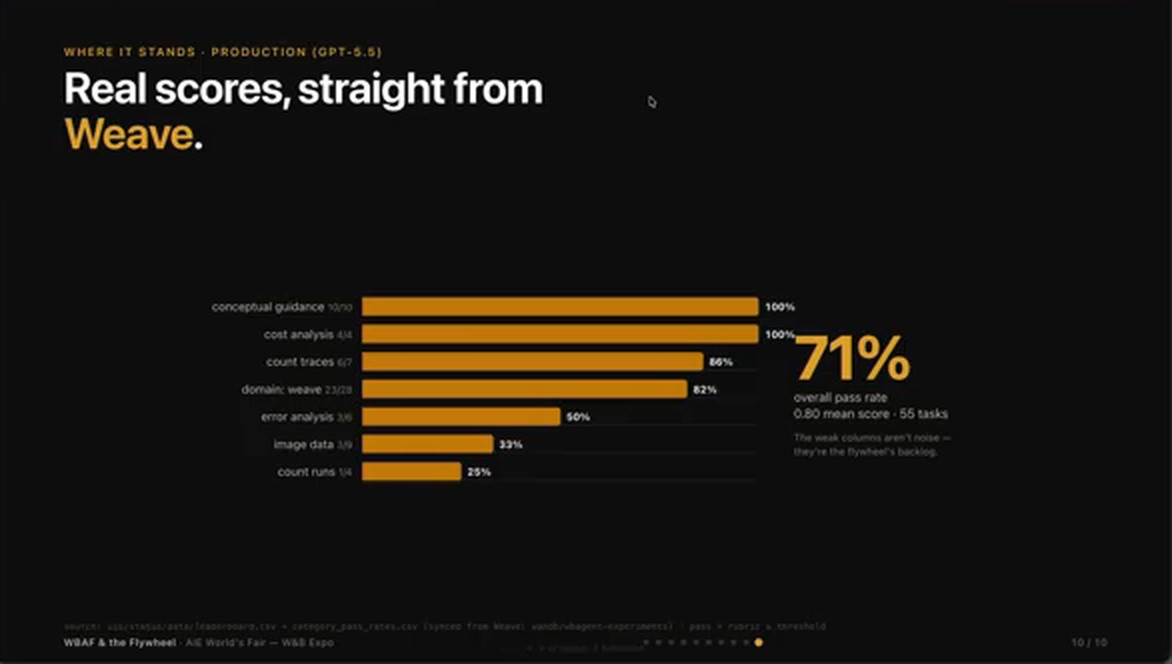 ▲ 图注:幻灯片「WHERE IT STANDS · PRODUCTION (GPT-5.5)」:真实分数,直接取自 Weave。按类别列出通过率:概念引导 10/10(100%)、成本分析 4/4(100%)、统计 trace 6/7(86%)、Weave 领域 23/28(82%)、错误分析 3/6(50%)、图像数据 3/9(33%)、统计 run 1/4(25%);右侧汇总是 55 个任务、总通过率 71%、平均分 0.80,并写着弱的那几列不是噪声,而是飞轮的待办清单。
- 原话:「说到底,这里最核心的是轨迹(trajectory)——那才是真正的干货,也是我天天泡在里面的数据」("the trajectory is like the meat and the data that I live behind")。他会同时看流量里的生产 trace 和离线 trace,想办法把两边的行为模式都利用起来;为此团队自己做了理解 trace 的工具,比如一个在生产和离线两边都在跑的 behavior trace(行为轨迹)项目。→ 详细
- 这就是 eval 飞轮:「生产环境里的每一次失手——还有每一次表现好的地方,因为我觉得往正向做爬山优化也很有用——都会变成我们 agent 框架里的一个任务」,他们靠这些来定义这个 agent、让它变得更好。注意他连「做对了的」也收进题库:不只修错,也把好的行为固定下来、继续往上推。Uber 也把 session trace 接进了基准测试和自我改进循环(见 ep195)。→ 详细
- 真实分数与短板:他展示了直接从 Weave 里拿出来的真实分数,按一大堆不同类别衡量自己。他的判断是 ARIA「很擅长在概念层面给你引导」,希望它在「给项目做错误分析」这块做得更好;任务会尽量设计得越难越好,「真正考验一下这东西的成色」。→ 详细
演示结果:ARIA 从一条生产 trace 里揪出 SDK 调用问题,自己出题、跑变体、和生产版对标
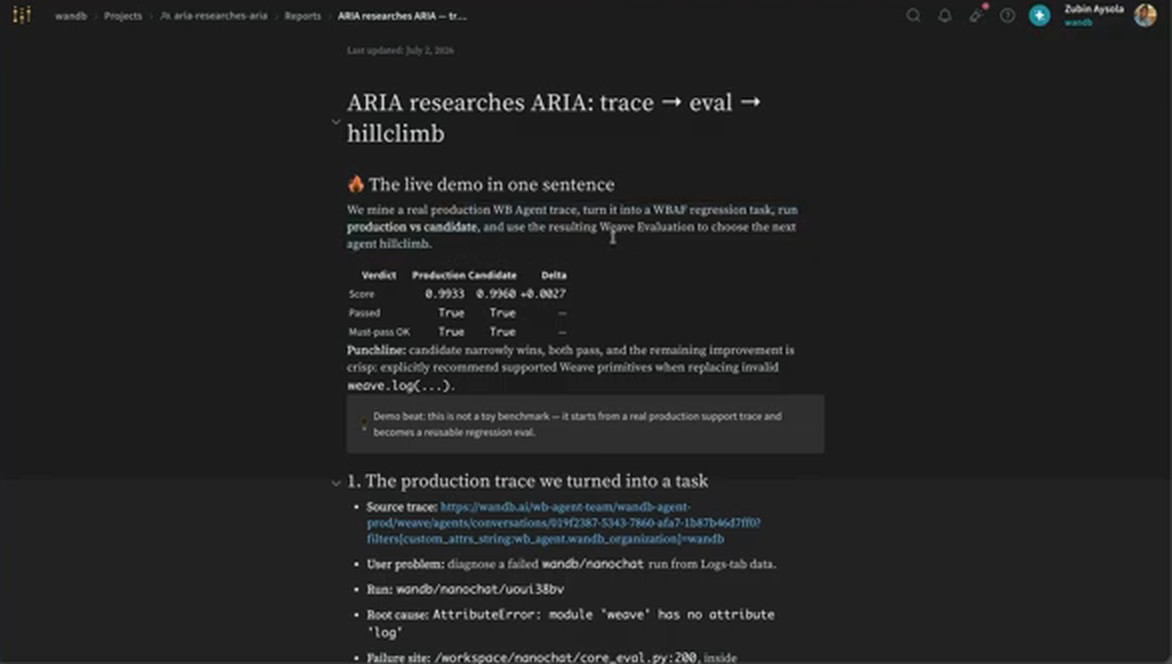 ▲ 图注:ARIA 自己生成的 W&B 报告「ARIA researches ARIA: trace → eval → hillclimb」,一句话概括是:挖出一条真实的生产 trace,做成 WBAF 回归任务,让生产版和候选版对跑,再用 Weave 评测结果决定下一步怎么爬山。结论表里生产版 0.9933、候选版 0.9960、差值 +0.0027,Passed 和 Must-pass OK 两栏都是 True;被做成任务的那条 trace,是用户想根据 Logs 页的数据诊断一次失败的 wandb/nanochat run,根因是
AttributeError: module 'weave' has no attribute 'log',出错位置在 core_eval.py 第 200 行;报告的要点是把无效的 weave.log(...) 调用换掉。
- 它给自己出了一道题:演讲还剩五分钟时,他回到那条长提示词触发的演示。ARIA 列出了它跑过的研究 run,他还让它用 W&B Reports(W&B 的报告功能)把这次 run 写成一份报告。拖动进度能看到它刚记录进来的最新一条生产 trace——「它给自己写了一个新任务,跑了一遍,然后打了分」,相当于生产版在这道具体的题上做了一次 benchmark。→ 详细
- WBAF:他搭的那座「agent 工厂」:报告里写着,它拿一条真实的 agent trace 做成了一个 WBAF 回归任务(regression task:专门盯住「修好的问题别再犯」的测试题)。WBAF 是 Weights & Biases Agent Factory,「就是我搭的那个工厂」,也是他们离线基准测试背后的核心。→ 详细
- 诊断 → 复现 → 定爬山目标:ARIA 找出的问题是,在沙箱里没有正确调用 weave.log 这个 SDK 调用。屏幕上那份报告写得更具体:报错是 weave 模块里根本没有 log 这个属性,所以字幕里的 weave.log 确实就是出错的那个调用名(见上图)。它复现了源 trace,跑了一堆 agent 变体「看看怎么让自己变得更好」,加了一个爬山目标,基本就是「要修好它,该这么做」;跑完后再给一小段说明,讲清生产版和候选版各自表现如何。他说:「这就是我现在天天泡着的地方。」→ 详细
- 修法小得出奇:点进它刚跑完的那次评测的 trace,能看到 ARIA 做了一大堆工作——跑了一列 predict and score(预测并打分),还有一串工具调用;切回聊天界面看它实际跑的那个变体:「候选变体只是往 system prompt 或者某个 skill 里注入了一小段精炼的 prompt」,专门用来解决、缓解那个 SDK 报错。同批 247 的 Warp 走的是另一条改 skill 的路:外层 agent 开 PR、由人来审。→ 详细
「我大概八个月没亲手写过一行代码」:auto mode 很舒服,但免不了你去想怎么改进
- 他现在的工作台:这个飞轮对他「格外有吸引力」——不用再回到 Claude Code 里写离线 benchmark、琢磨想让 agent 干什么,而是直接待在平台上,在两个项目之间来回切:生产 tracing 项目里,看 trace 随时间一条条涌进来,「ARIA 就在那里构建它自己」;离线评测项目里,看团队在做什么、自己在做什么、想做哪些改动、对生产 skill 或 agent 变体改了什么。→ 详细
- 原话:「我大概有八个月没亲手写过一行代码了,因为我所有的代码都直接让 Claude 写」。他说做某些任务时很容易直接进入 auto mode(自动模式)、只想看 agent 把所有事包办,这是「一大挑战」:这种模式「确实很舒服,但它并不能免除你去思考『我们到底想怎么改进』」。用这些工具来改进它们自己之所以有价值,是因为「你能把更多时间花在那片灰色地带里,真正去想怎么让这个系统变得更好」。→ 详细
- 人的活变成设计护栏:他说 auto mode 让人兴奋的地方在于,现在可以把所有时间花在「怎么让这个系统更好地自我强化」上——想想能给它套上哪些「贴身的小护栏」,让它对所有用户、进而对他自己都更有用。「我现在干活完全不用离开这个平台了」:生产和离线两边都有完整的可观测性,ARIA 正替他跑大量评测来改进它自己。→ 详细
其他演示与收尾:他最想留下的,是「生产 → 仿真 → agent → 改进模式」这条复现链路
- 推销与其他演示:他「强烈建议」做 agent 的人用 W&B 来追踪 agent,还说 W&B 有「非常出色的模型追踪平台」。大会上展示过的其他 demo 包括:ARIA 用 H200 GPU 训练机器学习模型(字幕说跑在 "core infrastructure" 上,可能指 CoreWeave,未核实)、给 Karpathy 的 nanochat(Karpathy 开源的极简聊天模型训练项目)做 autoresearch,以及一些完整规模的生产级项目。→ 详细
- 收尾原话:「这种从生产环境复现到仿真环境、再由 agent 自己定出改进模式的链路,就是我最想留给大家的东西」("replication from production to simulation to agent then defining the improvement pattern")。落到上面那场演示,就是这一圈:生产 trace → 回归任务 → 在沙箱里复现 → 跑多个变体 → 定爬山目标 → 生产版和候选版对比 → 落成一小段提示词或 skill 补丁。他以「以上就是 CoreWeave 的 ARIA,欢迎来到 Weights & Biases」作结,并回顾这场讲了什么:怎么决定搭离线评测指标、怎么从生产环境收割数据、打造 agent 的飞轮,以及他每天琢磨的事。→ 详细
闪电问答 / 收尾
本期是单人演讲,没有闪电问答或观众提问;收尾那句「最想留给大家的东西」已并入第十七节。
联系方式
演讲里没有给出讲者的个人联系方式;提到的产品都在 W&B 平台内:ARIA agent、Weave(agent 的 trace 与 eval)、W&B Reports。