工具、技能还是子代理?拆解一个长过了提示词的 agent
- 一一个原本好用的 agent(agent=能自己理解任务、自主调用工具、多步完成目标的 AI 程序;这里是库存管理 agent「Stock Pilot」),因为上线后被持续硬塞新能力却不升级架构,system prompt(系统提示词)膨胀到约 400 行、挂了 12 个 tool(其中 3 个其实是对 subagent 的封装),导致「原本被它加速的环节反而出现倒退」、eval 分数下滑;解法是用 tool / skill / subagent 三种 agentic 原语(搭 agent 的三类最基础积木)把它重新拆解。→ 详细
- 二核心方法论是「上下文工程」三连招:① system prompt 只留「不管交给 Claude 什么任务、它都得时刻记在脑子里」的信息;② 把「只在某些时候才需要」的业务逻辑搬进 skill(一包可被随时拉进上下文的信息)做渐进式披露;③ tool 优先复用 Claude Code 那套类人原语(bash / 文件系统 / 写跑代码 / 网页搜索),而非到处自建死板 tool 或一上来就直奔 MCP。→ 详细
- 三改造后 system prompt 从 400 行缩到 15 行、tool 从 12 个简化为 bash / read / write 三个、只保留一个「预测」subagent(用 CMA 的原生 callable agents 而非把它包成 tool);eval 分数从实测 62%(README 标称 83%)爬到约 92%,单任务 token 用量从 20 万+ 大幅下降,成本和耗时同步下降。→ 详细
主讲人与场景:Will + Applied AI 团队
主讲人 Will,来自 Anthropic 的 Applied AI 团队,本场是在伦敦 Code with Claude 大会上的单人动手实操(hands-on)分享。他亲口描述工作性质:「我基本上一半时间做内部工程工作,另一半时间和客户一起搭建 agent」——所以每条踩坑与原则都来自内部 + 真实客户的双重实践。→ 详细 本场目标明确:模拟一个「已经膨胀到一定复杂度、开始出现性能退化的 agent」,一步步过一遍「作为工程师和架构师,要做哪些决策,在保留新增能力的同时把期望的性能找回来」。全程围绕 tool、skill、subagent 三种原语,核心就是那句反复出现的灵魂三连:什么时候用 tool?什么时候用 skill?什么时候用 subagent? → 详细
问题陈述:好用的 agent 是怎么被「养坏」的
典型剧情(Will 让全场代入):你搭个 agent 解决某个具体问题、上线后跑得特别好——「我相信在座很多人其实都干过这种事」;正因太好用,上线几周后有人来加新能力,再过几周又来新业务需求,于是不断往上加。→ 详细 「这个模式不断重复、重复,等你回过神来」——system prompt 已长到好几百行、挂着几十个 tool 和 subagent;而正是这种复杂度,让「原本被 agent 加速的环节反而出现了倒退(regression)」。加法加过头,反成减法。→ 详细 Will 特意安慰「你并不孤单」——「这种情况在客户身上挺常见的,其实我们自己(Anthropic)也一样会碰到」。→ 详细
案例 agent:Stock Pilot 库存管理 agent
案例是 Stock Pilot,一个「为一家中型零售商量身设计」的库存管理 agent→ 详细,能做五件事:① 标记低库存(flag low stock);② 需求预测(forecast demand);③ 挑供应商(pick suppliers);④ 开采购单(file POs);⑤ 给员工写周报。Will 强调「这些能力单看每一项都不复杂」——问题不在功能,而在「我们随时间把一项项能力硬塞(bolt on)上去,却没同步升级架构」。→ 详细 演进是部「复杂度堆叠史」:先收到「加点预测能力」需求,团队「基本上就是直接起一个预测器当作 subagent」;后来又收到「加写报告」需求,于是「又为写报告加了一个 subagent」——两次随手「加 subagent」,就是后面复杂度失控的种子。→ 详细
改造前的架构:单 orchestrator + 400 行 prompt + 12 tool
今天的架构由一个单一编排器(orchestrator,居中调度、决定何时调哪个工具/子代理的"总指挥"AI) 驱动。→ 详细 关键的"改造前"基线数字:system prompt「已长到大约 400 行」;有 12 个不同的 tool,其中 3 个其实是对 subagent 的封装(wrapper),而这些 subagent「拥有完全隔离的 context window(各自一块互不可见的"记忆/工作区")」。→ 详细 repo 里有个 before 文件夹复刻了这个臃肿版本,一句话概括病灶:「一个 orchestrator、一个超长 system prompt、一大堆 tool、一大堆 subagent」——直接结果是「eval 分数开始往下掉(dip)」。→ 详细
Eval 体系:12 个任务、5 类 grader、R 与 F 两种
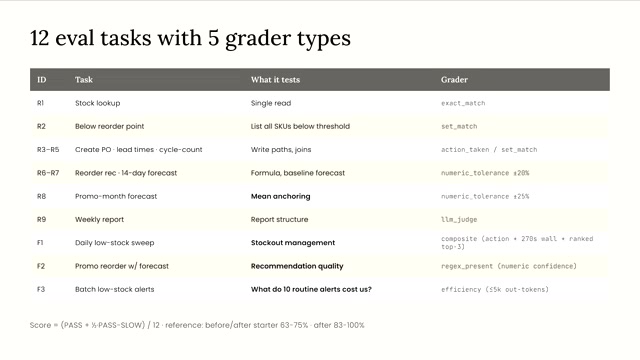
共 12 个 eval 任务,「横跨 5 种不同类型的评分器(grader)」;同事 Geary 本场前刚专门讲过 eval,所以这里只快速带过。→ 详细 两套 ID 命名:R 开头 = regression(回归),是「更贴近真实场景的单轮(single-turn)任务」——「给模型一个任务,模型理解、调用一些 tool、返回回复,我们本质上就在评估这个回复」;F 开头 = failure mode(失效模式),评估「更复杂的多轮(multi-turn)任务」。→ 详细 → F grader 分两大类:① 确定性(deterministic)——评「轮数、延迟、token 消耗」这类客观可量化、会「持续追踪随时间变化」的指标;② 非确定性(non-deterministic)——用「LLM 当裁判(LLM as a judge)」去评「人格、语气、风格、输出质量」这类没标准答案的软性特征。→ 详细
三个典型失败 eval:F1 / F2 / R8 的来龙去脉
- F1(每日低库存巡检):模拟「遍历所有库存,把库存过低的挑出来」。失败很微妙——「agent 最终会把事情做对,但绕一条非常曲折的路才做到」,不走 A 到 B 的最短直线而走低效路径,到达正确终点「但还是过不了 eval,因为没达到我们想要的效率」。对,但不够高效,也算失败。→ 详细
- F2(特定促销套餐下的下单流程):失败「是因为这个任务用了一个 subagent,它把任务做对了,但 subagent 和 orchestrator 之间出现了沟通断层(communication breakdown)」。Will 点明这是通病:「这是我们在客户那边看到的非常常见的失效点——系统很复杂、挂着一大堆 subagent 时就容易这样」。→ 详细
- R8(促销月预测):失败原因是「我们有两条不同的策略(policy),分别写在 system prompt 里相距很远的两个地方,结果彼此矛盾」;prompt 越长越长「开始出现冲突,模型被搞糊涂了」。→ 详细
R8 幻觉细节:正确基线却用错乘数
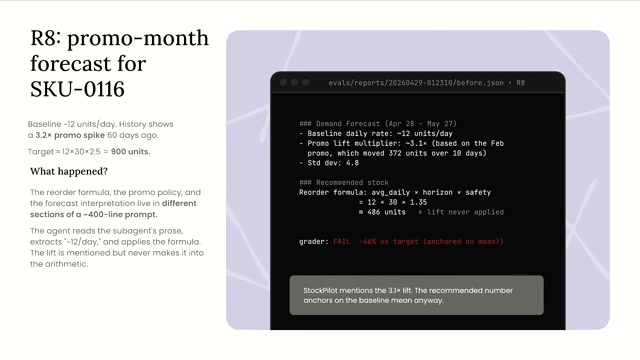
放大看 R8 幕后(Will 逐块解读屏幕右侧"模拟终端窗口"):在「注释文本下方的第一个代码块」里,「agent 拉到了正确的预测基线,也拉到了正确的促销乘数」——具体是「预测基线每天 12 个单位(12 units a day),促销乘数 3.1 倍(3.1x)。这些全都是对的。」→ 详细
但在下面的计算环节翻车了:「这里发生了某种幻觉(hallucination)。agent 没有用那个 3.1 倍的促销乘数,而是用成了 1.35。」——基线和乘数都查对了,却在落笔算的那一步把 3.1 写成 1.35,一个数字之差让整道预测全错。→ 详细
金句定性(全片"诊断哲学"核心一句):「这里给个提示,出问题的原因是我们有个上下文(context)问题。所以这不是模型本身的问题,而是我们给模型周围铺设的信息出了问题(it's an issue with the information that we're surrounding the model with)。我们的 system prompt 已经长到非常长,对模型来说非常容易混淆,里面还有一些冲突。」——把锅从"模型不行"精准甩回"我们的上下文工程没做好"。→ 详细
基线分数与 hill climbing 方法论
README 标称初始基线「一开始大概能过 83% 左右,还算凑合」,但 Will 立刻泼冷水:「如果你身处制造业(manufacturing),这个成绩可不行。17% 的失败率,是一个代价非常高昂的失败比例。」——把抽象百分比翻译成真实业务代价。→ 详细
workshop 四步流程(完整列出):① 先跑一遍整套 eval、拿基线(约 83%);② 对问题做分诊(triage,像急诊室分轻重缓急那样把失败归类排序);③ 据此更新 agent 设计;④ 反复重跑 eval,做一件 Anthropic「内部称之为爬坡(hill climbing)」的事——「朝着 eval 改善的方向往上爬」,让通过率「一点点往上爬、随时间逐步提升」。→ 详细
两个实操设置细节:起点是「一个完全从零、直接基于 messages API 自建的 agent」(放在 before 文件夹);现场跑 eval 用 Claude Code、模型 Opus 4.7、effort level 设为 extra high——Will 习惯「用 Opus 4.7 时一般都把 effort 设成 extra high,然后就不管它了……整体来说用 extra high effort 能拿到非常好的表现」。他用 bash 跑 uv run evals --agent before,实测结果只有 62%(12 个里通过 7 个),「比我之前说的 83% 还要低」,而且 Claude 还顺带「针对实际没通过的那几个 eval 给出了一份诊断」。→ 详细
迁移到 Claude Managed Agents(CMA)
迁移路线:起点是 before 文件夹里那个「围绕 messages API 自建的 agent 循环和 agent 框架(harness)」,目标是迁到 Claude managed agents(CMA,Claude 托管智能体),对应 starter 文件夹,部署命令 uv run deploy starter。→ 详细 CMA 的价值是「把维护一套 agent 运行框架的麻烦事甩出去」:本地搭、本地跑「很快很简单」,但一旦要「托管到远端、还得让成百上千用户同时来用」,就有「基础设施、扩展、内存、安全等一大堆要操心的事」,全交给 CMA 后自己「只需专注 agent 本身的架构、专心做 tool/skill/subagent 的决策」。→ 详细 CMA 的本质能力是「把 agent 本身,跟会话细节(session details)、跟 tool 执行所在的沙箱环境(sandboxed environment) 分离开」——三者解耦。→ 详细 上手前两个铺垫:clone repo + uv sync 装齐依赖;去 Claude 控制台用大会额度建 API key、填进 ENV 文件。→ 详细
Skill:用渐进式披露替代超长 system prompt
Will 给 skill 下的简短定义(建议背下来):「skill 就是打包好、可组合的信息(packaged and composable information),Claude 能在它意识到自己需要某些信息来完成某个特定任务时,把这些信息拉进 context。」→ 详细 两类典型用途都举了例:① 配合 Claude Code——「比如你需要给 Claude 讲清楚你的测试流程(testing process),或者想把你的品牌和 UI 组件(brand and UI components) 打包成一个 skill,让 Claude 需要时随时拉进 context」;② 在「你为客户构建的 agent」里——「如果你在做产品、要交给客户、你在搭 agent,那 skill 在这里面就非常好用」。→ 详细
黄金原则(全片最该记的一句):「在引入了 skill 之后,我们其实不建议你往 system prompt 堆信息。system prompt 里应该只放那些——不管你交给 Claude 什么任务、它都必须时刻记在脑子里的信息(Leave the system prompt only for the information that Claude needs in its mind, regardless of the task)。skill 特别适合用来打包那些 Claude 只在某些时候需要、而不是一直都需要的信息(information that Claude is going to need some of the time, not all of the time)。」→ 详细
用一个生活化例子把"some of the time"讲透:「比如我让 Claude 去做一个预测(forecast),那 Claude 平时是用不到预测相关信息的,除非我专门让它去做这个预测。所以针对这种特定任务,我才希望 Claude 把预测相关的信息拉进它的 context window。」——预测知识就该躺在 skill 里待命,而不是常驻 system prompt 占位。→ 详细 反例正是 Stock Pilot 本身:「库存管理系统里有一大堆不同的策略、一大堆流程规程(policies and procedures)。随着我把需求堆起来,我当时没去搭 skill,而是决定把所有这些信息全都不断往 system prompt 里追加,于是越变越长。」→ 详细 skill 还有个"省 token"的硬好处:「如果你把所有信息一股脑全塞进 system prompt,你就等于在用 Claude 完成某个具体任务时根本不需要的信息去污染(polluting)那个 context window。」→ 详细
第一次改造:400 行 → 50 行 system prompt
Will 鼓励听众跟着照做的第一个 prompt:让 Claude 去看 agent.py(「我们主要的 CMA agent 循环所在」),原话「嘿 Claude,你对这个 system prompt 有什么想法吗?也许我可以用 skill 来做渐进式披露,而不是一个长长的 system prompt」,稍后又补一句更直白的「我的 system prompt 太长了,我需要点帮助」。→ 详细 Claude「分析后发现我有一些现成的(pre-built)skill 可以替代 system prompt 里的部分信息」,于是「激活了一批之前没有的 skill,把 system prompt 从长换短」。→ 详细 量化对比:「从原来大概 400 行变成现在大约 50 行,把其中大量信息都转移到了 skill 里」。(这是第一阶段成果;全片结尾 prompt 会进一步压到 15 行。)→ 详细
Tool 哲学:优先复用「类人原语」
核心心法(Anthropic「内部构建 agent、以及和客户一起构建 agent 时一直贯彻的原则」):「每当我们构建 agent,都会倾向于复用我们作为人类所拥有的那一套基础能力(lean into the same primitives that we as humans have access to)。想象一下你来上班的样子:面前摆着一台电脑,你能在文件系统里浏览文件,能在浏览器里打字,能上网搜索」;「如果你是工程师,你还能写代码、跑代码」。→ 详细
由此推出对 Claude Code 强大之处的本质解释:「我们其实就是把你我每天上班时拥有的这同一套基础能力,全都交给了 Claude……本质上我们用 Claude Code 做的事,就是把一台电脑交给了 Claude。」好处是「这意味着每当我们发布更强的新模型,就能直接把更好版本的 Claude 替换进来,而 Claude 用这些基础能力的水平也会比以前更好」——架构不动,换更聪明的脑子即可升级。→ 详细 一个很妙的现场比喻:「就好比想象一下这场大会结束后的你,和刚走进会场时的你做对比。你手头能用的工具还是同一批,但理论上你的脑子会变大一点,因为今天学到的东西你会变得更聪明,用同样的工具也能做得更出色。Claude 的运作方式一模一样。」→ 详细
起手原语清单(构建 agent「永远的起点」):代码执行(code execution)、在文件系统里导航(navigation of a file system)、维护一份待办清单(keeping of a to-do list)、上网搜索(search the web)。Will 强调「这些是我们构建 agent 时永远的起点,是最基础的 tool,然后我们再按需把它们去掉」——先全给、再做减法,而不是从零一个个加。→ 详细
文档分析的具体取舍:bash + Python 而非塞 CSV
Will「喜欢举的一个例子」是文档分析(document analysis):「如果你在构建一个需要做文档分析的 agent,可能你的 agent 要处理大量 CSV 或 Excel 表格,那么代码执行——写代码、跑代码的能力——就是做数据分析、处理大量文档最好的方式之一。」→ 详细
给出可直接照搬的具体做法:「给 Claude 一个 bash tool,让 Claude 写一段简短的 Python 脚本,跑完后再基于结果去推理,这比直接把整个 CSV 上传到 Claude 的 context window 里要有效得多。」——让 AI"写脚本去算",而不是"把原始数据塞进脑子硬读"。→ 详细
落到 Stock Pilot:「这是一个特别适合这么做的库存管理 agent。我可以把大量原本用来处理 Excel、处理预测数据的 tool 整合掉、删掉,直接让 Claude 用上 Claude Code 拥有的那同一套 tool。」而且有个便利:「当你用 CMA 来构建时,这些 tool 其实是默认就内置好的」——你「根本不用操心去写一个让 Claude 能写代码、跑代码的 tool,也不用去写一个让 Claude 能用文件系统的 tool」,直接用 Anthropic 为 Claude Code 打造、再通过 CMA 提供的内置 tool 就行。→ 详细
Tool 的四级选型与 MCP 的位置
「我们关于 MCP(Model Context Protocol,让外部工具/服务以标准协议接到 AI 上的"通用插座") 总会收到很多提问。」就 CMA 而言,tool 选型有清晰的优先级顺序:① 先用 Claude Code 原语(网页搜索 / 代码执行 / 文件系统)——「这是我们的起点」;② 再创建只有自己 agent 能用的独立本地自定义 tool(custom / local tools);③ 然后才考虑把 agent 接到 MCP 上。→ 详细
反模式讲得很直白:「我们看到很多人一上来就直奔 MCP(run towards MCP first),结果不少客户最后陷进了这样一种生态:存在着一大堆杂乱无章的 MCP server(chaotic MCP servers),这些 server 很多时候功能相互重叠(overlap),这会带来一些问题。」所以「我们构建 agent 时……不会一上来就奔向 MCP」。→ 详细
MCP 的正确时机(什么时候才该上):「只有当我们有一批通用的 tool、而多个 agent、或者多个 Claude Code 客户端,都需要访问同一套标准化、受治理的 tool(standardized and governed tools)时,我们才会着手把这些 tool 收集起来、发布成一个 MCP server。」——MCP 是为"多方共享同一套受管控工具"而生,不是单 agent 的起手式。→ 详细 一个正在兴起的新趋势:「在整个行业里正变得越来越常见的,是借助 Claude 的能力,直接用代码执行来作为调用 tool 的方式——让 Claude 直接去用 CLI、用代码调用 API,真正用代码来运行 tool,而不是走 MCP。」原因是「MCP 的一个缺点在于,它会带来一些 context 上的问题——会污染 context、占用大量空间」;用代码执行调 tool 则能在不必上 MCP 的前提下给 agent 更多灵活性。→ 详细
Tool 改造的量化收益
前后对比里「第一个最抓我眼球的就是 token 用量」:「改动之前,某个任务我要用掉超过 20 万个 token(over 200,000 tokens);用上文件系统原语之后,这个数字大幅下降(went down dramatically)——这是给我的 agent 加上代码执行能力的直接结果。」→ 详细 省 token 的原理:当 agent 能「写代码、跑代码、然后读结果」时,用的 token 远少于「把所有数据都塞进 Claude 的脑子里、再调动全部脑力去做决策」。→ 详细 连带收益与一句诚实的免责声明:「我们的成本也下来了(token 少了),执行时间也缩短了。」但 Will 不吹过头:「这种事不会每次都发生,有些情况下我们可能反而会退步(regress)。不过这个例子里,用这些原语取代那些更死板的 tool,显然是正确的决定。」→ 详细
Subagent:两个绝佳使用时机
时机一:想用大量 Claude 算力去"群攻"一个问题时(throw a lot of Claude at a problem)。 原文举例:「比如你要做 deep research,或者网页搜索」;再比如在 Claude Code 里做代码库探索(code-based exploration)——「这就是一个绝佳的例子,让很多个大脑同时去解同一个问题是说得通的。所以 subagent 是一种很好的方式,可以并行化(parallelize)、用大量 Claude 去攻一个问题,从而更快、更高效地完成它。」→ 详细
时机二:需要一个"全新的、不带前文 context 的大脑"来审视问题时(a fresh mind to look at a problem)。 Will 用自己当开发者的经历打比方:「如果我在写代码,我可不想让写代码的人同时也是审我代码的人。我会找别人来 review 我的代码。」对应到 Claude Code 就是「让一个 Claude 实例负责写代码,然后让另一个不带第一个实例 context 的 Claude 实例凌驾其上来做 review……用一个专门的 code review subagent 叠在上层,就是实现这个目的的好办法」。→ 详细
Stock Pilot 据「时机二」保留了唯一的「预测」subagent:「我确实想让预测和我的主 Claude 实例分开。我不希望我初始 context window 里的任何东西去干扰(distort)预测过程。」具体安排是——「我确实有一个 skill,它把我希望 Claude 在写预测、做预测时遵循的步骤顺序和准则(step-by-step sequence and guidelines) 一步步走了一遍;但我不想让那个正在和我客户对话的 Claude,同时也是那个写预测的 Claude,所以我想把它们分开。」skill 管"怎么做预测的规程",subagent 管"用一个干净的脑子去执行",两者配合。→ 详细
CMA 原生 callable agents 与 subagent 的取舍
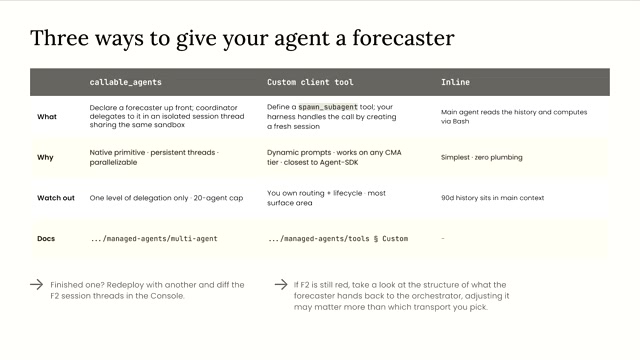
subagent 的两大固有难题:① 通信难做到准确无缝——「当你有多个 Claude 实例在跑,你很难保证编排器和 subagent 之间的通信准确且无缝,中间有很多东西会在「翻译」过程中丢失(lost in translation)」。Will 用同事相处打比方:「就像我跟同事说话,我心里想的是一回事,他们理解到的可能完全是另一回事——编排器和 subagent 之间也会这样。」② 日志难收集——「某些情况下日志记录非常难搞,因为你得操心怎么从多个不同 agent 里把各自的对话记录(transcripts)收集起来。」→ 详细
CMA 给出的解法是原生「可调用 agent(callable agents)」,「本质上就像是被托管的 subagent(managed sub agents)」:好处是「在你的会话信息里,你就能拥有关于 subagent 到底在干什么的可观测性(observability)和指标(metrics),而且其准确度和你那个初始的编排器一样高」,专治"subagent 会产生大量难以追踪的信息"这个难题。Stock Pilot 的预测 subagent 就「不会把它暴露成一个 tool」,而是走这个 CMA 原生通道。→ 详细
一个重要的行业趋势 / 反直觉建议:你不仅可以把 subagent 定义成 tool(旧做法),「还有很多场景下,你现在完全可以把 subagent 整个砍掉(scrap the sub agent entirely),转而给你的主 agent 更多的灵活性和能力」。背后原因:「前沿模型(frontier models)已经变得足够聪明,能够跨越更多信息进行管理,你根本不需要那么多 subagent 了。」所以「我们看到很多客户实际在做的是——干脆把能力吸收进它们的主体(consuming capability into their main orchestrator)」。一句收束:用 subagent 就两种时机——"群攻大问题"或"要一个干净的脑子来 review"。→ 详细
改造后的最终架构与 92% 成绩
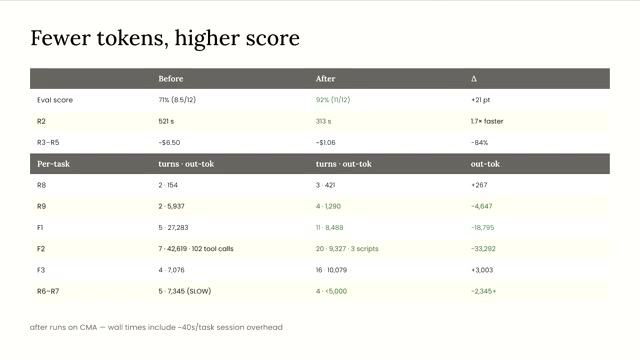
最终架构对比(起点:编排器 400 行 prompt、12 个 tool、其中 3 个是 subagent):改造后「我们仍然有一个编排器,但把它部署在了 CMA 上,因为我不想操心基础设施、扩容、安全,只想操心我的 agent」。Will 补的大白话:「这就是我会拿起 CMA 的时刻——因为我只想专注于打造尽可能好的东西,而不去管随之而来的那一堆烂摊子。」→ 详细
- tool:「我们简化了 tool,现在有三个,其实把一切都简化成了只用 bash、read 和 write。」运行时还有个机制:agent 开始执行时「会把一些数据同步(sync)进 CMA 环境,好让它能跨着这些数据推理」。→ 详细
- system prompt:「我们实际上把 system prompt 简化到了只有 15 行,并把所有业务逻辑都换成了 skill」——「让 Claude 只在它意识到解决某个问题需要时,才把这些信息拉进自己的脑子里」。→ 详细
最终成绩:「到最后,我的 eval 得分大约是 92%(从实测 62% / 标称 83% 爬上来)。我简化了设计,用上了让 Claude 出彩的原语,而且看到了正向结果。」关于"轮数没降"的取舍:「轮次数(turn count)基本不变,但因为 token 用量和成本都在下降,我其实可以接受 Claude 多花几轮。」延迟也可妥协:「对这些更复杂、更高智能的 agent——比如涉及预测的场景——我愿意承受稍微高一点的延迟,换来性能提升、成本下降。」→ 详细
收尾三条 takeaway
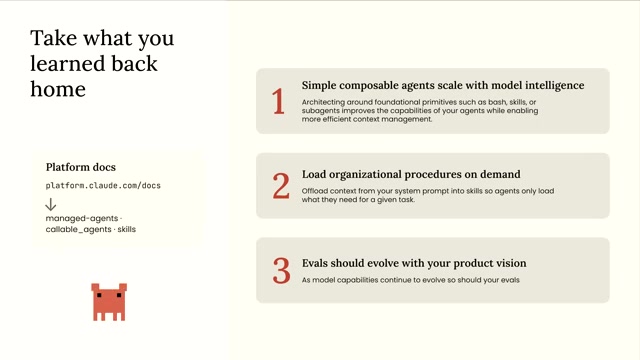
- 第一招(起点):构建 agent「起点是一个单一的 agent 循环(single agent loop),配备非常简单的原语,给 Claude 一些类人能力——文件系统(就像你电脑上那个)、网页搜索、代码执行,有时还有一个待办清单。我们从这里起步,再据此构建。」→ 详细
- 第二招(skill 渐进式披露):「下一件事是通过 skill 实现渐进式披露——不把一大堆信息塞进 system prompt,而是让信息可被 Claude 随取随用、只在它意识到需要时才取用。好处很大:运行效率更高、不污染 context window、还给了 Claude 更大的决策灵活性。」→ 详细
- 第三招(永远写 eval + 爬坡):「无论如何都要写 evals。 这种爬坡式优化(hill climbing)是我们在 Anthropic 非常依赖的理念——用 evals 建基线,调整架构,再重跑 evals,不断变好。」附一条易被忽视的纪律:「随着产品能力不断扩展,要确保 evals 也同步更新,始终覆盖你真正在意、会在 agent 里去衡量的东西,这样才能确认 agent 确实完成了你最初设定要完成的目标。」→ 详细
闪电问答 / 收尾
(本场为单人动手实操演讲,无 lightning round / Q&A 环节。)收尾时 Will 用上面三条 takeaway 收束全场——从简单类人原语起步 → 用 skill 做渐进式披露 → 始终写 evals 并做 hill climbing,并反复强调那句容易被忘掉的纪律「产品能力扩展时 evals 要同步更新」。→ 详细
术语速查
- agent:能自己理解任务、自主调用工具、多步完成目标的 AI 程序。
- agentic 原语:搭 agent 的三类最基础积木——tool / skill / subagent。
- system prompt:给 AI 定调子的那段固定指令;本片主张只留"不管干啥都得记着"的信息。
- skill:打包好、可组合的信息,Claude 需要时才拉进上下文(渐进式披露 / progressive disclosure)。
- subagent:被主编排器调用的另一个 Claude 实例,通常有隔离的 context window。
- orchestrator(编排器):居中调度、决定何时调哪个工具 / 子代理的"总指挥"AI。
- CMA(Claude Managed Agents):Claude 托管智能体,把基础设施 / 扩容 / 内存 / 安全 / 沙箱执行兜底,开发者只管 agent 架构。
- callable agents:CMA 原生的"被托管的 subagent",自带可观测性与指标,不必包成 tool。
- MCP(Model Context Protocol):让外部工具 / 服务以标准协议接到 AI 上的"通用插座";多方共享受治理工具时才上。
- eval / grader / hill climbing:评测 / 评分器 / 朝 eval 改善方向反复重跑"爬坡"。
- regression(倒退):原本被加速的环节反而变差,本片的痛点报警器。
联系方式
主讲人 Will(Anthropic Applied AI 团队工程师)未在演讲中留下具体联系方式;他在散场后会「待在后面、就在这个房间外面」现场答疑(原话「I'll be in the back after the session just outside of this room in case you have any questions at all」)。其余信息见视频。→ 详细