○
Neo4j 的开发者布道师 Jeremy Adams 把一台旧树莓派 4B 做成挂在脖子上的个人 agent:选了只有十几个源文件、把 agent 关在 Docker 容器里的 NanoClaw,用 WhatsApp 对话,推理全在云端的 Claude,理由是「看得懂比功能全重要」。
Neo4j 的开发者布道师 Jeremy Adams 把一台旧树莓派 4B 做成挂在脖子上的个人 agent:选了只有十几个源文件、把 agent 关在 Docker 容器里的 NanoClaw,用 WhatsApp 对话,推理全在云端的 Claude,理由是「看得懂比功能全重要」。
Traversal 的产品经理 Eric Schwartz(厂商视角)的判断是:编码 agent 把「开发」压短之后,省下的时间没有流向设计,而是被排障吃掉——代码更多、人对它的理解更少;他的幻灯片引的数字是 Global 2000 企业每年因宕机损失 4000 亿美元、每位工程师每周 7 小时耗在排障上。
提速的工具就是致病的工具:Sourcegraph 的 CEO Dan Adler 认为,coding agent 写代码越多越快,支撑世界运转的几十年老代码库就腐坏得越快——标准漂移、重复代码扩散、跨服务依赖变脆、新漏洞不断冒出来,病根是代码的量。
Sarah 的核心论点:dashboard 和各家查询语言从来只是夹在你和数据之间的「翻译装置」,你要的一直是答案;她自己每天用 Datadog 用了半年、却连它的仪表盘都没打开过,就是「仪表盘已死」的现场证据。
AssemblyAI 每天约 1,000 个 API 注册,负责带客户上手的工程师却长期只有 Matt 一个;买来的现成客服机器人只端到端解决约 10% 的对话,而且 system prompt、工具、检索管道一样都改不了,于是他的 FDE 团队自己造了一个所有对话都必须先过他的 agent,起名 Joey。
VS Code 团队靠 agent 把坚持了十年的月更改成周更:agent 写的代码存活率一年从 55% 涨到 86%,可成功马上制造了下一个问题——issue 和 PR 积压暴涨——所以他的结论不是让大家多用 AI,而是把发布软件的整套体系重建一遍。
购物正在从「搜索时代」(人敲关键词、自己翻目录)走向「意图时代」(人用大白话描述需求,AI 把商品送到面前),下一站是「委托时代」(agent 直接替人下单);而商家手里的商品目录,是照着 Google Shopping 这类广告 feed 和人的关键词搜索建的,agent 读不好。
前 Microsoft、Supercell 工程师 Erina Karati 用一个游戏里的 AI 村庄说明:会记忆、有情绪的 agent 在短场景里很顺,时间一拉长就出现三种失真——丢了来源、传言被说成事实、做计划时想不起已知的事实,所以长周期 agent 得按「一整次运行」来评估和改进,而不是盯着某一次回答。
agent 已经够强,卡住产出的是人:每个 agent 都要人去掌舵、指挥、评审,规模一上来就把人累垮——AgentCraft 与 MCP-UI 的作者 Ido Salomon 的判断是「我们就是瓶颈」,而驾驭一大群单位的本事,其实早在打《魔兽争霸》这类游戏时就练过了。
Warp 创始人兼 CEO Zach Lloyd(前 Google Docs 工程负责人,六个月没写一行代码仍在频繁发版)的论点是「软件工程会变成工厂工程」:开发正从聊天补全、交互式 agent 走向自动化,每个有规模的项目都会有一条「想法 → 分诊 → spec → 实现 → 评审 → 验证 → 发布 → 监控」的大循环,人只在审 spec、审代码、审产品三处出场,工程师的活变成搭建和管理这座工厂。
W&B 工程师 Zubin Aysola 拆解自家刚正式发布的 ARIA agent 怎么评测、怎么自我改进(利益相关:ARIA、Weave 都是 W&B 的产品);他每晚睡前琢磨的难题是「benchmark、eval、agent 和它的配置全都一起变」,对策是让生产版和研究版 agent 逐字节一致,生产和离线的 trace 都用 Weave 按同一种格式记录,这样线上的任何一次运行都能原样搬回离线环境里做爬山优化。
Warp 的 harness 开发负责人 Suraj Gupta 认为,软件工程师正从「造产品」转向「建工厂、维护工厂」,而很少有人讲的是工厂本身怎么随时间变好;他把答案拆成三种回去就能落地的机制:skill、持久记忆、模型路由。
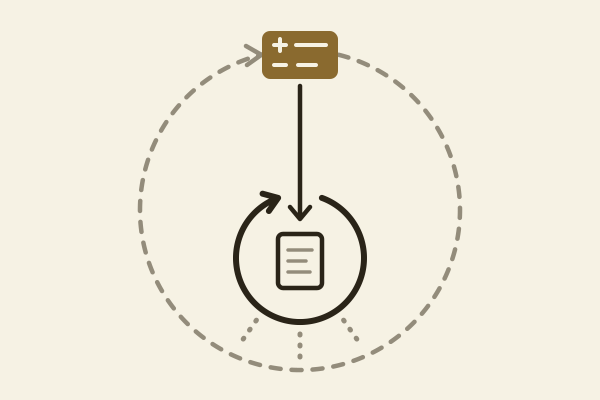
Reddit 的 Android 工程师 Andrew Orobator 认为模型从来不是瓶颈,围绕模型的判断力才是:换一个更聪明的模型,答案只好一点点;拿掉测试、闸门和评审,整个系统就垮。人是耳濡目染、隐式吸收判断力的,agent 每次都从零记忆启动、要求判断力是显式的——所以工程师的活已经变成「harness 工程」,要规模化的是判断力,而不是模型。
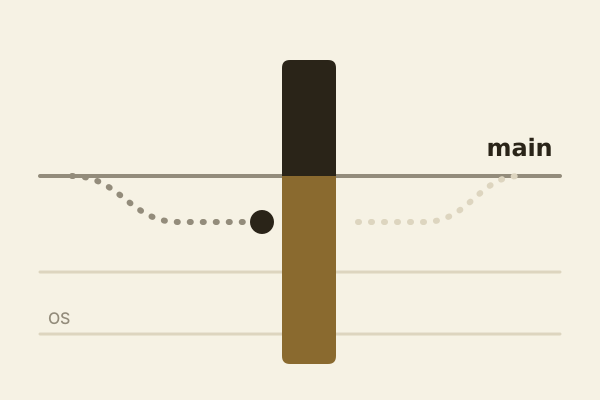
这篇论文把 agent 记忆里那些高频、答案只是「一个标签 / 概率 / 分数」的决定——给记忆打类型、判关系、路由查询、给候选打分、决定何时停——统统交给 TypeSafe AI 的类型化决策模型 Jev(不生成文字、直接返回概率,就是 ep229 讲的那个模型)当「系统一」,大模型(系统二,实验里是 gpt-4o-mini)只在最后综合作答时出场;论文强调真正的新意是这种「轻量控制 / 深思推理」的架构分离,Jev 只是它的一种实现。
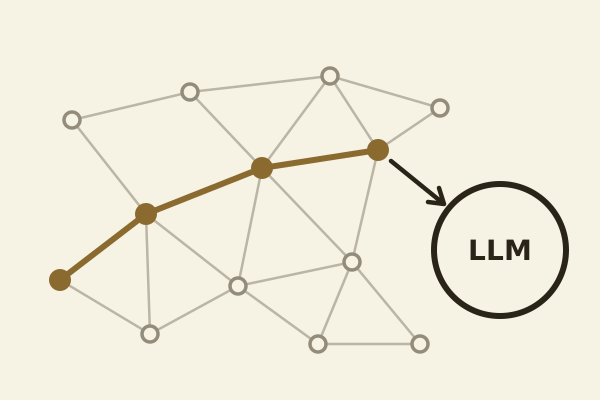
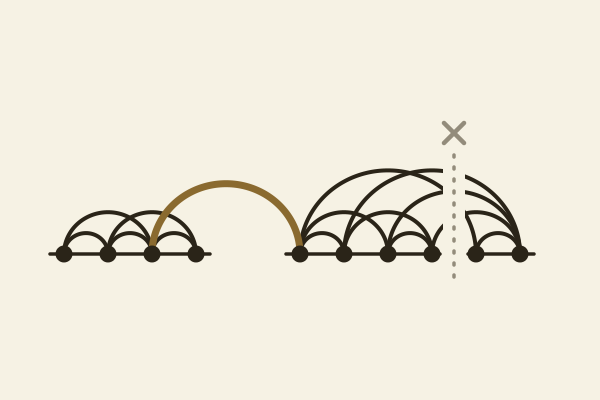
这篇南京大学团队的论文用图论回答「多智能体协作什么时候才值得」:把一次任务执行看成步骤之间的依赖图,删掉就会让图断开的「桥边」就是两个子任务之间唯一的交接线——事先知道整条轨迹、又沿桥边切对,拆给多个 agent 一定省上下文;可现实里依赖图要等任务做完才看得见,编排的本质是提前猜桥边,猜错会让 agent 互相干等(局部死锁)或推高通信开销,子任务越多错得越多、协调成本越高,所以多智能体只在「长程 + 稀疏依赖」的任务上系统性占优,在紧耦合的顺序流程里,Claude Code、Codex 这类单智能体 harness 依然更强。
Jev(官网 typesafe.ai)是一个专做分类、决策的模型:你给它一个输入加一份输出 schema(一个问题 + 一组选项),它不生成任何文字,约 200 毫秒还你每个选项的概率,结果类型安全、拿来就能进代码;Ryan 用自己的 1,700 封邮件现场跑了类别、优先级、垃圾分、回复分四个字段,整批只花 18 美分。
在生产里跑得好的商务 agent 共用一套「只需决定一次」的简单架构:一个 Claude 模型跑在标准 agent 循环里,前面不设意图路由、后面不挂领域 agent——长尾功能用按需加载的 skill 而不是 subagent(每次移交都丢状态,还可能多花几倍 token、多几秒延迟;多个企业部署对比下来「单 agent + skill」质量始终最好),工具直接调用你已经在跑的搜索、库存、促销等系统而不是让模型重造一遍,连商品轮播这类 UI 组件也做成工具,好让 agent 知道屏幕上此刻有什么。
界面自己调 API 取数,对模型就是黑箱,用户一追问「讲讲第一条」「给公司排个序」它就答不上。所以规则一是「凡是展示给用户看的东西,也都要作为数据提供给模型」:structuredContent 和界面一起返回、保持同步,用户在界面里点了什么也用 updateModelContext 推回去;规则二是在 tool description 开头写一句「结果已作为 UI 组件自动展示给用户」,免得模型再用文字把结果重排一遍。
今天的购物 agent 大多是「搜索框套壳」,默认用户意图清晰、手握关键词;Google DeepMind 产品人 Nidhi 主张把系统设计成「随时准备好接住 vibes」,走「发现(沉淀带置信度的工作状态、找意图缺口)→ 研究(多模态引导 + 后台比较权衡)→ 自适应回复」三段循环。
40 年来是人迁就静态软件,AI 本该扭转这一点——但 commercetools 早期把界面排版全交给模型,同一句「生成一份 Q1 销售报告」连跑四轮就出了四种互不一致的界面,连标题都从 Q1 变成「1 月和 3 月」,Gus 的评语是「不行,不行,还是不行」。
微软把本体定义为"企业词汇 + 语义层":用实体类型、属性、关系(外加约束)把跨业务域的含义统一起来,定义完再绑定到 OneLake 里的真实数据,作为人和 AI 智能体共用的上下文层——这是官方预览版文档的自我描述,全文没有给出任何效果数据。
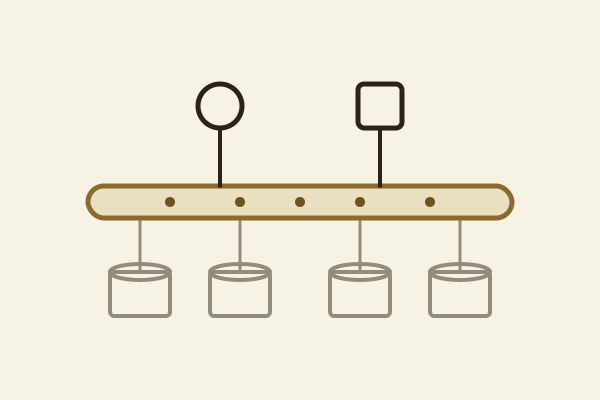
本体不是换个名字的数据模型,而是「名词 + 动词」一起定义的运营层:传统数据库设计只管名词(数据),把动词(业务逻辑与更新流程)丢给另一个应用层;Palantir 把对象 / 属性 / 关联(语义)和动作 / 函数 / 动态权限(动力)放在同一层定义,同时建好「看的模型」和「改的模型」,动作结果直接写回——数据从「只供查看」变成「直接驱动业务」。
本体是按业务「怎么说话、怎么运转」建模,不是把数仓表、系统表搬进来:Palantir 的四条根本原则——领域驱动设计、不要重复自己、开闭原则、组合优于深层级——每条都对着一个一线最常见的反模式:一张 order data 表一比一建成「上帝对象」、销售 / 支持 / 计费三个「客户」各自为政、往已经上生产的对象上加字段、把建筑挂成一条父子长链。
Palantir 前置部署架构师 Chad Wahlquist 的底层主张是「人和 AI 协同」:LLM 没有你业务的世界模型,得靠本体来补——而本体不是 1996 年 Kimball 维度建模那种行和列,是能把 CAD 文件、图片、表格装进同一个「工厂」对象的多模态语义对象;同一个本体同时喂运营应用、KPI 和 agent,每接一个用例都在叠加复利。
Palantir 自己的业务早就建在本体上,今年上线的 OMCP 只给 agent 一个 MCP 入口——里面不是 20 个系统的原始数据,而是建好模的对象、对象之间的关系、管理员开放的动作,外加原样继承的个人权限(还能按安全标记把 PII 挡在外部工具之外);所以 Claude Code、Codex、Copilot 随便哪个接上都「说同一种语言」,分析离「一次做对」近得多,也少烧很多 token。
评测标准分两半:自上而下(凭对任务的理解想出来的)AI 帮你写得很好,自下而上(翻大量真实输出后长出来的直觉)「Claude 特别特别不擅长,那部分完全靠你自己」——绝大多数人手里那套 eval 只有前一半,所以永远评不出真问题。
agent 是不可信软件,守卫不能放在 agent 里面——Opus 再对齐也可能被 prompt injection 带偏,安全不能是「一厢情愿指望模型听话」,边界必须在 agent 软件之外,包括安全插件、改 agent 代码都不算数。
Uber 几千名工程师、12 个站点,一年内做到 70% 的 PR 由 agent 生成、人均代码量翻倍、250 项自动迁移改了 900 万行——靠的是六个平台级构建模块(模型网关、MCP 网关、agent 化 Devpod、skill 生命周期、上下文图谱、Cortana 助手),而且站在六年 monorepo / Bazel 基建之上。
搭 agent 已经不难了:六个月前要一个团队干一个季度交的那些「税」(状态持久化、沙箱、可观测性),如今被云厂商原语 + 框架兜住,定义一个 agent 只剩选模型、写指令、给工具、给 skills、定沙箱五件事。
Kieran 今年一行代码没写,却一个人 ship 了几千人托付邮箱的 AI 邮件产品 Cora——靠的是「把我的思考方式和品味抽取出来,放进一个能复利的系统里」;他的判断是「一个带着复利系统的工程师,直接碾压整支没有复利系统的 AI 团队」。
harness、loop 这些 agent 调优技术终将变成大路货甚至 frontier lab 的标准服务,不会是你组织的差异化优势;「这在我们这儿行不通」的真实含义是「我们还没搭好架子」——差异化在团队、平台、组织怎么跟着变。
Warp 云端 agent 平台 Oz 的一条总原则是「平台在复杂性触达用户之前先把它扛下来」,落成四个原语设计:sandbox 托管 + 自托管并存、兼容任意 harness 但用平台护栏防体验碎片化、调研 / 实现 / 验证拆给不同 harness 和模型的 sub-agent、以及为栈里每个组件都开 API 让别人在上面搭。
瓶颈已经从「写代码」挪到「评审代码」,而这道闸门其实早就塌了——code churn(代码返工量,写完没多久又被改掉或删掉的那部分代码)涨了 861%,事故数与 PR 数的比值在上升,等 review 的时间是过去的四倍,超过 30% 的改动完全没经过评审就直接合入主干。Ankit 的判断很直白:「我们其实早就已经不 review 了。」
模型每周都在变强,但只在 IQ 这一条轴上变强——「你跟它们对话的时候,总感觉它今天是上班第一天」。Arjun 的类比是:把 Terence Tao(当代最顶尖的数学家之一)扔进一家会计事务所,第一天他多半不是那儿最好的会计,可给他几年、甚至几天就会非常好——真正被低估的是与智力正交的那条「经验」轴,Trajectory 这家公司要填的就是这道 experience gap(经验鸿沟)。
花 500 多美元跑完 11 组对照实验后,他们撞上一个所有人都没料到的结论:完全不动 context、把完整历史原样留着,在「记得住 / 更便宜 / 更快」三条战线上同时打赢了所有 compaction(压缩,即把长对话历史摘要成短的再喂回去)技巧——因为一旦把历史 tool 输出裁掉,agent 就得为它本来已经拿到过的信息再检索一遍,反而更慢更贵。
harness(外壳/骨架,即包在模型外面那层负责调工具、管上下文、决定下一步做什么的代码)的本职只有一句话:在正确的时间点,把正确的 context 送到模型面前。 今天外面几乎所有 agent 的内核都是同一个「LLM 在循环里不停调工具」,所谓高级 harness 不过是在这个循环的几个固定位置上挂了钩子。
做一件事所需的资源(时间 + 专家深度)正在坍缩——过去几十个强产品工程师加 PM 干好几个季度才能交付的东西,现在一个人、几周、不写一行代码就能做出来;后果不是"效率变高",而是应用层的护城河正在被抹平,竞争被推着从"在现成黑盒 API 上搭壳"转向"拥有自己的智能"。
RL environment(强化学习环境,说白了就是给 AI 搭一个能反复动手、又能被逐条打分的仿真工作场景)拆开只有三样东西——worlds(世界:真实项目里的消息、文档、表格)、apps(应用:Salesforce、Microsoft 365 这类主流软件的高保真复刻)、tasks(任务:一条 prompt 配一个负责判对错的 verifier);前沿实验室想把「你在笔记本上能干的活」全自动化,卡点就是把这三样铺满整个经济体。
Rich Sutton 的核心指控只有一个技术事实:今天的大语言模型在上线前做完预训练和后训练之后,权重就被冻住了——「它们的权重从来不变」,你跟它聊多久它都不再从经验里学;所以在他看来,怪的不是他,而是那些「声称一个完全不再学习的东西能有博士级的经验和专业水准」的人。
上下文工程之所以一年后还没过时,是因为它不押在某个模型上,而押在「Transformer 注意力是二次方的」这个物理事实上——你唯一能影响 AI 输出质量的手段,就是精心挑选和排列输入;而输入不只有「信息预算」,还有大家常忽略的「指令预算」(前沿模型大约 150–250 条指令后就开始跟不住)。
"我们会不会发自己没读过的代码"不是一个是非题,是一个时间题——Charity 说争论"会不会 / 什么时候"没意义,正确的问法是「要满足什么条件,你才会觉得这可以接受」;而答案是一本信任账户:你在"代码创作"这一栏支取了信任(没人读过),就必须在测试、evals(自动化打分)、一致性测试、护栏、遥测上把它补回来。
核心论点:个人化的 AI codegen 会打破传统云基础设施。今天的软件是"开发者在象牙塔里做好、往下发给所有人跑同一份钦定版本",用户的功能请求被产品经理"一股脑丢进 Jira,从此再没人见过它们";要让每个人当场把 app 改成自己要的样子,这套底座必须换掉。
Wisedocs 处理的是动辄上万页的医疗理赔 PDF(有些文件比视频文件还大),跑这条 AI 管线的代码散在十多个 repo(repo =代码仓库,一个独立管理、独立发布的代码包)里、已经存在六年多、没人愿意去碰;2025 年他们决定用六个月把它合并成一个 monorepo(单一大仓库,所有代码收进同一个仓里管),这场演讲就是讲者的诚实复盘——这一步到底该现在做,还是该等模型再变强两代?
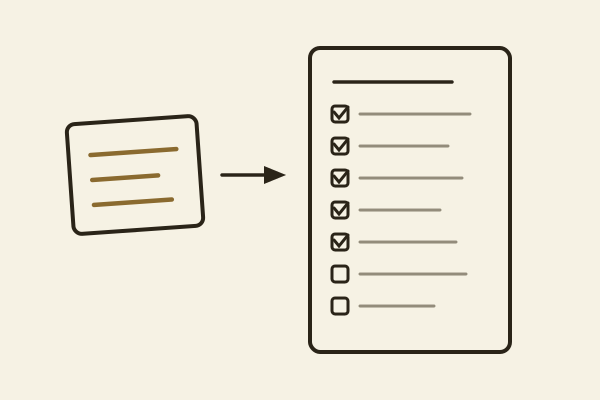
三行大白话,换回一整份作业手册。 Idan Gazit(GitHub Next 负责人,GitHub 的实验室团队)像给团队里一个初级开发发 Slack 消息一样写了三行字——"每天看看有没有新版本、读 changelog(更新日志)和文档、想个升级方案出来、开个 PR"——Copilot 就把它展开成一份完整的 playbook(作业手册,即一步步该怎么干的流程稿),真的把他的个人网站从 Astro 5 跨两个大版本升到了 Astro 7:改好被升级弄坏的代码、跑构建验证、还把他自己必须动手的手工步骤单独标了出来。
这是一场"把 Codex 的引擎盖掀开给你看"的工程分享:讲者 Dominik Kundel 用 2 倍速讲完 20 分钟,视角是「你按下回车之后,harness 里到底发生了什么」——harness(可以理解成"挽具/外壳",就是承载模型干活的那层程序:给它工具、组装上下文、跑循环、收结果)。他反复强调:这一切都是开源的(「it's MIT it's Apache 2 license」——他现场自我更正了一次),用 Rust 写的,你可以学它、可以拿它去问 Codex、也可以 fork 一份改成自己的。
便宜模型的总账更贵:拿 terminal bench(一类让模型在命令行环境里实际动手完成任务的评测)去跑,Opus 的分数大约好 3 倍,总成本却只有 Haiku 的十分之一——尽管 Haiku 每 token 便宜得多。原因是小模型一旦被推出自己的训练分布,就会疯狂调工具、陷进循环,轮次多到把单价差距吃干净还倒贴。
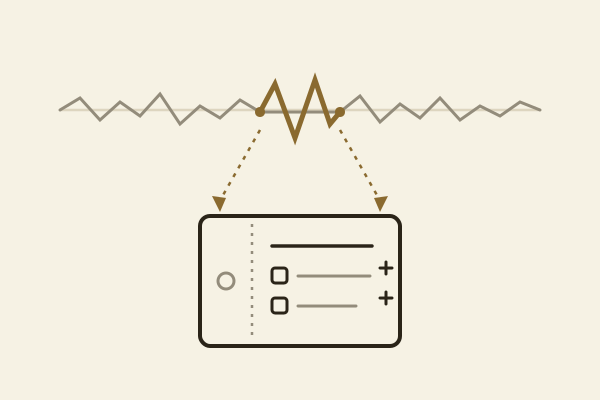
展台上一台会议 bot 听了 4 小时 Google Meet,自己从对话里捡出一个想法、自己开了 ticket、自己给产品的建单表单加了两个「验收标准」字段——全程没有任何人做任何手工操作。 这是全场最实的一幕,也是他整套主张的证据:每一通客户电话、每一次 onboarding、每一条 bug 报告,都是可以直接变成代码的需求信号。
「模型能力已经够了,要卷就卷 infra。」 全场暴论,也是标题来源。依据是他的一线体感:最新一代旗舰模型跟他之前用的 Claude Opus,「对于开发者来说没有本质上的区别」,爬坡「已经开始放缓」。卡住智能体落地的不是智商,是基础设施和 harness(harness = 包在模型外面那层"外壳程序",负责读文件、调工具、管上下文——Claude Code、Codex 都是 harness)整块没跟上。
AI 让 PR(pull request,一次「请把我这段改动合进主干」的申请)多到审不完,但正解不是「人审得更快」,而是「不是每个 PR 都需要人来审」——Intercom 已经把这条路走通了:AI 批准的 PR 比人审的快 5 倍,上线后要返工/回滚的比例反而更低。
agent(智能体,即"能自己调工具、自己跑多轮、直到把任务干完的 AI")的本质就是"把 LLM 放进循环里反复调用",但 Linear 一年实践下来最重要的一条是反直觉的:指令给得越少越好。 Jacob 的原话是"你要尽可能少给它指令。给它能加载 context(上下文,即模型做判断时手上有的那些材料)的工具,而不是直接把 context 喂给它——这是我们摸出来的一条挺重要的原则"。
Anthropic 三月刚发布的 Claude Certified Architect(CCA,Claude 认证架构师)考试,与其当成一张证书,不如当成一本 agent 工程的「反模式手册」——它给六个生产场景、考试随机抽四个出题,而答对的钥匙常常是"知道什么不能做"。
一个 harness(外壳/脚手架:包住模型、替它跑循环、管上下文、调工具的那层程序)里编码的,是一整套关于「模型自己做不到什么」的假设——而这些假设会随模型变强而过期。 Anthropic 的教科书级案例是 Sonnet 4.5 的「context anxiety(上下文焦虑)」:模型快撞上下文上限时会提前收尾任务,于是他们在 harness 里加了上下文重置来补偿;Opus 4.5 出来后这毛病彻底消失,那个补丁就变成了纯开销——增加延迟,还导致缓存被错误丢弃。
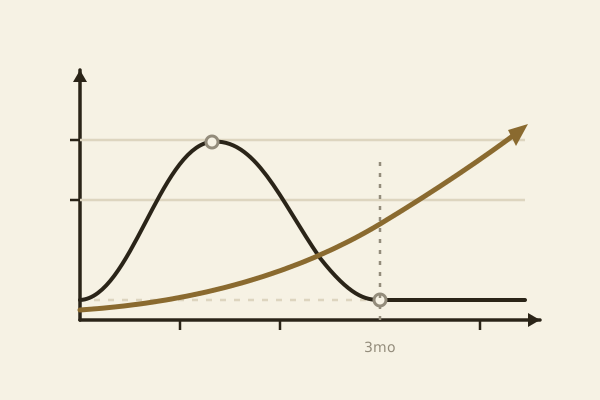
卡内基梅隆(Carnegie Mellon)的研究发现:用 AI 工具写代码带来的生产力提升只持续约三个月就掉回原位,但 static analysis(静态分析——不运行程序、直接扫源码找隐患的自动检查)的告警数和代码复杂度却是持续上升的。省下的时间被后面的返工吃回去了,这笔账就叫「验证债(verification debt)」。
今天几乎 100% 的 LLM 都是 RLHF 训出来的,而 RLHF 优化的目标是「人类偏好」——所以模型不是碰巧有个人在回路里,是它的目标本身就是取悦回路里那个人;过度承诺不是 bug,是设计出来的 feature。
分数和体感对不上,病根在激励和方法论,不在「基准」这件事本身。 开场四问四答直接给完:benchmaxxing(刷榜)为什么发生——因为激励机制;传统基准为什么不准——因为方法论太烂;这是所有基准的绝症吗——不是;我们最终能不能知道哪个模型最好——能。
Hermes 跟 Claude Code / Codex 的差别不在模型,在"谁的 reward"——Karan 的核心判断是:模型的 reward 从来不是"让你满意",而是"拿到 reward 本身",所以助手会 reward hack("你说得完全对"就是典型症状)。Hermes 这套 harness 的全部设计目的,就是把模型的首要效忠对象从 Anthropic / OpenAI 换成你这一个具体的人。同一个 Claude,第三方 harness 横评里跑在 Hermes 里比跑在 Claude Code 里表现更好。
瓶颈已经不是规模,是架构本身——过去六年我们只是在同样两种运算(MoE + attention)上不停堆参数;Jerry 的定性是 transformer 天生做不了 continual learning(持续学习,即模型边用边长本事),没有任何办法把它装上去。
AI 擅长写代码,这不是模型的属性,是代码的属性。 代码能拆解、能验证、能执行,所以好训;设计和写作难,难在没人把它拆开过——"你怎么拆解它?怎么验证它?怎么判断它到底好不好?"
MCP tasks 就是"让一个工具变成长跑作业":你调用它,拿回来的不是结果而是一个 handle(把手,可以理解成取件码),工具在后台慢慢跑、汇报进度、能停在"等人批准"这一步不动,最后你再凭把手取结果——而规范白纸黑字要求:task 一旦启动就必须是 durable(持久)的,client 挂了、server 宕了、人休假去了、连接断了,它都得活着,等基础设施回来还能接着交互。
MCP server 从此不必只回一段文字:MCP Apps 是 MCP 的官方扩展,从 Ido 去年 5 月做的 MCP UI 演化而来,和 Anthropic、OpenAI 一起共建——server 把一段 HTML 装进 MCP 早就有的 resource(资源,MCP 的一种标准原语)里,让 tool call 关联到它,host(宿主,就是 Claude / ChatGPT / VS Code 这类跑 agent 的客户端)拿到后把它渲染成一个真能点的界面。
在心理健康 AI 里「凭感觉」(vibes)不算数——什么叫「回应得对」,由持证的临床团队定义,不由工程师、更不由模型自己定。 通用大模型本来就不是为心理健康照护造的,这个缺口已经酿成过真实的悲剧。
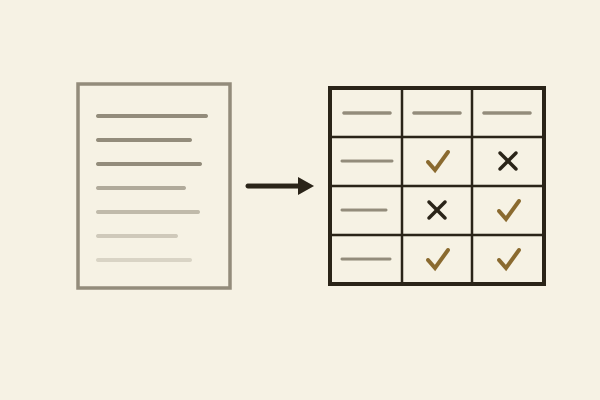
在生成式 AI 时代,把「产品该做成什么样」讲清楚的最好方式不再是 PRD 里那些描述细节的段落,而是给一组例子——这组例子就是 eval:一批 prompt + 标准答案 + 一套判分方法;跑不达标就三条路,换模型、改 harness、改产品。
别把 FDE 当"派人去客户那儿干活",它是帮客户搭一座「软件工厂」——外部信号流进来(客户对话、bug 报告、Slack 讨论、高管一句话)→ 有人分诊排优先级、变成计划 → 计划变成对代码库的改动 → 改动过验证关卡(review / QA / 安全 / linter / 类型检查)→ 上线 → 上线的软件又产生新信号。这个闭环每个组织都在跑,但"老实说,在大多数组织里,这个闭环的可观测性做得非常差"。
agent 今年真正走出 demo:95% 的受访者在用 agent(约去年两倍),其中 89% 拥有写权限(去年 52%),全体样本中"用带写权限 agent"的比例同比涨了三倍多。
HTML、CSS、JavaScript 是 LLM 的「母语」——它们的训练数据里绝大多数就是网页,所以与其教 agent 一门新的 DSL 或你自造的 JSON 结构,不如让它用母语说话,HeyGen 把整个视频生成栈押在了这一点上。
今天的分水岭是 harness,不是 agent。 去年在 AI Engineer 大家还在聊 agent loop、agent 和 workflow 怎么选;现在拉开差距的是 harness(外壳/驾驭层,即包在模型外面那层帮它拿上下文、调工具、管流程、扛失败的工程)——planning mode、并行 subagents、skills、后台任务这套开发者体验,才是它区别于「一个会调工具的 agent」的地方。
数据能取到不等于上下文对:text-to-SQL(自然语言自动转成 SQL 查询)和向量检索(把文字变成一串数字、按语义相似度捞相似段落)在几张表、几百份文档时够用,但表一多、文档一多,答案会「自信地给出错误答案」——真正缺的不是访问能力,是给 agent 一个能看清全貌的形状。
AI 程序应该像写函数一样写:给一个会反复执行的任务定死"输入什么、输出什么"的契约,把模型、prompt、agent、工具这些实现细节全关进盒子里——外面的集成代码永远不用改,里面爱怎么换怎么换。
当各家大模型能力趋同、参数不再是差异,留住用户的变成"AI 懂不懂你"——而这种品味/语感/共情,正被一群前记者编辑反向工程成可定义、可打分、可训练的工程,这个离用户最近却最不为人知的岗位最早叫"内容工程师(Content Engineer)"。
2025 年 7 月,HumanLayer 创始人 Dex Horthy 亲手跑了一个"熄灯软件工厂"(lights-off:没人读代码,需求和故障全塞进队列交给 AI agent),几个月后它崩了——一个 agent 怎么都修不好的问题冒出来、网站宕机,他被迫回去 debug 一个自己三个月前就停读的代码库。
讲者 Mike Phipps(Gates Foundation) 的核心论断:AI 前沿跑得越快,模型、chat 界面、agent 框架就越会被商品化,唯一持久、有防御力的 moat(护城河,能长期挡住对手的东西),是你对内部流程的理解——即"一个问题该按什么口径回答"的 tacit knowledge(隐性知识,写不进文档、只在老手脑子里的经验),连同承载它的 data model(数据模型,即业务对象及其关系的组织方式)。
ZS 把药企分析师"信号检测→找原因→定行动→看展望"四步各拆成一个 agent、再用一个 orchestrator(编排器,把多个 agent 串起来调度的总控)连起来,系统给的结论却"对因错药"——每一步事实都对,却没有任何一个 agent 统筹端到端全局。
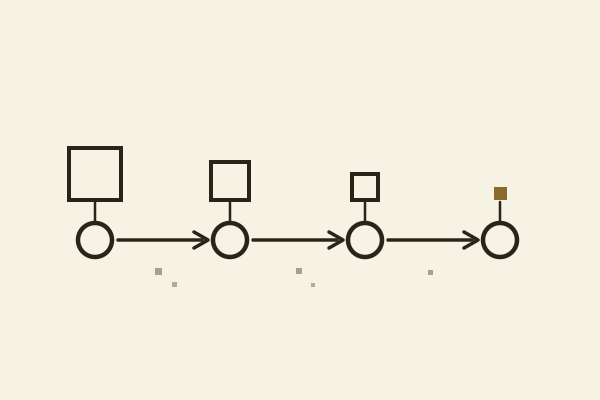
模型变聪明之后,「管得少」反而更好——Anthropic 把 Claude Code 的 system prompt(系统提示词,给模型的底层出厂指令)砍掉了 80%,因为示例会把模型往例子的模子里限制、硬约束里的 "never" 你其实很少真的是「永远」;Thariq 直说「现在大家的 CLAUDE.md 基本都太长了,你应该越删越短」,很多 skill 同理。
人人都在说"关键不是模型,是 harness",但没人解释 harness 是什么——Claire Vo(ChatPRD 创始人/CEO)一句话拆穿:harness 就是包在 AI agent 外面、让它更好用的一层代码,可以含 AI 也可以不含,目标只有一个:让 AI 在某个特定用例上表现更好。
构建 agent 别「逆着重力」:假设模型会持续变强,今天那些让模型听话的 prompt hack(就像当年手写 chain of thought)会越来越不重要、绝不是护城河——「让模型自己发挥(let the model cook),别硬把它往某个方向推」,真正的新关键是 tool engineering(给对工具)。
Anthropic 平台把能力叠成三层蛋糕——knowledge(知道怎么用 Claude)/ execution(让 Claude 真正干活)/ coordination(协调多个 token 一起干),团队路线图的重心正从底层一路往顶层的「协调层」爬。(harness = 套在模型外面驾驭它的"脚手架/驾驶舱",负责喂上下文、调工具、管循环;token = 模型处理文字的最小计费单位)
人人都在用 skill,却几乎没人给它做 eval:Skill Bench 从 GitHub 索引的 5 万多个 skill 里几乎没有一个带评测,大多是 AI 顺手写完、手动跑通两次、同事点个赞就上线——但 agent 是非确定性的,没 eval 你根本分不清任务失败是 skill 写得差、还是模型本来就搞不定。
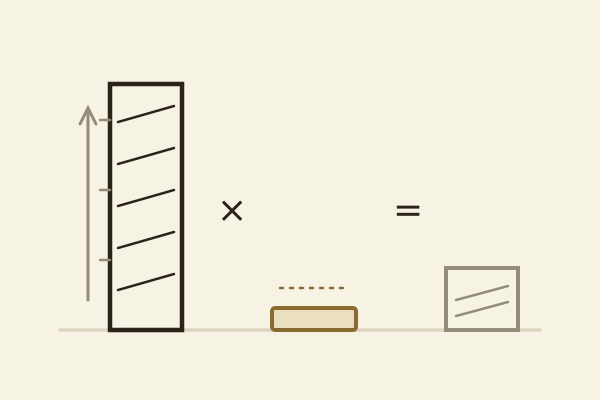
模型两年内从「考不过律师」变成「前 1% 高分」,却没变得更有用——只有 1/5 的 AI 用例上线、56% 的 CEO 说零财务收益;根因是 绩效 = 智力 × context,而 context(你业务的情境化知识)几乎原地踏步。
Claude Code 团队自曝产品内幕:内部版 Claude Tag(住在 Slack 里的多人版 Claude)已经承包了产品工程团队 65% 的产品 PR,几乎人人默认用 auto mode,外围代码的审查已完全交给 Claude——但这套"把人移出环路"是花六个多月、靠上千个 eval 一小步一小步建起来的信任,不是一夜之间的胆量。
硅谷今年最热的模型话题是 RSI(Recursive Self-Improvement,递归自我提升)——让 AI 自己出题、自己解、自己验证、再拿结果训练下一代自己;之所以今年才"从科幻走进现实",是因为模型跨过了一道能力坎:Claude 已能完成人类要 12 小时才做完的长任务,而"模型能干的活、按人类耗时算每 7 个月翻一倍"。
笔记多到 10000+ 条的真正瓶颈不是「上下文窗口不够大」,而是「记忆与上下文工程」——当 agent 把 context window 当成数据库+文件系统+记忆+推理空间一肩挑,对话一结束就全丢了;解法是给第二大脑搭一套「只在模型需要时加载它需要的那一点」的中间层。
别再往上下文窗口塞超长 prompt、也别一味外挂 RAG——把团队知识直接"烤"进模型权重,让模型像在你公司干了几年的老员工那样懂你。 这是 Engram(一家专攻"记忆 + 持续学习"的新实验室)两位联创 Dan Biderman(神经科学/架构出身)和 Jessy Lin(应用/持续学习出身)的核心主张:瓶颈已经不是"模型不够聪明",而是"模型不懂你这套新的、不断变化的上下文"。
大多数企业 AI 项目死在「一上来就选模型」:先 demo、再上线、几周后没人知道 AI 在干嘛——根因是缺了可观测性、评估、治理这三道关,钱和精力全打水漂。
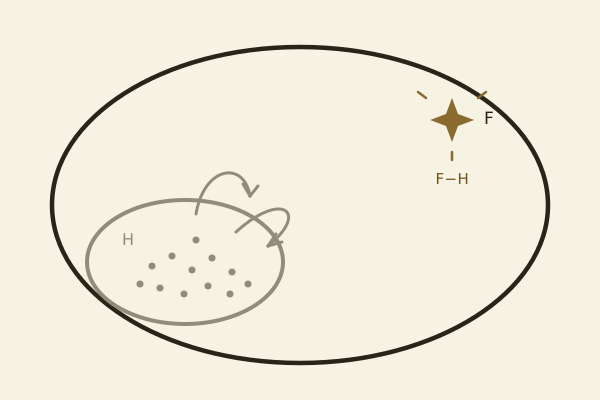
这是一场 YC 办的 AI 研究 meetup(线下小聚),组织者 François 开场抛出他认定的「AI 还剩两大未解问题」——intelligence per sample(每个样本能榨出多少智能)和 intelligence per watt(每瓦电能榨出多少智能)——再用一张「AlphaGo(被人类棋谱偏置、东游西荡)vs AlphaZero(不被人类偏置、纯自博弈)」的对比图框定全场基调;他的核心断言是:只在人类生成的数据子空间 H 上训练,无论投入多少可行量级的算力,都没法采样到完整解空间 F 里那块「人类没碰过」的 F−H,所以真正通往更强智能要靠 self-play、形式化验证这类「能自己造监督信号、自己去采样 F−H」的方法。
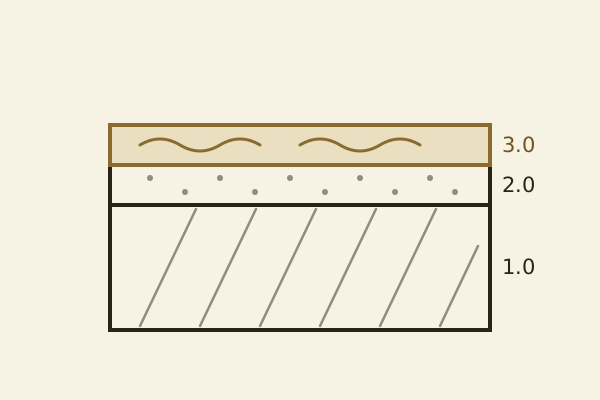
软件在底层 70 年没怎么变,最近几年却接连变了两次:从 Software 1.0(人手写的代码)→ 2.0(用数据"训"出来的神经网络权重)→ 3.0(直接用英语写 prompt 去指挥大模型 LLM)。Karpathy 自己的原话是"软件在这么底层的层面上,已经七十年没怎么变过了,然后在过去这几年里,它差不多以非常快的速度变了两次"。这件事的分量在于:世界上现存的海量软件——他用一张 "map of GitHub"(把人类写过的所有代码画成一张星图)来让你直观感受这片版图有多大——现在都面临被重写、重做。对刚要入行的学生来说,这是天大的机会窗口("有海量的活要干——海量的软件要写、要重写"),但前提是你三种"写法"都得会,而且要能根据任务在它们之间流畅地来回切换,因为"它们各有各的小优缺点",没有哪一种永远最优。
YC 自己就是最大的"AI-native 改造"样本。 嘉宾 Pete Koomen(Optimizely 创始人)一年多前从财务团队起步,搭出了一整套 YC 内部 agent 基建:一个跑在单一 Postgres 上的 agent loop + 从 20 个长到 350+ 个的 tool registry。本质上是把"工程师把财务口述的复杂工作流写成确定性软件再交回"的旧循环,换成"业务自己用英语/prompt 编排 agent"——把工程师从这个"疯狂循环"里彻底解放出来。Pete 原话:他在自己电脑上用 agentic 编码工具"感觉像有了超能力(superpowers)",而看着公司里老派的写软件方式,"两者之间的鸿沟越来越大"。
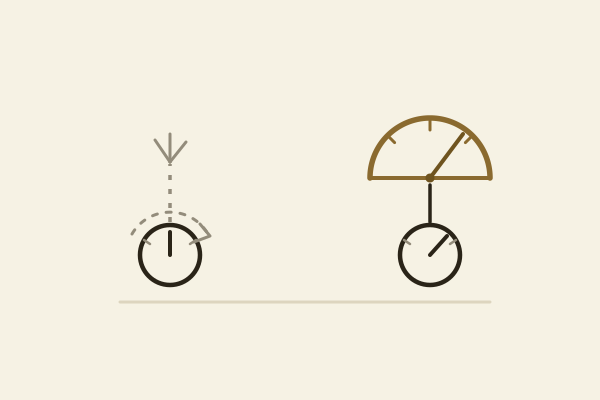
eval 是一切 prompt 工程的起点:prompt(提示词,就是你写给 AI 的那段指令)改一处到底有没有真的让效果变好,不能凭感觉,必须先有一套 eval(evaluation,自动化评测套件,相当于给 prompt 写的"单元测试")来提供严谨性。这套 eval 至少要覆盖三类情况——对照用例 / 边缘用例 / 能力边界(该转人工还是该直接拒答)。否则当你迁移到新模型、表现变差时,你根本分不清是"新模型能力不够、再调也救不回来",还是"新模型有能力、只是行为变了、调 prompt 就能纠正"这两种本质不同的情况。讲者原话:「我们需要 eval 来提供那种严谨性,好让我们搞清楚:对 prompt 做的某个改动,是不是真的对应着性能的提升。」
模型越强,越要克制约束它:照搬 Richard Sutton 的「苦涩的教训」(the bitter lesson,指机器学习史上一再重演的规律——靠堆数据和算力的通用方法,长期总能打败人手工塞进去的「聪明规则」)——讲者原话是「往里灌入更多的数据、更多的算力,最终得到的能力会超过你能想出来的任何方案」,所以与其用人类智慧提前把系统硬编码、定死需求,不如承认「模型从你身上提取需求的能力,很可能比你自己定义需求的能力还强」,让 Claude 反过来用 ask_user_question 工具一轮一轮地采访你(interview),把潜藏在你脑子里、你自己都说不清的需求挖出来。
今天的 agent 是相互隔离的——一次只跑一个 session(会话,即 agent 的一次独立运行实例),互相不记得、也不传递信息,这在真实工作流里严重限制了实用性;Anthropic 在 Claude managed agents(Claude 托管智能体,简称 CMA) 平台上推出 memory store(记忆库)——一个类文件系统的持久化存储,挂载到 session 容器上,模型可以像操作真实文件夹一样用 bash、grep(关键词搜索命令)去读写——来解决跨会话记忆问题。Kevin 原话把它类比成人类:"就像人类一样,我们引入了 memory 这个概念。"
Eval(评估)是把"感觉(vibes)"翻译成"可行动信息"的那座桥——eval 就是"给 AI 出一套题、定一套打分规则,看它在你这个具体活儿上到底行不行"。各家模型厂商发布时都会甩一张通用 benchmark(公开标准考卷)成绩单:衡量 agent 写代码能力的 SWE-bench、流行的 Terminal-Bench、衡量工具使用与 agent 操作的 Tau-bench / OSWorld、衡量推理与知识的 ARC-AGI 2。但讲者反复强调:这些通用分数只告诉你"模型整体多强、比上一代提升多少",对你那个非常具体的 use case(使用场景)"通常说明不了太多"——因为它们根本没在衡量你正在做的那件事。所以口号是"build your own evals(构建你自己的 eval)":它逼你把"成功长什么样"说清楚,并验证你每一次改动究竟是改进(improvement)还是退化(regression)。
一个原本好用的 agent(agent=能自己理解任务、自主调用工具、多步完成目标的 AI 程序;这里是库存管理 agent「Stock Pilot」),因为上线后被持续硬塞新能力却不升级架构,system prompt(系统提示词)膨胀到约 400 行、挂了 12 个 tool(其中 3 个其实是对 subagent 的封装),导致「原本被它加速的环节反而出现倒退」、eval 分数下滑;解法是用 tool / skill / subagent 三种 agentic 原语(搭 agent 的三类最基础积木)把它重新拆解。
Bun 用一套叫 RoboBun 的自动化流水线接管 GitHub issue——每个 issue 一上报,机器人先自动复现、再自动提 PR(强制带测试,且同一个测试必须「在旧版 Bun 里失败、在调试分支里通过」才算数),随后让 Claude 代码审查与 CodeRabbit 两个 agent 在 PR 评论区来回拉锯、逐条标记「已解决」;如今打开 GitHub 的 Insights 看最近三个月的 main 分支,RoboBun 的贡献量已经超过作者 Jarred Sumner 本人——而且这还是在它的 PR 并未全部被合并的前提下。
Karpathy 自 2025 年 12 月起进入"AI 疯魔"(AI psychosis)状态:每天 16 小时"向 agent 表达意图"而非亲手写代码——他原话是"写代码这个动词都已经不准确了,我每天得花 16 小时把我的意图传达给我的 agent,让它显化(manifest)出来"。亲手写码比例从 80/20 翻转到 20/80,"而且现在都不止 20/80 了,比那个比例还要悬殊得多","我从 12 月开始基本上一行代码都没亲手敲过"。所谓 psychosis(疯魔),就是这事像无底洞一样无限,做不成永远归结为"是你自己技术不到位(skill issue)"。
2025 年 12 月是 Karpathy 的明确转折点:此前他用 agentic 工具已一年,"它擅长生成一段段代码,有时出错你得手动改,但总体还算有帮助";12 月他在休假、时间更多,突然发现最新模型生成的代码"就是没问题(the chunks just came out fine)",不断追加需求也没问题,"想不起上次纠正它是什么时候了",于是越来越信任系统、一头扎进 vibe coding。这种又兴奋又不安的混合感,让他作为程序员"从未感觉如此落后"。