让 agent 记住事:Anthropic 给它加了记忆库,还让它在后台「做梦」
- 一今天的 agent 是相互隔离的——一次只跑一个 session(会话,即 agent 的一次独立运行实例),互相不记得、也不传递信息,这在真实工作流里严重限制了实用性;Anthropic 在 Claude managed agents(Claude 托管智能体,简称 CMA) 平台上推出 memory store(记忆库)——一个类文件系统的持久化存储,挂载到 session 容器上,模型可以像操作真实文件夹一样用 bash、grep(关键词搜索命令)去读写——来解决跨会话记忆问题。Kevin 原话把它类比成人类:"就像人类一样,我们引入了 memory 这个概念。"→ 详细
- 二agent 长期读写 memory store 会"一股脑堆信息"("start just kind of dumping information")导致记忆库无限膨胀、杂乱、过时;为此推出 dreaming(做梦)——一个异步(后台跑、不占用 agent 实时工作)、非破坏性(绝不动原始记忆库)、多 agent 协作(一个 orchestrator 总指挥 + 每个输入 session 配一个 sub agent 子智能体)的批处理 harness(运行框架),对记忆做事实核查、补全细节、整理去重、建索引,最后产出一个增强版的输出 memory store。→ 详细
- 三session(临时的单次对话实例)、memory store(把信息跨 session 连起来)、dreaming(随时间组织/丰富/改进记忆)是三个可组合的层次(three composable layers);dreaming 在设计上刻意追求"穷尽式"(exhaustive by design,给 100 段记录就把 100 段全过一遍不漏),因而 token 消耗大,但靠约 95% 的缓存命中率(cache hit rate) 加上类似 batch API 的错峰调度可享 50% 折扣等手段来压成本。→ 详细
开场与主讲人:Anthropic 工程师 Kevin 的 workshop 主题
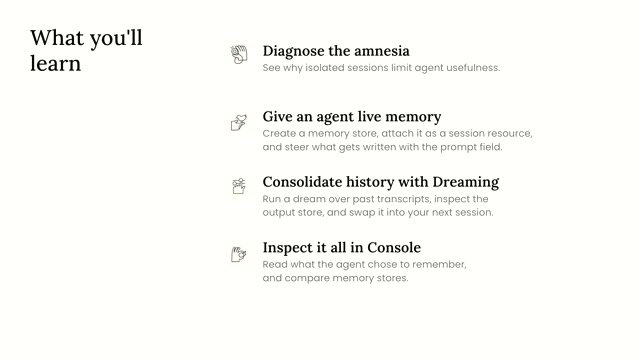
主讲人 Kevin(Anthropic 工程师),属 Code with Claude 大会 workshop 系列,主题"怎么构建有记忆的 agent"。痛点:今天 agent 的 base case 是"相互隔离的,这在很多真实工作流里限制了它们的实用性"。议程四段式:①base case,看 agent 隔离的局限;②新发布的 memory store——"一个实时的 memory store,可以在多个会话之间读写";③dreaming——"让这些 memory store 随时间不断变好";④把这一切和 CLI、"超棒的控制台界面"串联演示。脚手架:之前 workshop 已讲过 CMA 的 agent environment + session 两个原语,本场就在其上"再加两个概念"——memory store 和 dream。→ 详细 → 详细 → 详细
两个核心新概念的定义:memory store 与 dream
- memory store(记忆库)——Kevin 的完整定义:"一个持久化的、类似文件系统的存储,它作为一种资源附加(attach)到你创建的 session 上,让 agent 能够跨会话读写信息。" 通俗讲:给 agent 挂一块"硬盘",这次会话写进去的东西,下次会话还能读到,不会一关机就清空。→ 详细
- dream(梦 / 做梦任务)——他的完整定义:"一个在后台运行的异步任务(asynchronous job)。它会查看一个输入的 memory store,以及你之前那一堆以文字记录(transcripts,即把会话完整记下来的逐字稿)形式呈现的会话,然后我们在这些内容上跑一套 harness(运行框架/流水线),把原本 agent 可能漏掉的新信息提炼出来。" 它具体做四类活:"比如事实核查(factchecking),还会对信息做整理、合并、去重(organize and consolidate and duplicate)",目的就一句话——"这样你的 memory store 就不会随着时间无限制地膨胀(don't grow unbounded over time)"。打个比方:白天 agent 拼命往记忆库塞东西,晚上 dreaming 像睡觉时大脑整理记忆一样,把杂乱的笔记重新归档、删掉过期的、补全模糊的。→ 详细
- 现场准备:Kevin 给出 workshop 代码仓库 URL,跑了仓库附带的 bootstrap 脚本(一键初始化)。这个脚本"给我们创建了一些种子信息(seed information)"——具体是"一个 agent,有一个 environment,还有几个之前的会话,内容涉及比如第一天的 keynote(主题演讲),以及一个之前的 workshop"。这批种子数据是后面所有演示的素材底座。→ 详细
问题演示(base case)第一步:写入一个"无记忆"的 session
现状:CMA 上"大多数情况下你一次只创建一个 session,而这些 session 都是相互隔离的",后果是 agent"不会记住过去的信息,也不会把信息传递给未来的会话"。Kevin 建第一个 session 取名 "write test with no memory"(用 bootstrap 的 agent + environment ID),console 里状态是 idle(空闲)。第一条消息发"昨天那场 CMA 演讲"的信息,塞了关键词 multi-agent orchestration 加一个 URL;agent 用 Sonnet。实际模型回:"好的,谢谢你告诉我这些信息。"——礼貌收下、无事可做。→ 详细 → 详细 → 详细
问题演示第二步:另一个 session 召回——证明信息没有传递
第二步建一个"重新测试"(retest)的全新 session("这几步我会走得快一点"),去问上一个会话刚学到的东西。结果与预期一致:新 session 答"嗯,我其实没有访问这些信息的权限(I don't really have access to this information),我可以从这几个方面帮你"。Kevin 切回幻灯片小结:"我们告诉了它一些东西,过会儿在另一个 session 里问它这件事,结果两个 session 之间没有任何信息传递(No information is transferred between the sessions)。" 赤裸裸的 base case——失忆。→ 详细 → 详细
memory store 的设计理念:为什么挂载成文件系统
- 解决思路直接类比人类:Kevin 说"就像人类一样,我们引入了 memory 这个概念"。再次强调 memory store"在 Claude managed agents 平台里是一个类似文件系统的存储",而且"在底层,你想创建多少个 memory store 都可以。所以你不一定非要把一个 memory store 限制在一个组织上"——数量不设上限,粒度灵活。→ 详细
- 边界由用户自定义:"你可以按用户创建,按 workspace(工作区)创建,等等。memory store 的边界怎么定,完全由你决定。" 底层机制:"这个 memory store 会作为文件系统挂载(mount)到 session 的容器上,模型有相应的 tool(工具)来读写它。" mount 就是把这块"硬盘"接到 agent 正在跑的那个隔离容器里,让它能直接访问。→ 详细
- 为什么偏偏选"文件系统"这个形态?Kevin 给出关键理由:"我们之所以把它挂载成文件系统,是因为这对模型来说是一个非常强大的接口(such a powerful interface for the model)。" 强大在哪——"你可以用 bash 之类的工具去探索这个文件系统,可以用 grep 来搜索关键词,还可以读取文件、做一大堆非常强大的事情。" 也就是说,不发明新 API,而是复用模型早已熟练的 Unix 命令行技能(bash 遍历目录、grep 全文搜词),这让记忆对 agent"更加实用"。→ 详细
创建 memory store:参数、console 查看与手动添加记忆
创建 memory store 的主要参数就一个——名字。Kevin 现场命名为 CWC memory,可"给它加一段简短的描述(description)";他预告"这里其实还有另外两个可以设置的参数",留到挂载 session 时讲(见第七节 prompt 与 access)。创建后在 console 的 managed agents → memory stores 下能看到它处于 active(激活)状态,"你可以点进去,看到一个文件系统查看器(file system viewer)","当然现在里面什么都没有"。除了让 agent 自动写,平台也支持手动添加记忆:"你可以在某个指定路径下创建一个文件,加上一些内容"——人类可预先往库里塞背景知识,不必全靠 agent 积累。→ 详细 → 详细 → 详细
把 memory store 挂到 session:prompt 引导与 access 权限
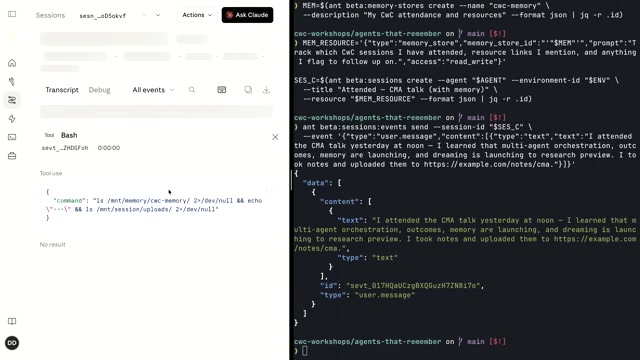
- 创建好后下一步是"在你的 session 里实际用上它"。具体操作:向 sessions API 请求里传入一个 memory store ID(记忆库的唯一标识符)即可。Kevin 把命令粘到终端"这样我们能看得更清楚"。→ 详细
- 第一个进阶参数是 prompt(引导提示):"你还可以给它一段 prompt,用来引导 agent 去读写特定的信息。" 他举了个完整例子说明用途:"你可能会希望它聚焦在某个特定的链接上,或者某个特定的关注领域上。比如说你在做一个投资 agent(investment agent),对吧?你想让它聚焦在某些特定的、需要为将来记住的东西上。那你就可以用这个 prompt 参数来实现。" 也就是说,prompt 像给记忆库配一份"该记什么、该忽略什么"的工作说明。→ 详细
- 第二个进阶参数是 access(访问权限)字段:"它默认是读写(read or write)。你可以把它改成只读(read only),这样这个 session 和 agent 就只能从那个 memory store 读取,不能更新它。" 这给了一道安全闸——比如让某些会话只查阅、不污染共享记忆。→ 详细
带记忆的演示:写入时模型主动保存到 memory store
Kevin 重复那个写测试,但这次 session 附带 memory store,发同样文本,"希望这次我们能观察到一个不一样的行为"。点进详情,关键差异立现:模型不再被动收下,而是"先去看 memory,看看'好,这次对话里有没有什么是我需要记住的'"——主动检索记忆库、判断该不该存档。因为库当前是空的,它"把我刚才告诉它的内容直接存进那个 memory store。它把内容存到了这个 sessions.mmd 文件里,而且很贴心地告诉我它做了什么"(sessions.mmd 即 sessions.md 口误,模型自行命名)。因果链值得注意:模型自己决定文件名、自己选择写入、还主动汇报——记忆是 agent 自驱的,不是人手动塞的。→ 详细 → 详细
带记忆的演示:召回时用 grep 检索并成功回答
用同一个 memory store 新建另一个 session,问它"从 CMA 那场演讲里找到了什么、学到了什么"——正是第四节"失忆"测试的翻版,唯一变量是这次有了共享记忆库。在 console UI 里能看到召回过程:模型"先去看它的 memory store 里有没有相关信息。它现在用 grep 来查找关键词,它在找 CMA",结果"找到了一大堆我们在上一个 session 里刚告诉它的信息,现在它就能回答我的问题了"。Kevin 给出本场第一个金句式总结:"这很好地展示了 memory 的威力(the power of memory),而这在以前其实是挺难做到的。" 一个空库 → 写入 → 换会话 grep 召回的最小闭环就此跑通。→ 详细 → 详细
memory store 的额外能力:列出文件、版本管理与直接编辑
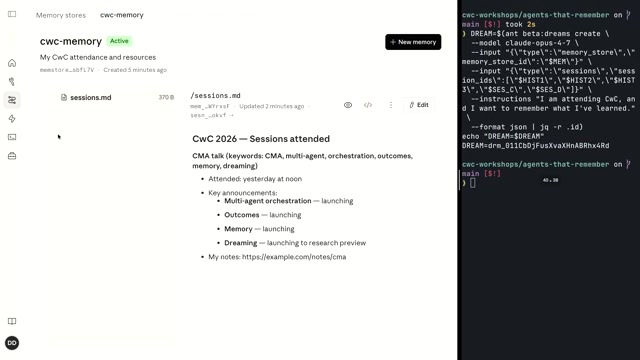
平台提供额外接口"手动检查 store 本身",三件:其一,CLI 可"列出 memory store 里所有的 memory 文件"(相当于 ls)。其二是版本管理(versioning):每个 memory 文件"都是有版本管理的,每次你对一个文件做改动,都会生成一个新版本"——改坏了能回溯。其三是人工直接编辑:UI 里能看到 Claude 建的子目录结构,且"你其实可以直接编辑这些 memory 文件……要是 Claude 写错了什么,或者你只是想补充更多信息,你都可以这么做"。Kevin 收束:"具体哪些 session 用 memory、哪些不用,完全由你来决定。"→ 详细 → 详细 → 详细
引出 dreaming:解决 memory store 无限膨胀、杂乱、过时的问题
- Kevin 点出 memory 带来的副作用,描述很形象:"当你的 agent 长期对这个 memory store 进行读写时,我们发现它常常会开始往 memory store 里一股脑地堆信息(start just kind of dumping information)。所以每次你让它做任务,它可能都会记录一些信息,随着时间推移,你的 memory store 就会越来越大。" 一句话:agent 是个"什么都想记下来"的囤积者。→ 详细
- 痛点的关键在于此前没有清理机制:"之前并没有一个真正的流程,能帮你去整理这些 memory、检查有没有过时的内容(stale)、合并重复的部分(consolidate any duplicates)。" 紧接着引出主角:"这就是 dreaming 派上用场的地方。dreaming 是一个批处理流程(batch process),同样是异步运行的,你来启动它。" 注意三个定语:批处理、异步、用户主动触发。→ 详细
dreaming harness 的工作机制:multi-agent、输入与输出
- 启动方式与架构:"你通过我们的 API 或者控制台来启动,它会跑一个我们构建的全新 dreaming 框架,这是一个 multi-agent 的架构(multi-agent setup)。" 输入怎么喂:"你要指定一个想让它去 dream 的输入 memory store,再配上一组你觉得可能有助于丰富这个 memory store 的 transcript。它会逐个去看(look through each one)。" 即"一个待整理的记忆库 + 一摞会话逐字稿"双输入。→ 详细
- 对每个输入它做的具体动作,Kevin 列得很全:"做事实核查,用更多细节去丰富,比如日期、具体的标识符(dates, specific identifiers)。然后它还会整理这些 memory 文件,看看有没有重复、有没有什么可以修正的地方。" 最终产物与价值:"它会产出一个输出 memory store(output memory store),这样将来你把这个输出挂到别的 session 上时,理想情况下能提升信息检索的效率(efficiency of information retrieval),也但愿能提升 agent 的智能水平(increase the intelligence of the agent)。" 因果闭环:整理记忆 → 检索更快 → agent 表现更聪明。→ 详细
创建 dream 任务:模型选择、输入规模与额外指令
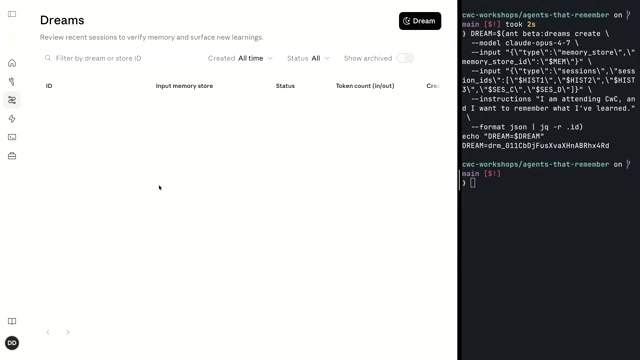
- 模型选择:Kevin 现场选 Claude Opus 4.7,可二选一:"你可以在 Opus 4.7 和 Sonnet 4.6 之间选,取决于你想要的质量水平,还有 token 成本之类的考量。"(质量高选 Opus、想省钱选 Sonnet。)→ 详细
- 两个输入与规模:接受"想让它 dream 的那个 memory store,以及一组 session id"。规模由用户定——"每次 dream 个 10 个 session,或者 20 个",上限"可以一直跑到差不多 100 个(all the way up to like a 100)",还在往上扩。→ 详细
- 额外指令(additional instructions):默认 prompt 已"会做一堆事情",可叠加定制,两类用法——其一回填细节("务必把这些细节补全 back fill these details"),其二规定结构("我想要 memory store 里有这种特定的结构")。即既能管"补什么",也能管"怎么排"。→ 详细
运行 dream 任务:状态轮询、观测性与建立在 CMA 原语之上
创建后返回 dream ID,在 managed agents → dreams 下查看,一开始 pending(等待),"很快就会开始运行";状态在 console 和 API 两边都能看,console 显示"输入的 memory store,以及一个 token 计数"。耗时取决于 transcript 大小/数量,"可能从几分钟到几个小时不等(a couple minutes to hours)"——这正是异步的好处,"这不是那种你想在 agent 工作的时候实时去做的事"。一个很酷的设计点是 dogfooding:"dreaming 其实是直接构建在 CMA 的原语之上的(built directly on top of CMA primitives)"——它为 dream 任务本身建了一个 session,点进去能看它在干什么、看到给它的 prompt,提供"相当不错的可观测性(observability)"、甚至能诊断问题。即 dreaming 不是黑箱,本身就是一个普通 CMA session。→ 详细 → 详细 → 详细
dreaming 的非破坏性设计:克隆输入、写入输出 memory store
- 底层多 agent 协作的分工说得很细:"dreaming 框架本身会启动一些 sub agent(子智能体)去查看你给它的所有 transcript。每个 sub agent 基本上都有一个 system prompt(系统提示,给子 agent 定身份和任务的固定指令),告诉它该做什么、该看什么,而 orchestrator(编排者/总指挥)负责确保所有 agent 都在运行,并在它们推进时把它们一个个启动起来。" 即一个总指挥调度一群专责子 agent。→ 详细
- 非破坏性(non-destructive)是核心安全保证,Kevin 反复强调:"我们其实完全不会去碰你创建的那个输入 memory store。所以这是一个非破坏性的过程。我们实际做的是,把你的输入 memory store 克隆一份(clone),变成一个所谓的输出 memory store。" 再补一句:"dream 任务基本上是往一个新的 memory store 里写,这样所做的任何修改都是非破坏性的。" 即原始记忆永远原封不动,所有改动只发生在克隆副本上——改坏了也丢得起。→ 详细
- 时长与轮询补充:"一般这大概要花一分钟左右,具体看任务跑得有多快。" 编程接口:"当你用编程方式来做这件事时,我们提供了一个 API,基本上你只要去查询这个 dream 任务,它就会带有一个状态,这样你就能轮询这个状态(poll for the status)。"——轮询即"隔一会儿问一次好了没"。→ 详细
dreaming 产出 diff:索引文件、补全信息与重格式化
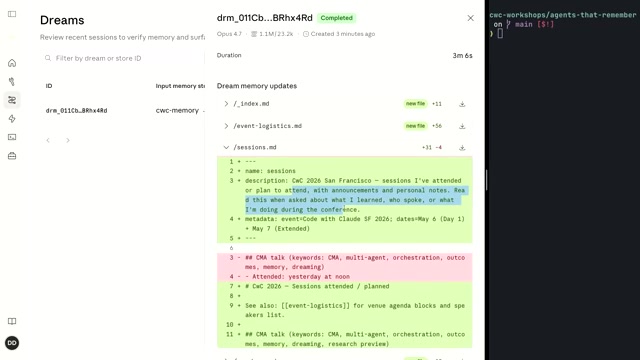
- 完成后 console 展示一份 diff(差异对比),"会给你展示它做了什么"。第一个产物是索引文件(index file):"dreaming 在这里创建了一个索引文件。这个索引文件里有这些 slug(短标识/词条),指向各种 memory 文件,将来某个 agent 可能会需要它们。" 它的价值——"让未来的 agent 去看一个索引文件、快速搞清楚自己要找什么,要比去做一次范围更大的 grep 高效得多(a lot more efficient than maybe doing a wider grep)"。即先看目录页,而不是每次全文扫一遍。→ 详细
- 第二是凭空补全了原本没有的信息:"它还在添加一些在我最初创建的那几个 session 里并不存在的额外信息。所以它创建了这个 event logistics(活动安排) 文件,给出了 Code with Claude 的完整日程。还有一堆人名。同样还有第二天的日程。" 这说明 dreaming 不只是搬运,还能从逐字稿里推断、归纳出新的结构化条目。→ 详细
- 第三是重格式化旧记忆:"它其实还把我在之前 session 里创建的那个 memory 文件重新格式化了一下。所以这次它加上了一个 slug、一段活动描述、一些额外的元数据(metadata),并再次补充了更多细节。" Kevin 给出团队的经验结论:"一般来说我们发现,信息更多其实确实能帮到未来的 session(more information actually really does help future sessions)。"→ 详细
为什么要写更多细节 + human in the loop 审核
- 一条很有洞察的设计哲学,Kevin 讲得完整:"直觉上想一想:当一个 agent 正在处理某个任务时,要预测它将来可能需要什么,其实是挺难的——这本身就是个更难的预测问题(a harder prediction problem)。所以把一些额外的细节写下来、让未来的 agent 能记住,其实是件好事。" 反方向的平衡阀也有:"而 dreaming 随时都可以回头去比如把不再需要的东西删掉(remove stuff that is no longer needed)。" 即写入时宁滥勿缺、整理时再做减法。→ 详细
- human in the loop(人在回路,指让人在自动流程的关键节点介入审核) 的落点:"如果我到这里的输出 memory store,点开它,你又能看到我创建的所有文件。这也是一个很好的方式,可以看清楚 dreaming 到底干了些什么。如果你想要那种 human in the loop 的审核流程,这个地方就特别有用——人可以进来看一看 dreaming harness 有没有犯什么错(made any mistakes)。" 即输出库的可视化 = 天然的人工质检入口。→ 详细
dreaming 的"穷尽式"设计原则
- 配合幻灯片的架构图,Kevin 复述整体:"这是一个多 agent 的 harness。我们有一个 orchestrator,它主要负责启动各个子 agent,而且我们会为你给它的每一个输入 session 各生成一个子 agent(one sub agent per input session)。" 即"输入几段会话,就开几个子 agent",一一对应。→ 详细
- 这么设计的根本原因,是本场的一个关键原则——穷尽式(exhaustive by design):"我们其实希望 dreaming 在设计上就是穷尽式的。如果你给它 100 段记录,Claude 会把所有信息都过一遍,确保它没有遗漏任何东西(not missing anything)。" 一段会话配一个专属子 agent,正是为了不让任何信息在批量处理中被略读漏掉——宁可慢、宁可贵,也要全。这也直接解释了第二十二节为何 token 消耗大。→ 详细
在未来 session 中使用输出 memory store 并对比效果
用之前的 dream ID 取回资源、拿到 JSON 里的 output memory store ID,新建 session 挂上它。验证提问:"我参加了哪些 session、我有哪些资源的链接、以及我标记了哪些需要跟进的事项(what follow-ups I flag)。" console 里检索行为变了——这次它能看到 Dreaming 做的所有东西(索引 + event 后勤安排),且是先开始读索引(reading the index first),正兑现第十六节的设计意图。效果对比是全场高潮证据:"这一次信息多了不少。它给了我一个回顾,把所有我参加过的 session 都列了出来,还加上了时间戳(timestamps),告诉我第二天的 session 和对应资源链接。" 结论金句:"这又一次很好地展示了 dreaming 是怎么真正丰富那些在 session 之间传递的信息的。"→ 详细 → 详细 → 详细
收尾管理:退役旧 memory store
可选的最后一步是清理:"在最后,如果你对这里的输出 memory store 真的很满意,你可以去把旧的 memory store 退役掉(retire the old memory store)。" 安全说明:"这不会影响你之前的那些 session,只是能把你组织里 memory store 的数量控制在一个合理的水平。" 即退役只是把旧库标记下线、瘦身管理,不会回溯破坏历史会话。→ 详细
三个可组合的层次:session / memory store / dreaming
- 这是全场的总框架,Kevin 用幻灯片把三者讲成三个可组合的层次(three composable layers)。第一层 session:"如果你把一个 session 看成是一个 agent 运行的独立实例(isolated instance of an agent running),它通常就是一个对话线程,一般来说是临时性的(typically ephemeral)。" 即单次、易逝、孤立。→ 详细
- 第二层 memory store 是对 session 的增强:"memory store 则是对它的增强(augments that)。这样一来,你就可以把信息在你的多个 session 之间连接起来,跨多个 session。" 即把一个个孤岛会话连成网络。→ 详细
- 第三层 dreaming 是对记忆的持续治理:"有了 dreaming,你现在就能随着时间不断地组织、丰富并改进你的 memory store(organizing, enriching and improving),这样当你的 session 数量越来越多、需要在这些 session 中处理的信息越来越多时,你的 memory 仍然能保持在一个合理的水平。它是可管理的,不会爆掉(manageable, doesn't blow up)。同时它还会检查诸如信息过期之类的问题(checks for things like staleness),确保所有信息都是最新的。" 三层叠起来:单次 → 跨次连接 → 长期保鲜。→ 详细
观众提问:token 用量、95% 缓存命中率与降本手段
- 现场观众问"总体上这个功能的 token 使用量大概是多少(token usage of this feature)"。Kevin 坦诚回应起点:"我前面说过,我觉得我们在设计上就是希望它是穷尽式的。所以我们确实预期它会用掉很多 token(use a lot of tokens)。" 即贵是设计的必然后果,不是 bug。→ 详细
- 但成本被缓存大幅化解:"好在因为大部分处理都是 agentic 的(绝大多数步骤是 agent 反复调用同一批上下文),所以大部分 token 其实是被缓存的(most of the tokens are actually cached)。我们预期在大多数 dream session 上,缓存命中率(cache hit rate,指请求能直接复用已缓存内容、无需重新计费计算的比例)能达到 95% 左右。" 缓存命中越高,实际花的钱越少。→ 详细
- 还有一揽子降本手段在探索:"类似我们的 batch API(批量接口),我们可以通过在不同时间调度任务来提供 50% 的折扣。" 以及"其他额外的 token 使用控制手段还包括切换模型(switching the model,如用更便宜的 Sonnet 替 Opus)、对 prompt 做更多的引导(让它少做无用功)、以及提供更通用的 token 预算控制(general budgeting of tokens,给任务设花费上限)"。即"错峰省一半 + 换小模型 + 收紧 prompt + 设预算"四条路并行。→ 详细
全场总结回顾
Kevin 给留场的人收尾复盘。先回顾问题:"我们讲了如今大多数 agent 面临的问题,也就是:怎么在多个 session 之间记住信息?我觉得这现在已经是一个相当公认的问题了(a pretty well-established problem now)。" 再回顾解法与副作用:"memory 是解决这个问题的第一步(the first step),你给 agent 一个地方,让它可以把信息倒进去、再从里面读出来。但我们也看到这又带来了一个问题:memory store 会随着时间无限增长。它们会变得杂乱无章,信息会过期。" 最后回到 dreaming 并致谢:"我们再启用一组 agent,它们唯一的任务就是改进那个 memory store,供将来使用(their entire job is to improve that memory store for future use)。" 结束语:"我要感谢大家来参加今天的 workshop。希望对你们有帮助,也希望到最后你们能学会怎么把 memory 集成到你们自己的使用场景里(integrate memory into your own use cases)。"→ 详细 → 详细 → 详细
闪电问答 / 收尾
本场为单人 workshop 演讲,无 lightning round(闪电问答)环节。演讲过程中主讲人 Kevin 复述了一个现场观众的提问并作答,已并入正文「二十二、观众提问」:
一页速记(金句 + 要点清单)
- 核心三件套:session(单次会话,临时易逝)→ memory store(跨会话的"硬盘",bash/grep 可读写)→ dreaming(后台"做梦"整理记忆,非破坏性)。
- memory store 为何选文件系统:"因为这对模型来说是一个非常强大的接口"——复用 bash 遍历、grep 搜词、读文件等模型已熟练的技能。→ 详细
- memory 的威力金句:"这很好地展示了 memory 的威力,而这在以前其实是挺难做到的。"→ 详细
- dreaming 四类活:事实核查 / 补全细节(日期、标识符)/ 整理去重 / 建索引。→ 详细
- 非破坏性铁律:"我们其实完全不会去碰你创建的那个输入 memory store"——克隆出输出库再改。→ 详细
- 穷尽式原则金句:"如果你给它 100 段记录,Claude 会把所有信息都过一遍,确保它没有遗漏任何东西。"→ 详细
- 写多一点的理由:"当一个 agent 正在处理某个任务时,要预测它将来可能需要什么,其实是挺难的……所以把一些额外的细节写下来其实是件好事。"→ 详细
- 关键数字:单次 dream 最多约 100 个 session;模型 Opus 4.7 / Sonnet 4.6 二选一;耗时几分钟到几小时;缓存命中率约 95%;batch 错峰省 50%。
联系方式
(本场为单人演讲,主讲人 Kevin 未在演讲中给出个人联系方式。出品方:Anthropic,Code with Claude 大会。)