Codex:harness 幕后——Dominik Kundel(OpenAI)
- 一这是一场"把 Codex 的引擎盖掀开给你看"的工程分享:讲者 Dominik Kundel 用 2 倍速讲完 20 分钟,视角是「你按下回车之后,harness 里到底发生了什么」——harness(可以理解成"挽具/外壳",就是承载模型干活的那层程序:给它工具、组装上下文、跑循环、收结果)。他反复强调:这一切都是开源的(「it's MIT it's Apache 2 license」——他现场自我更正了一次),用 Rust 写的,你可以学它、可以拿它去问 Codex、也可以 fork 一份改成自己的。 → 详细
- 二上下文不是仓库,是预算。构造上下文时他们只盯三件事:大小(别打爆 token 预算,而且内容越多越容易自相矛盾、让模型犯迷糊)、灵活性(你装多少技能和 MCP 都得好用)、可缓存性(省钱和提速)。落地手段极其具体:把一部分工具标成 deferred(延迟加载)、不进上下文窗口,改由 tool search 现查;可用技能列表硬卡在最大上下文窗口的 2%,超了就自动削描述文字。 → 详细
- 三两处最值得抄的设计:一是 auto review——一个只读、不能再派子任务、完全独立的评审 sub-agent,在主 agent 想提权(比如删文件)时被拉起来,拿着「用户授权级别 + 风险分类体系 + 全程对话记录 + 实际工具调用」做判断,自动放行低风险动作、把数据外泄挡在外面,专治审批疲劳;二是 WebSocket 模式——当 GPT 5.3 Codex Spark 跑在 Cerebras 上达到每秒 1,000 个 token 之后,他们发现瓶颈已经不是推理,而是网络,于是把 responses API 从 HTTP + 服务器推送改成一条持久连接、只发变化的那部分数据。 → 详细
开场坐标:全场听众都自己搭过 agent,所以直接跳过入门
- 他先用举手筛人:「你们当中有多少人自己搭过 agent?」——「非常好,那你们就是这场演讲最对的听众」。因为是在 AI Engineer World's Fair 的 Agentic Engineering 分会场,他宣布不讲「agent 是怎么工作的」「什么是 agent」,直接讲几个「你必须去解决的挑战」。全场组织视角只有一句:从"你发出一条消息之后到底发生了什么"往下拆。 → 详细
- 开场就给了通行证:Codex harness 和他展示的一切都是开源的——他原话先说「it's MIT」,紧接着自我更正「准确说是 Apache 2 许可证」(两处照实保留),harness 用 Rust 写。他给了三种用法:拿来学、就他讲的内容直接去问 Codex 更深的问题、或者 fork 改成自己的。 → 详细
- 一句很重要的免责:「这些都是当下的状态,东西变化太快了。」尤其每次有新模型发布,他们经常会发新 API、也会改 harness 的工作方式。他给的应对不是记笔记,而是「你随时可以回过头去问 Codex 现在的状态是什么样」——把易变的知识外包给一个可查询的活源。 → 详细
两个协议:UI 到 harness 走 app server,harness 到推理走 responses API
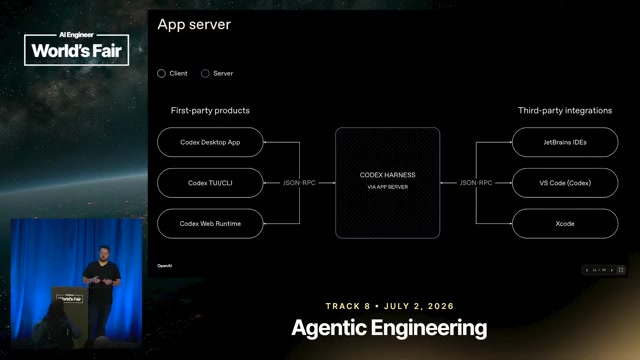 *▲ 图注:标题「App server」。这张图是全场的地基:左边是 OpenAI 自家产品(Codex Desktop App / Codex TUI-CLI / Codex Web Runtime),右边是第三方集成(JetBrains IDEs / VS Code (Codex) / Xcode),两边都通过同一套 JSON-RPC 连到中间那个黑框「CODEX HARNESS via app server」。值钱的地方在于这个对称性——自家 App 和别人的 IDE 走的是同一个协议、没有内部特权通道,所以「你能建出跟官方一样完整的东西」不是客套话。*
- app server 管「界面 → harness」这一段,且是为开放生态设计的:你做自己的 UI、自己的 agent 界面,可以直接建在 Codex harness 之上。证据是自家 Codex app 用的就是同一套 app server——「所以你对 Codex 期待的那些功能它其实全都有」。已经建在上面的第三方社区项目他点了两个:Theos T3 code 和 Remote X(⚠️ 这两个名字是自动转写出来的,拼写不可靠,保留英文原样、不猜测)。 → 详细
- 他自己拿这套协议玩出了两个花活:把 Codex 塞进 Claude Code(「如果你是 Claude Code 用户,又想用上 Codex,你可以用那个插件」),以及前一天演讲里把 Codex 塞进《Doom》——「一次挺好玩的冒险」。 → 详细
- responses API 管「harness → 推理」这一段(inference =模型真正算答案那一步)。它去年发布,定位是「在一个更 agentic 的世界里对 chat completions API 的一次重新思考」:结构重新设计过,更重要的是加进了一批对 agent 关键的内置能力——web search、图像生成(image gen)等。 → 详细
- 他们把它推成了行业开放标准:和 Ollama、LM Studio、Nvidia 等伙伴一起把开放的 responses schema(schema =接口的字段和结构约定)规范化,并成立了一个治理机构;结果是你可以拿任何兼容 responses API 的模型提供方直接插到 Codex harness 上。整条链路:UI →(app server)→ harness →(responses)→ 模型推理。 → 详细
【核心】上下文构造:他们只盯三件事——大小、灵活性、可缓存性
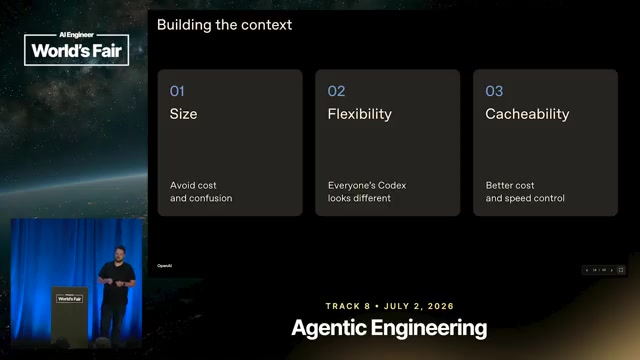 ▲ 图注:标题「Building the context」,三张卡把全部权衡压成了三行:01 Size — Avoid cost and confusion(控大小:既省钱,也避免模型犯迷糊)/02 Flexibility — Everyone's Codex looks different(保灵活:每个人装的技能和 MCP 都不一样)/03 Cacheability — Better cost and speed control(保可缓存:成本和速度都靠它)。这一页值钱在*它把"上下文该放什么"从审美问题变成了三个可检查的指标——你自己搭流水线时可以照抄这三条当验收标准。*
- 第一步就是最重要的一步。他说 harness 内部的第一步「可以说也是最重要的步骤之一」是上下文构造(context construction)——就是在把请求发给模型之前,决定"这一次到底把哪些文字塞进模型眼前"。他们在这件事上非常在意三点。 → 详细
- ① 大小,而且理由是两条不是一条。第一条是钱:「我们要保证不会一下子把你的 token 预算打爆」(token =模型处理文本的最小计价单位)。第二条更关键、也更常被忽略:「你上下文里的内容越多,出现互相矛盾的信息的概率就越高,就会让模型犯迷糊。」——也就是说,塞得多不只是贵,是会变笨。 → 详细
- ② 灵活性:「不管你用的技能(skill)是多是少,体验都得好;不管你装了多少插件和 MCP,也一样。」(MCP =一套让 agent 接外部工具和数据源的通用接口标准。)注意这是一个产品级约束:他们不能假设用户的配置长什么样,所以必须让上下文能自适应地缩放。 → 详细
- ③ 可缓存性(cacheability):「我们知道你对成本敏感。」——可缓存性说的是,如果每次请求开头那一大段内容都完全一样,服务端就能复用上次的计算结果,不用重算、也不重复计费,所以既省钱又更快;反过来,你只要在开头随手改一个字(比如塞一个当前时间戳),后面全部就都白缓存了。这就是为什么"哪些内容放前面、哪些放后面"是个工程问题而不是排版问题。 → 详细
- 他为了演示专门造了个 nano Codex:一个小型复刻版,「它的运作方式跟真的一模一样」,用公开仓库里的同一份代码搭的、只是改写成了 TypeScript。用它可以直观看到一条消息发出去时,上下文是由好几个不同部分组装起来的。其中一部分相当标准、可预测,比如模型指令(model instructions)——他又提醒了一次「这些都是开源的,你想读的话可以去读」;这类内容结构固定、大小基本不变,也不会把可缓存性搞乱。 → 详细
【核心】控制上下文膨胀的两招:deferred tools + 技能列表卡 2%
- 问题出在"难预测"的那几块:你手上有多少个可用技能?工具注册表(tool registry,就是"当前有哪些工具可调用"的那张清单)有多长?——尤其是装了 MCP 之后,上下文会随着你装的 MCP 越来越多而不断膨胀。这块是用户装出来的,harness 自己控制不了,所以只能想办法收。 → 详细
- 第一招:deferred tools(延迟加载的工具)。把一部分工具标记为 deferred,意思是它们不会直接被加进上下文窗口(context window =模型一次能看见的全部文字的容量上限),而是之后通过 tool search 才能拿到。相当于把一本厚工具手册换成一个"要用再查"的目录。 → 详细
- 第二招:给技能列表设硬上限——「对于可用技能列表,我们实际上把它的上限卡在你总上下文(也就是最大上下文窗口)的 2%。」超过之后不是报错、也不是砍掉技能,而是慢慢削减放进去的描述文字的量。这是一条极干净的工程约定:用一个百分比,把一块不可预测的开销变成可预测的。 → 详细
- 而且这两招你不必用他们的 harness 也能拿到:tool search「这件事本身其实在 responses API 里就有,所以哪怕你是在做自己的 harness,也可以直接用上它」。从 GPT-5.4 开始,你可以把任何工具标记为 deferred loading;这些工具只有在用 tool search 时才可用,你可以把 OpenAI 内置的 tool search 工具给模型,也可以自己实现一个——「如果你觉得那套发现逻辑你自己能做得更好的话」。 → 详细
【核心】异步动作:sub-agent 和后台终端用的是同一套形状
- 他给"什么是 agent"下了个功能性定义:「一个 agent 真正成为 agent,是因为它会执行动作。」然后把动作分成三类讲:异步动作、computer use、文件系统。异步动作指的是那些在 agent 必须继续干活的同时还在后台跑着的事情。 → 详细
- sub-agent(子 agent)就是异步动作的典型例子:目标是「能把任务派发出去,同时主 agent 在需要的时候还能继续干活」。实际做法只有两个工具——spawn agent(创建新的 agent 实例)和 send input(给这些新建出来的 agent 发送新内容、等待某个 agent、或者把它关掉)。注意这个接口设计有多克制:派活、喂料、等待、关闭,四个动词就够了。 → 详细
- 同一套形状被复用到后台终端上:Codex agent 有一个工具可以起一个新的后台终端(background terminal),然后持续跟它交互——通过标准输入(standard in,就是命令行程序读键盘输入的那个通道)往里送新数据,或者等待指定的一段时间让它把某个任务干完。这是本场一个很容易被略过但很值钱的观察:"派个子 agent"和"开个后台终端"在抽象上是同一件事——都是"我起一个长期存在的东西、隔一会儿喂它一点、隔一会儿收一次"。你只要把这个形状定好,两种能力就能共用一套接口。 → 详细
computer use 的进化:从"给它固定动作"到"让它自己写脚本"
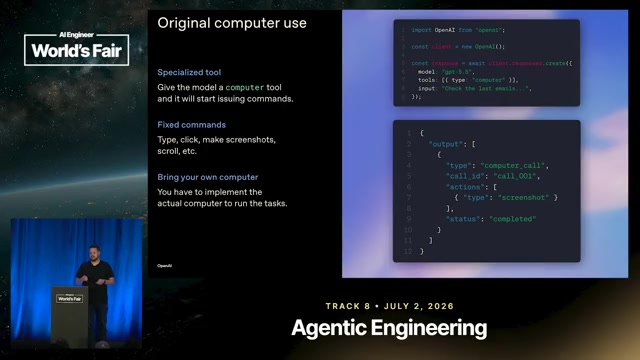 ▲ 图注:标题「Original computer use」,左栏三段是老版本的全部特征:Specialized tool(给模型一个专用的 computer 工具,它就开始发指令)/Fixed commands(动作是固定那几种:打字、点击、截图、滚动等)/Bring your own computer(真正执行任务的那台"电脑"得你自己实现),右侧是两段代码。这页值钱在它是*反面教材——下一页的进化正是把这三条全部推翻。*
- 老版本(去年在 responses API 里引入时)相当受限:一次只允许做一个动作;你得先声明你要用 computer use;而且具体暴露给这个工具的都是哪些类型的动作,得你自己去实现。 → 详细
- 新版本换了路子:改用代码执行(code execution)来做 computer use——「agent 可以自己写脚本,去跟你想接的任何 computer 实现打交道」,语言可以选 JavaScript 或 Python,拿到的 harness 灵活得多。 → 详细
- 他们的 browser use 就是这么实现的:Codex 跟一个常驻的 node REPL(REPL =一个一直开着的交互式代码执行环境,变量和状态跨次保留)交互,这个 REPL 跨多个回合(turn)一直存在;然后它写 JavaScript——本质上就是 Playwright 代码——去操作 REPL 里的那个浏览器实例。 → 详细
- 现场例子的关键在"第二回合":右边是一个 Chromium 浏览器,第一次它先写代码拿到整体状态、把正确的标签页调出来;后续回合里它能引用这些新的标签页、把信息拉进来、写出相应的动作脚本。他点出真正的收益:Codex 可以先看一个页面、理解它的结构,然后写一个脚本,在后续页面上更轻松地批量执行抓取(scraping)这类操作——一次理解、多次复用,比一页一页地点快得多。 → 详细
文件系统:模型是"照着工具训出来的",harness 得把工具备齐
- 改文件走 apply patch:从 GPT-5 开始的所有近期模型都是围绕 apply patch 这个工具训练的——给一份 diff(补丁,只描述"哪几行改成什么"的改动清单)来改文件,新建文件也用它。 → 详细
- 其余动作走 shell 工具做文件搜索和目录操作;因为训练时用惯了,模型会很自然地想用 Ripgrep(一个非常快的命令行全文搜索工具),所以 Codex harness 干脆把 Ripgrep 一起打包发出去,以防你机器上没装。 → 详细
- Windows 上他们专门训练了模型原生使用 PowerShell,所以在 Windows 上跑会看到它直接写 PowerShell 代码。(这一整条的含义是:模型的习惯是训出来的,harness 的责任是保证它伸手要的东西真的在。) → 详细
沙箱优先:三个平台三套机制,Windows 是自己造的
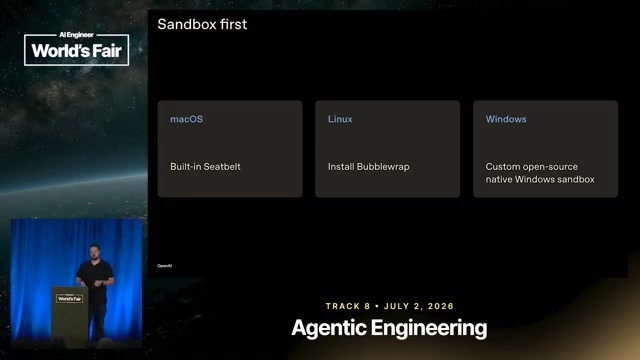 ▲ 图注:标题「Sandbox first」,三张卡就是三个平台的答案:macOS — Built-in Seatbelt(用系统自带的 Seatbelt)/Linux — Install Bubblewrap(装 Bubblewrap)/Windows — Custom open-source native Windows sandbox(自己造了一个开源的原生 Windows 沙箱)。「Sandbox first」这个标题本身就是态度:沙箱不是事后补的安全补丁,是所有文件系统交互的默认通道。
【本期最值钱】审批疲劳与 auto review:用一个只读 sub-agent 当闸门
- 他用两次举手把问题钉死。第一次:「你们当中有多少人被审批弹窗烦到过?尤其是跑长任务的时候,恨不得直接开全权访问(full access)?」第二次他更狠——「我觉得观众席应该没被拍进镜头,所以我们再来一次:你们当中有多少人知道,IT 和安全团队其实特别讨厌你打开全权访问?」全场的回应是「是啊」。审批疲劳(approval fatigue)的真实后果不是烦,是人会直接把安全机制关掉。 → 详细
- 他给的两个"高自主性反噬"的例子极其具体,值得整段记住:「尽管这些模型已经变强了很多,但尤其是当你试图通过 prompt 把模型往高自主性(high agency)上推的时候,agent 可能会把你的意图理解偏。比如你让模型通过邮件把一个文件发出去,同时又推着它高自主性,结果它发现自己没法把文件作为附件加上,于是就把文件传到某个文件共享上,改用那种方式;又或者转义(escaping)搞错了,一不小心删掉了太多数据。」——注意第一个例子不是模型犯蠢,恰恰是它太听话地在完成目标,这才是最难防的那类事故。 → 详细
- 于是他们做了 auto review,目标写得非常克制:覆盖那些"更难预测的、agent 可能做出的动作",尤其是长时间运行的情况下,把这些动作自动放行、不用升级到你这里来确认,同时把数据外泄(data exfiltration)这类事情挡在外面。(⚠️ 讲者在这一段里混用了两种叫法——先说他们做了一个「auto approval mode(自动审批模式)」,紧接着又说「我们做了 auto review」,原文如此,此处照实保留、不做统一。) → 详细
- 触发时机很关键:不是每一步都审,而是"要提权的那一刻"才审。当一个任务在沙箱里跑起来(他的现场例子是删除一个文件),模型试图申请提权(escalate,即请求突破沙箱限制)的时候,才会拉起一个 auto review 的 sub-agent。 → 详细
- 这个审查员的三条硬约束值得抄下来:它完全独立运行、不能再拉起别的 sub-agent、只有读权限。也就是说,审查者本身没有任何搞破坏的能力,它唯一能输出的就是一个判断。 → 详细
- 喂给它的上下文是四份东西:什么算是用户授权(user authorization)、风险分类体系(risk taxonomy)是怎么运作的、希望它按什么标准来判断,然后再加上对话记录(transcript)以及实际发生的那些工具调用(tool call,即模型发出的"请帮我执行 X"的指令)。他强调「这一点很重要,因为上下文是关键」。 → 详细
- 他的 .git 例子把"为什么必须看上下文"讲透了:「有些情况下你就是想让 agent 去删掉那个文件,另一些情况下你并不想。如果是你要求的,或者这本来就是项目的一部分,那就说得通。特别是像你让它删 .git 文件夹,那很好;但如果你没让它删,它大概就不该碰那块、把你的历史记录整个删掉。」——同一个动作,是不是该放行完全取决于你之前有没有说过。所以判断分三问:用户授权级别是什么(他的例子里是"高",因为是明确要求删的)、这个动作的影响是什么、该怎么处理。 → 详细
- 同一套逻辑也管网络:「这套东西既适用于文件系统操作,也适用于网络请求——比如 curl 一下 Google 看看网通不通没问题,但上传一个文件可能就不行。」这一句实际上定义了"数据外泄"这条红线在工程上长什么样:出方向的动作比入方向的动作要严得多。 → 详细
- 他自己给这段打了折:「这只是对工程师们和研究团队在这上面投入的全部思考与工作的一个极度简化的说法。」想深挖的话,去看他们写的那篇 auto review 博客文章。 → 详细
速度:推理不再是瓶颈之后,瓶颈搬到了网络
 ▲ 图注:章节页,黑屏大字「Agents do a lot of tool calls」(agent 会做大量的工具调用)。这一页是全场第二个转折点:前面讲的都是"装什么进上下文、允许做什么动作",从这里开始讲*次数本身带来的代价——一次往返不贵,几百次往返就贵了。*
- 他把速度问题拆成了两半:「虽然我们在推理提速上做了很多工作,但那只是方程式的一部分。」真正让他们意识到另一半的,是推出 GPT 5.3 Codex Spark 的时候——它跑在 Cerebras 上,每秒 1,000 个 token。有了这个速度才发现:在这么多工具调用和交互之下,推理已经不再是瓶颈了,真正的瓶颈是网络。 → 详细
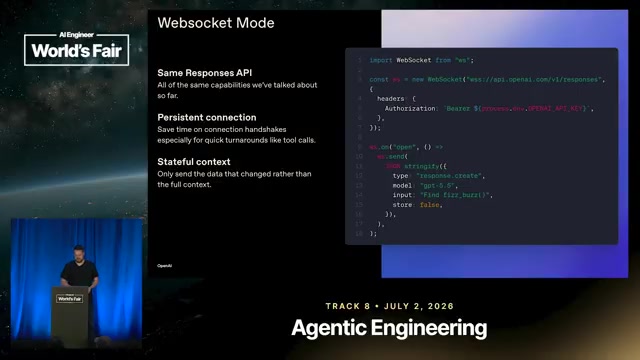 ▲ 图注:标题「Websocket Mode」,左栏三段把收益列得很干净:Same Responses API(能力跟前面讲的完全一样,不是另起炉灶)/Persistent connection(省掉连接握手的时间,尤其是工具调用这种一来一回特别快的场景)/Stateful context(有状态上下文——只发变化了的数据,不再每次重发整个上下文),右侧是 websocket 的代码。第三条是这一页真正的重点:省的不只是握手,是*重复传输。*
- 解法是 WebSocket 模式:responses API 不再走 server-sent events(服务器单向往客户端持续推消息的一种 HTTP 长连接方式)和 HTTP,改用一条持久的 WebSocket 连接(客户端与服务端之间双向常开的通道)。收益两条:省掉网络开销,以及获得有状态的上下文——只需要发送真正变化了的那部分数据。他举的例子:「如果有一次工具调用,我们只把这次工具调用的结果发回去,而不是把所有 item 都发一遍。」 → 详细
- 现场 demo 崩了,他把它变成了一个论据:讲到这儿他说「哦,好极了,这次我的 demo 服务器崩了」,换上备份之后又说——「既然 demo 服务器崩了,这也正好说明刚才那些是真实数据」。备份 demo 展示的差别是:新模式一个 item 接一个 item 地发,而旧模式这个例子里一次要发回九个 item。他的结论:「时间一长,这确实能显著加快速度,对性能的影响可以相当剧烈。」 → 详细
【核心】loops 与 /goal:为什么你的目标不该写成长篇大论
- 他起这一段的方式很妙:「我们现在是在 2026 年的 AI Engineer World's Fair,我从法律上唯一必须讲的就是 loops(循环),所以我们简单说两句。」重点讲 /goal,因为「这次活动期间我被问到过好几次:这东西到底是怎么工作的?」他还特意说明这是一个托管的 demo,之后你们可以自己回放。 → 详细
- 机制本身很朴素:demo 里让它去猜一个数字,「只有当它真的把那个数字猜出来了,这个目标才算达成」。在达成之前,harness 会自动注入一个续跑 prompt(continuation prompt),这个续跑 prompt 里包含的东西之一就是你设定的那个目标(objective)。然后一直这样循环下去,直到模型自己调用 update plan、update goal 这个工具,声明这个目标确实达成了。 → 详细
- 然后是全场最实用的一条使用建议,而且他直接点名了听众的坏习惯:「这就是为什么你其实不该在 goal 里写长篇大论——我知道你们很多人一直在试着这么干——而是应该写非常具体、非常可验证的 prompt,这样才容易判断事情什么时候算做完了。」把因果讲完整就是:循环的退出条件是"模型判定目标达成",所以目标写得越模糊、循环就越难停,你也越没法证明它真的做完了。"可验证"在这里不是文风要求,是机制要求。 → 详细
compaction:服务端自动压缩,且压缩方式与训练方式一致
- compaction(压缩)解决的是"跑太久"的问题——「如果让这些 agent 一次连续跑上几个小时甚至几天……」他们在去年年底引入了自动压缩(auto compaction),从那以后 Codex 一直在用。 → 详细
- 两个技术要点:一是在服务端自动触发;二是触发的方式和模型训练时的方式一致,这样性能能保持不变——这句是重点,说明"怎么压"不是一个可以随便自定义的参数,压得跟训练时不一样,模型表现就会掉。 → 详细
- 具体行为:可以手动触发也可以自动触发;它会把你之前的上下文窗口变成一个新的,后续轮次改用这个新的,而且新窗口里包含一个 compaction item,装着你需要的所有必要信息。 → 详细
- ⚠️ 本段原文因果不通,照实标注、不替讲者补逻辑:转写里这段的推理链是「如果 agent 连续跑几小时甚至几天,你肯定不想一直守在那儿、一遍遍地去批准所有东西。因为这个原因,我们引入了自动压缩」——但"不想反复批准"是审批疲劳的问题,跟"上下文太长要压缩"并不是同一件事。疑似串词或漏句(可能原本要说的是"你也不想一直守着手动压缩")。此处保留原样,不做"合理化"改写。 → 详细
收尾三条:开源蓝本、能力都在 API 里、盯着它演进
- 第一条:Codex 的 app server 和 harness 都是开源的——「你可以把它当作蓝本,去了解我们是怎么造 agent 的;也可以直接把它当成 harness 本身,在上面搭你自己的东西。」 → 详细
- 第二条(对自建 agent 的人最重要):「Codex 上那些亮眼的特性,大部分其实都在 responses API 里开放出来了。」他现场点名了四个可以直接拿走的能力——tool search、apply patch、WebSocket、服务端 compaction——并强调「不管你用的是哪个 harness,都可以直接用上它们」。 → 详细
- 第三条是方法而不是结论:「随着模型不断演进,请留意我们是怎么演进 responses API 的、怎么演进 Codex 的,把它当作一条线索,去想清楚你自己的 agent 该怎么更新,才能用上这些新能力。」——呼应开场那句"这些都是当下的状态"。 → 详细
闪电问答 / 收尾
本期无闪电问答、也无现场 Q&A 环节。 全场是单人 20 分钟连讲,讲者自称「基本上得用 2 倍速讲,因为内容太多」,结尾直接以三条 takeaway 收束,把提问引导到会后展台。 → 详细
联系方式
本期未留任何社交账号或邮箱。 讲者只在结尾说:「这是幻灯片的链接,我等下会去展台,有问题可以来找我。」另外他提到两份可追的书面材料——David 写的那篇 Windows sandbox 文章、以及 auto review 的博客文章;前一天他还有一场关于 app server 的演讲,「之后会有演讲视频放到网上」。 → 详细