自动驾驶式生产环境的五个等级——Eric Schwartz(Traversal)
- 一Traversal 的产品经理 Eric Schwartz(厂商视角)的判断是:编码 agent 把「开发」压短之后,省下的时间没有流向设计,而是被排障吃掉——代码更多、人对它的理解更少;他的幻灯片引的数字是 Global 2000 企业每年因宕机损失 4000 亿美元、每位工程师每周 7 小时耗在排障上。 → 详细
- 二他的立论是根因分析属于因果问题而不是可观测性问题,并用一张仿自动驾驶的 L0–L5 等级表(标题说五级,表里从 L0 数起是六行)把「自动驾驶式生产环境」定义出来:分水岭在 L3 到 L4,也就是从只懂一个服务的 agent 跨到横贯整个环境的因果推理,L5 是系统自己查、自己修、自己防。 → 详细
- 三两个案例的数字以幻灯片为准——PepsiCo 从每人积压 700 多条告警,到每月省下 500 多个工程小时、事故减少 36%;American Express 一起事故从 63 分钟、5 个团队、58 位工程师,降到 25 分钟、2 个团队、5 位工程师——最后他给买方列了五个该问的问题,而这五问正好逐层对着 Traversal 自家的架构。 → 详细
谁在讲、站在哪:一位产品经理讲自家的 AI SRE
- Eric Schwartz 是 Traversal 的产品经理(标题页幻灯片上写着 Founding Product Manager),不是工程师出身:自述没受过正规计算机科学训练,靠编码 agent 现在也能往生产环境提交代码,此前在 ServiceNow 做过几年可观测性产品。 → 详细
- Traversal 卖的是 AI SRE——用 AI 做站点可靠性工程(SRE,负责线上系统不出事、出了事排查修复的工种)。这是一场讲自家产品的厂商演讲,下文的客户数字都出自 Eric 的口述或幻灯片,没有第三方核实。现场标题页的题目大意是 AI 写了你的代码、也该由 AI 来修,与 YouTube 标题不同,日期是 2026 年 6 月 30 日。 → 详细
编码 agent 压短了「开发」,被撑大的却是「排障」
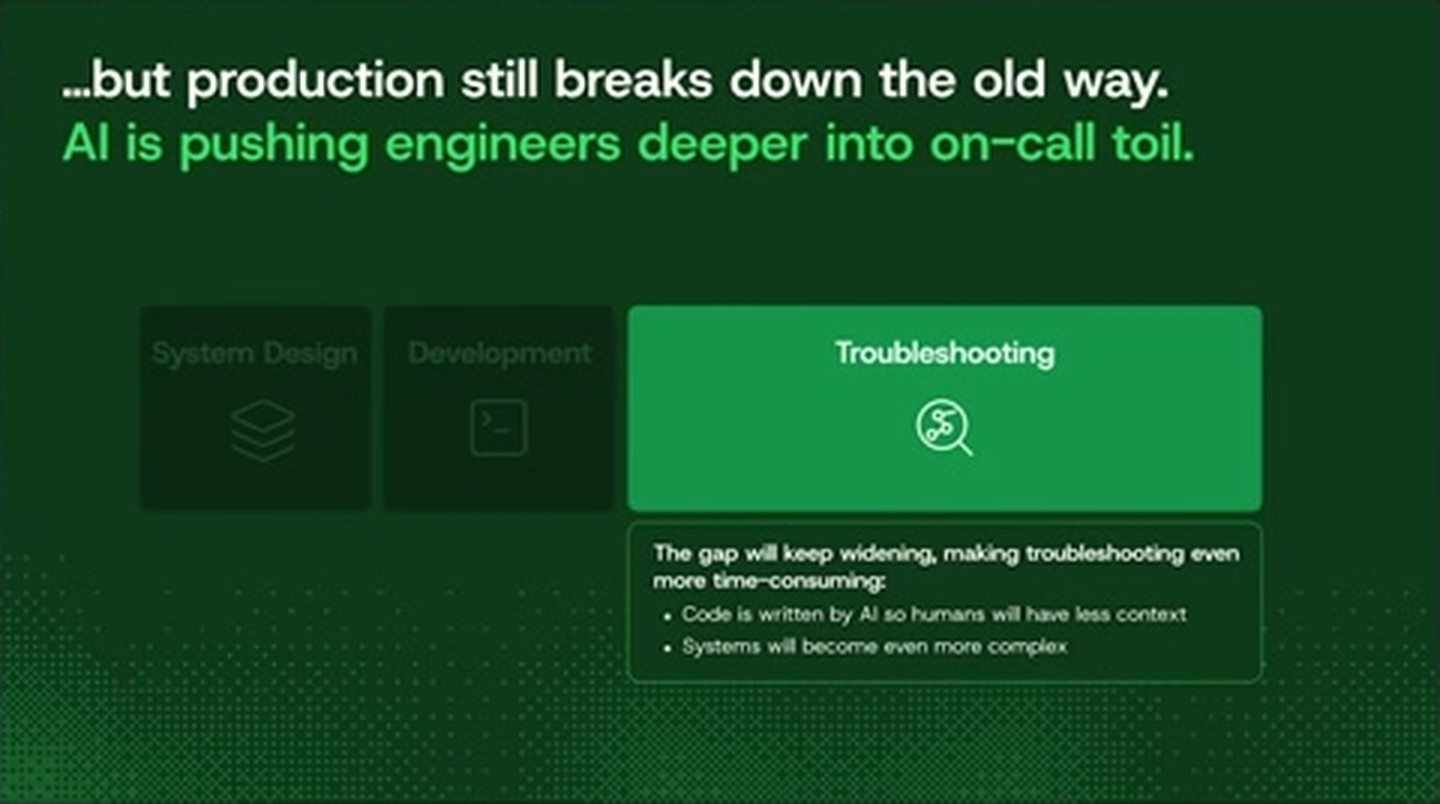 ▲ 图注:三段工作流里,系统设计和开发两格被压窄变暗,排障一格被拉宽点亮;下方说明框写着差距还会拉大的两条理由——代码由 AI 写、人掌握的上下文更少,系统会更复杂。
- 他把软件工程粗分三块:系统设计(想清楚做什么、搭什么架构)、开发(写代码)、排障(troubleshooting,东西上线后坏了去修)。编码 agent 让开发这块缩小,Eric 称团队能做的事是原来的 10 倍。 → 详细
- 大家原本期望省下的时间流向设计。Eric 称他们在合作企业里看到的正相反:代码多了很多、人对推上生产的代码理解得更少,问题更多、环境更复杂,团队陷在排障里。幻灯片把「差距还会拉大」的理由写成两条:代码是 AI 写的,人手里的上下文更少;系统还会更复杂。相关几期见 ep135(验证债)、ep164(Charity Majors)、ep195(Uber 的 agent 化开发流程);同批 264、267 讲的是这些代码上生产之前的事。Eric 的原话是「写出来的代码多了很多,大家对推到生产环境里的代码却理解得更少了。」 → 详细
排障的账:4000 亿美元、四成高管、每人每周 7 小时
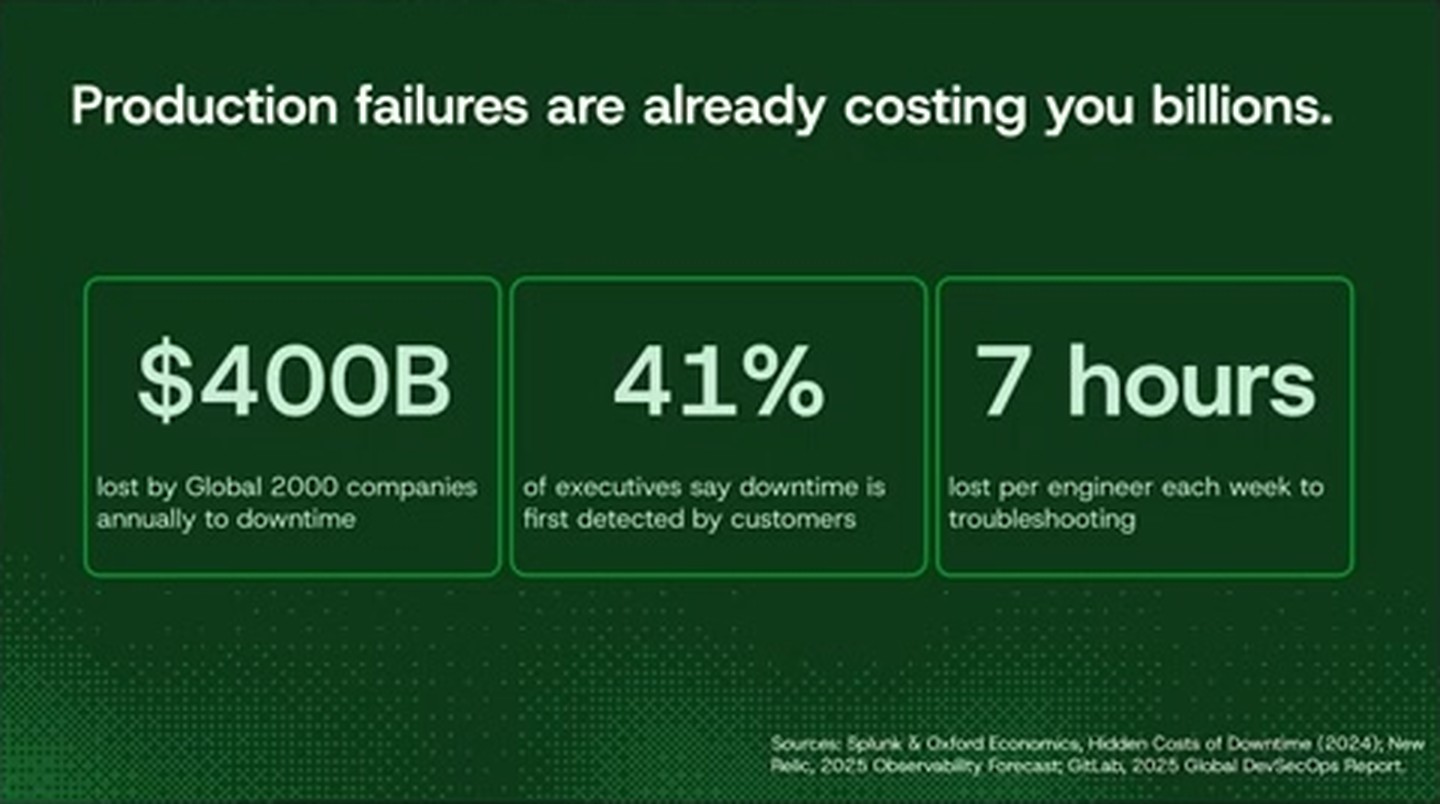 ▲ 图注:成本页的三张数字卡:4000 亿美元(Global 2000 企业每年因宕机的损失)、41%(高管称宕机是客户先发现的)、7 小时(每位工程师每周花在排障上);右下角是来源脚注。口头说的 40% 在这页上是 41%。
- 口头版本:按某些统计企业每年花掉 4000 亿美元以上(原话没说花在什么上);40% 的高管说这是他们团队面临的问题;工程师 on call(轮值待命)时平均每周有 7 个多小时耗在排障上。 → 详细
- 幻灯片上的口径更具体,对不上的地方照实并列:4000 亿美元是 Global 2000 企业每年因宕机损失的;百分比是 41%,内容是高管表示宕机由客户先发现,与口头那句 40% 说的不是一回事;7 小时是每位工程师每周的排障时间。脚注列了 Splunk 与 Oxford Economics(2024)、New Relic(2025)、GitLab(2025)三份报告。 → 详细
- 他判断只会更严重:Claude Code、Codex、Cursor 带来更多代码和更高复杂度。幻灯片画了一条进入 AI 时代后急升的复杂度曲线(更多代码、遥测、告警、事故),底下一条平线是人的排障能力。 → 详细
可观测性工具只说「什么坏了」,连 LLM 也难定根因
- Datadog、Elastic、Splunk、ServiceNow 这类可观测性工具(把日志、指标、调用链汇到一处看系统状态)会指出什么坏了、哪些东西可能相关,但不给根因。Eric 在 ServiceNow 时反复听客户抱怨:你告诉了我什么坏了,没告诉我为什么,也没告诉我该怎么办——dashboard 建得再多也跟不上。幻灯片的概括是它展示相关性、解释不了因果。同批 266 也从 dashboard 不给答案出发。Eric 的原话是「你告诉了我什么坏了,却没告诉我为什么坏,也没告诉我该拿它怎么办。」 → 详细
- 他引了两处外部说法:写出 SRE 手册的 Google 直接谈过这点,Anthropic 最近也有人说 LLM 不擅长指出根因。幻灯片上是两张引语卡,一张出自 Google SRE Book(分布式系统里往往很难判定故障原因),一张署名 Anthropic 的 SRE 负责人 Alex Palcuie(姓的拼写按读图,存疑),大意是事故响应还不能交给 LLM,它分不清因果与相关,而这对人同样难。 → 详细
为什么难:结账接口报错,根因是五跳之外一张过期证书
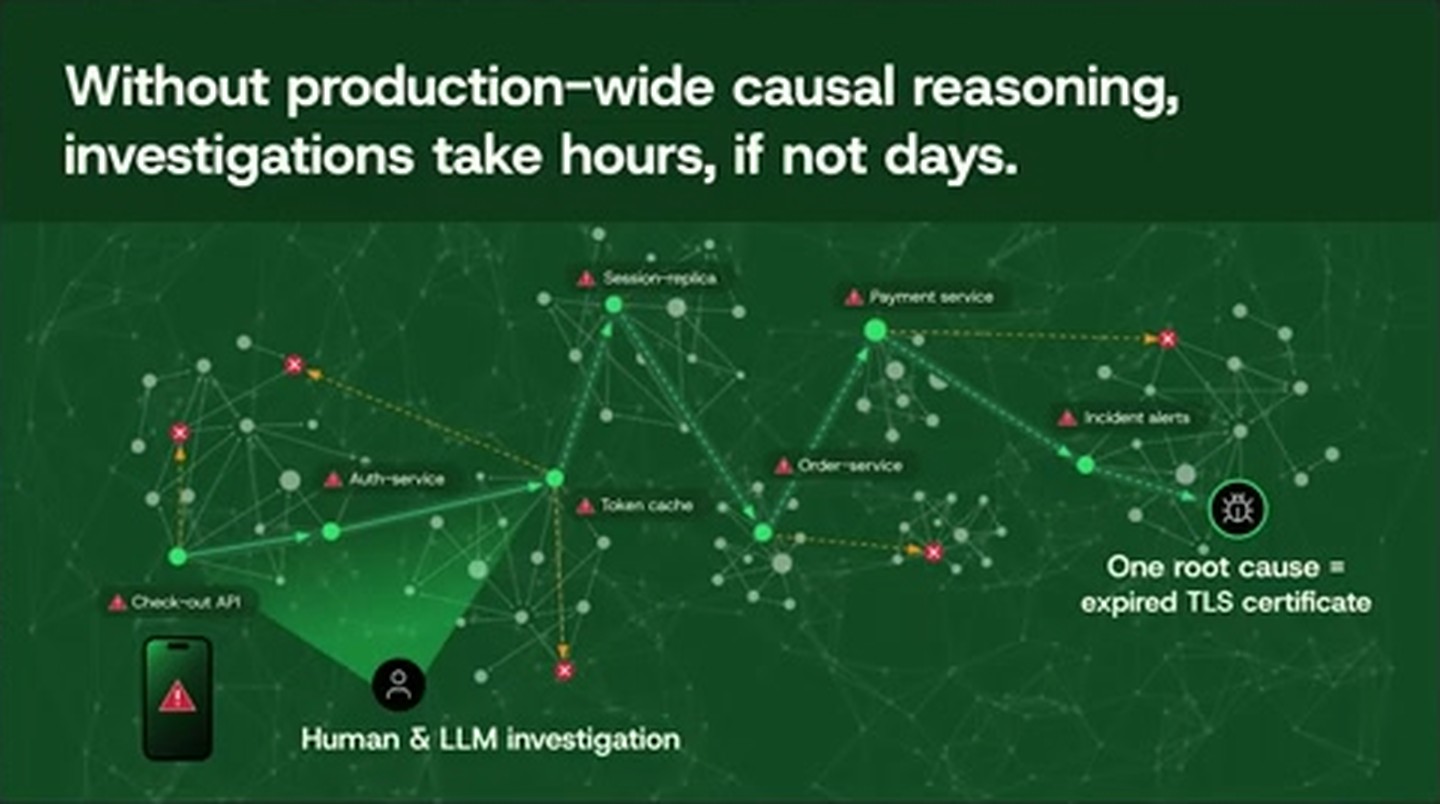 ▲ 图注:服务依赖图。左下是结账接口的告警,绿色箭头一路经过鉴权、缓存、会话、订单、支付等服务,终点的虫子图标标着根因是过期的 TLS 证书;橙色虚线是走进死路的排查,左下那束光只照到起点附近。
- 例子取材于一家客户:checkout API(结账接口)出故障,可能要在几十个服务、PB 级数据之间跳 5 到 10 跳才摸到根因——五跳之外一张过期的 TLS 证书(服务之间加密通信的身份凭证,过期了连接就断)。幻灯片的依赖图画出了这条路:从结账接口出发,经鉴权服务、令牌缓存、会话副本、订单服务、支付服务到根因,另有四条走进死路的虚线;跳数是口头说的,图上没写。Eric 的原话是「如果一个 checkout API 出故障了,你可能得在几十个服务、PB 级的数据之间跳上 5 到 10 跳,才能真正找到根因。」 → 详细
- 难在没人握有全貌:小环境里也许有一位懂全栈的资深 SRE 能一个人查完;到了 Fortune 50、Fortune 100 的体量,结果是 war room(临时拉起的事故作战室)里坐进 50 个工程师、耗上很多小时,每人只有自己那一小片上下文。他的结论是一个人、或一个人配上 Claude Code,都很难跳完这几步。 → 详细
立论:根因分析是因果问题,目标是一个不用叫醒人的闭环
- Traversal 的出发点,用 Eric 的原话说,根因分析「不是一个可观测性问题,而是一个因果问题」。四位创始人三位来自学术界、一位来自量化金融,他说他们把几十年投在因果机器学习(研究怎么从数据里分出因和果)上。幻灯片上写着团队有 131 篇论文、3,324 次引用,配一张三圈交叠的图(因果机器学习、LLM agent、强化学习)和 Columbia、MIT、Harvard、Berkeley、Citadel 的标志;创始人姓名字太小,这里不抄。 → 详细
- 他给「自动驾驶式生产环境」下的定义是一个闭环:出了问题,AI 系统自己发现这条告警或这起事故,找出根因,提交修复,验证确实修好,全程最好不用呼叫(page,把值班的人叫起来)任何人,团队继续做开发。 → 详细
等级表:从「谁醒着谁上」到「系统自己查、自己修、自己防」
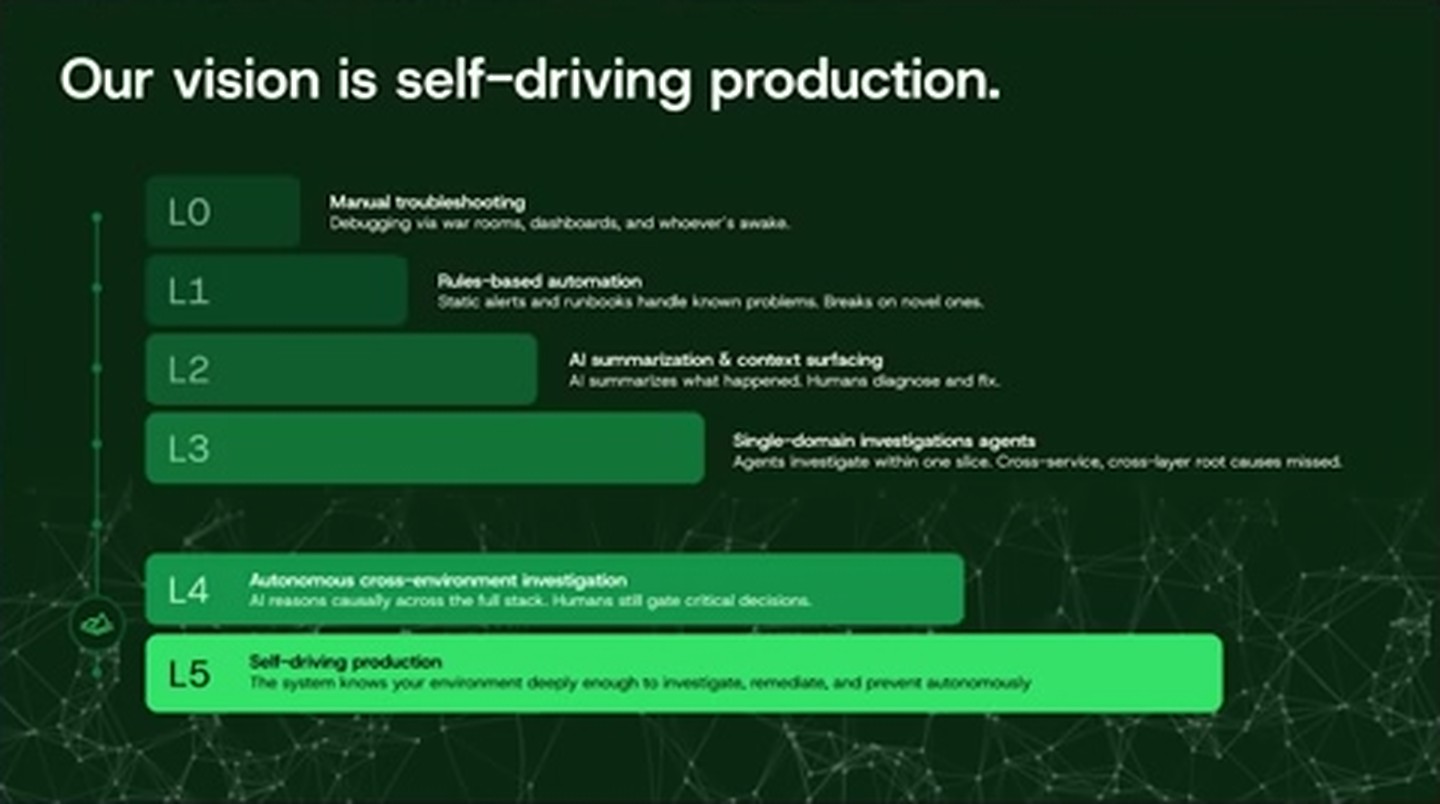 ▲ 图注:全片的核心页。六行阶梯条从 L0 到 L5 越来越长,每级一个名称加一行说明;L3 与 L4 之间留了一道空隙,L4、L5 两行高亮。
- 框架借自自动驾驶汽车的分级,Eric 强调这是一条光谱、多数公司还没走到头。先交代一处出入:YouTube 标题说五个等级,幻灯片上的表从 L0 数起一共六行(L0 是纯手工的基线,往上五级自动化),页面标题讲的是自动驾驶式生产环境这个愿景,没有出现五级的字样;口头说的 Level 0 到 Level 5 与表里的 L0–L5 是一回事。 → 详细
- L0 Manual troubleshooting(手工排障):幻灯片的说明是靠 war room、dashboard 和当时醒着的人。Eric 说今天大多数公司在这一级——把一堆人拉进 Slack 或 Zoom,花几个小时排查,人包办一切。 → 详细
- L1 Rules-based automation(基于规则的自动化):静态告警加 runbook(事先写好的处置手册)应付已知问题。他把眼下团队用 Claude Code、Cursor、Codex 搭的各种 loop 也归到这里——针对某条告警搭一条结构很死的工作流。软肋是碰上新情况就失效,而 Sev 1(最高严重级别的事故)通常恰恰是没见过的、没有现成手册,这时还是全靠人。 → 详细
- L2 AI summarization & context surfacing(AI 摘要与上下文呈现):幻灯片写的是 AI 总结发生了什么,诊断和修复仍然是人。口头上他把 L2、L3 并成一句带过,只说从这里开始内建更多一点自动化。 → 详细
- L3 Single-domain investigations agents(单一领域的排查 agent,名称照幻灯片原样):agent 只在一个切片里排查,跨服务、跨层的根因会漏掉。Eric 举的样子是公司自研了一个 agent,特别擅长某一个服务或某一组告警。 → 详细
- L4 Autonomous cross-environment investigation(跨整个环境的自主排查):AI 在全栈上做因果推理,关键决策仍由人把关。他说真正的飞跃在 L3 到 L4——要横跨几百个服务、几百个仓库、几千个日志索引,自研一套能扛住的方案相当难。Eric 的原话是「我们看到真正的飞跃是从 Level 3 到 Level 4,也就是横跨整个环境。」 → 详细
- L5 Self-driving production(自动驾驶式生产环境):幻灯片写的是系统对环境了解得足够深,能自主排查、修复和预防。Eric 称之为圣杯:不光在大企业的整个生产环境里诊断,还提交修复并验证。 → 详细
- 表的画法本身带立场:L3 与 L4 之间留了一道空隙,L4、L5 两行高亮并挂着 Traversal 的标志——分级的人把自家产品放在了分水岭靠 L5 的那一侧。 → 详细
Eric 报的企业规模,与产品覆盖的五类场景
- 客户他口头点了 American Express(他本人投入很多时间)、Pepsi、DigitalOcean、Capital One;幻灯片的标志条上还多一家 Kraken,标题称 Traversal 已让这些企业做到 L4–L5。规模上口头说的是万亿级日志、万亿级 span(一次请求调用链里的一段)、几百亿指标和事件,高严重级别事故的根因命中在 80% 以上(原话没带准确率这个词)。幻灯片上写着 2 万亿日志、1 万亿 span、200 亿指标、2,000 万事件、7 万次变更、5,000 个应用,以及 5 分钟内以 80% 以上的准确率定位根因。 → 详细
- 他说作为产品经理习惯按使用场景想问题,一共五类:告警智能(alert intelligence,他自己主要负责,替值班团队给一天几百上千条告警分诊、排优先级,对付告警疲劳);事故根因分析(公司起家处,把原本要几小时、几十位工程师的定位压到几分钟);自愈(给出根因后再提交修复);生产支持(让团队直接向生产环境提问、取数据点,够不上事故却很耗人);上线前的代码韧性(确认改动让系统更可靠)。 → 详细
- 幻灯片把前四类归在上线后、最后一类归在上线前,并列了四个没标是哪家客户的数字:MTTR(平均修复时间)降低 85% 以上、修复准确率 82% 以上、首年节省 1,000 万美元以上、每月省下 550 多个工程小时。 → 详细
案例一:PepsiCo 供应链团队,每人积压 700 条告警
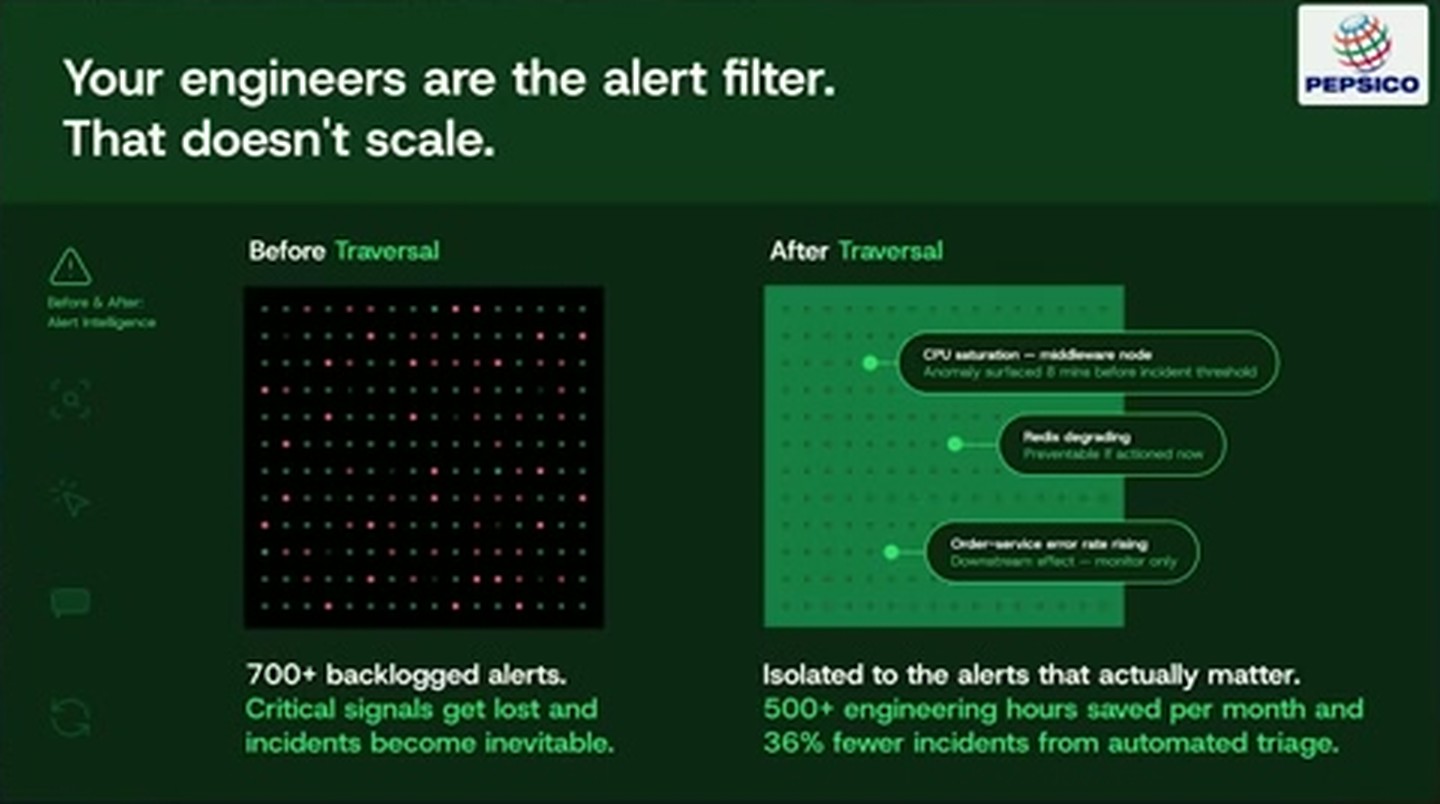 ▲ 图注:右上角是 PepsiCo 标志。左边「之前」是一片红绿告警点阵,写着 700 多条积压告警;右边「之后」只剩三条被挑出来的告警,写着每月省下 500 多个工程小时、自动分诊让事故减少 36%。
- 客户在幻灯片上的标志是 PepsiCo(Eric 口头说 Pepsi)。他说对方在很多应用上用 Traversal,最核心的一块是供应链——内部软件要保证原材料和成品顺畅流转,尤其是成品从仓库上卡车、再到零售商这一环(供应链是口述,幻灯片上没有这个词)。此前团队每周收到几千到几万条告警,单个工程师手里随时可能压着 700 条:噪音大到不知道往哪看,要么漏掉问题,要么硬跟到倦怠。Eric 的原话是「任何一个时间点上,单单一位工程师手里就可能积压着 700 条告警。这种状态基本是能把人压垮的。」 → 详细
- 用上之后,每位工程师拿到的是一组筛过、排好优先级、已经预先调查过的告警。系统同时标出三种降噪机会:改代码里的底层告警规则、关掉眼下不必处理的告警、给属于技术债的告警建工单留到以后。 → 详细
- 结果数字只在幻灯片上,口头没报:积压 700 多条告警,变成每月省下 500 多个工程小时、自动分诊让事故减少 36%(与上一节总览页那个没标客户的 550 多小时不是同一个数)。示意图里最后只剩三条被挑出来的告警:一个中间件节点的 CPU 饱和、Redis 性能下降、订单服务错误率上升。 → 详细
案例二:American Express,开桥三分钟内贴出根因
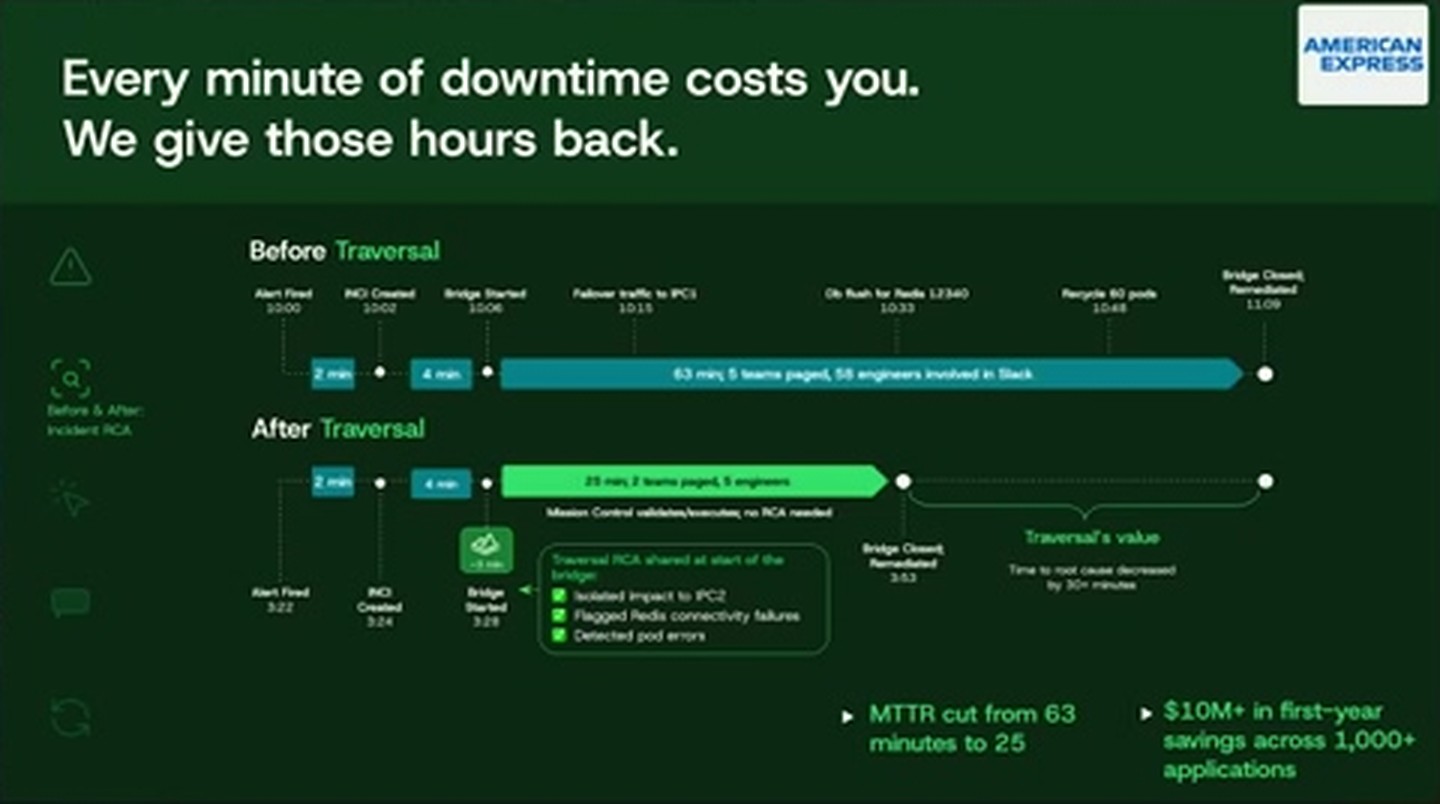 ▲ 图注:右上角是 American Express 标志。上面一条时间线是之前:63 分钟、呼叫 5 个团队、58 位工程师卷进 Slack;下面一条是之后:25 分钟、2 个团队、5 位工程师,开桥处挂着 Traversal 贴出的三条发现。右下两条结论是 MTTR 从 63 分钟降到 25 分钟、首年在 1,000 多个应用上节省 1,000 万美元以上。
- Eric 先口头描述了合作前的常态:一起事故会呼叫 5 到 10 个团队、20 到 50 位工程师,他说这个例子里花了 60 分钟,也可能拖上几小时甚至几天;持卡人还不了账单、登不上手机 App 都是大事。团队数和人数是口头的泛指;口头的 60 分钟,幻灯片上这起事故写的是 63 分钟。 → 详细
- 现在的做法:American Express 每创建一起事故,Traversal 都是第一响应者。bridge(他们内部对事故会议的叫法)一宣布,3 分钟内就在处理这起事故的 Slack 频道里贴出一份详细的根因分析,需要的话同步到 ServiceNow 工单。有了这份初判,要么一个团队都不用叫,要么只叫一两个团队来核实结论。Eric 的原话是「这样就不用去呼叫 5 个团队、58 位工程师了——因为有了这份初步分析,场面没那么混乱,你对到底是什么坏了心里有数。」 → 详细
- 具体这起事故的数字以幻灯片为准。两条时间线的前两段一样(告警后 2 分钟建事故单、再过 4 分钟开桥),差别全在开桥之后:之前到修复关桥用了 63 分钟,呼叫 5 个团队,58 位工程师卷进 Slack;之后 25 分钟,2 个团队,5 位工程师,开桥时已贴出三条发现(圈定影响范围、Redis 连接失败、pod 报错)。结论页写着 MTTR 从 63 分钟降到 25 分钟、定位根因的时间缩短 30 多分钟、首年在 1,000 多个应用上节省 1,000 万美元以上。 → 详细
- Eric 口头的收尾是省下 50 多位工程师被叫进事故的时间,半夜出事时尤其可贵;他说的 53 位工程师能睡个好觉是口头的算法(58 减 5),幻灯片上没有这个数。Eric 的原话是「要是事故发生在大半夜,这一点就格外让人感激了——等于现在有 53 位工程师能睡上一个好觉。」 → 详细
挑 AI SRE 该问的五个问题
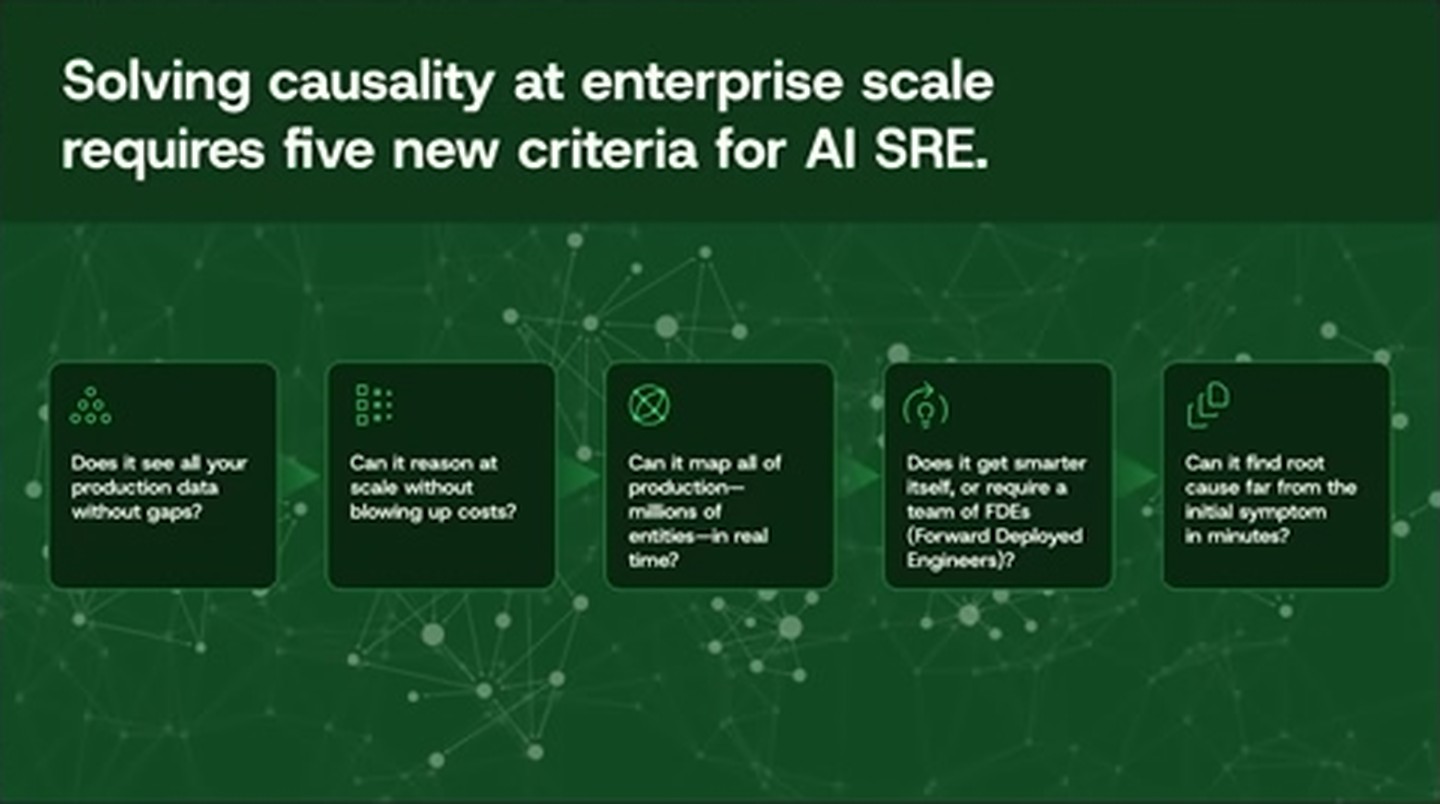 ▲ 图注:五张用箭头连起来的问题卡,从左到右依次问:数据看得全不全、规模上来成本会不会爆、能不能实时映射上百万个实体、是自己变聪明还是要靠一队 FDE、能不能在几分钟内找到离症状很远的根因。标题里用的词是 criteria。
- 背景是 AI SRE 这条赛道很热,Eric 说很多公司在做、或号称在解决这些问题,所以他给买方列了五个该问的问题。幻灯片上这一页的用词是 criteria(评估标准),标题的意思是在企业规模上解决因果问题需要五条新标准。 → 详细
- 第一问:它能不能不留缺口地看到你全部的生产数据?只喂给它一小片,或者它的理解有窟窿,就很难得出细致的根因。 → 详细
- 第二问:它能不能在这个规模上推理而不让成本爆掉?他说面对的往往是 PB 级数据、几千亿条日志,既不能把账单烧穿,也不能把你现有的可观测性基础设施查垮,这对 Fortune 100 体量的企业并不容易。 → 详细
- 第三问:它能不能把整个生产环境里的实体及其关系梳理出来?幻灯片的写法更具体——上百万个实体、实时。他的理由是数据就算全接进来、全读一遍,不知道拿它怎么办也等于没用。 → 详细
- 第四问:它是自己越用越聪明,还是得靠一队 FDE(前线部署工程师,厂商派到客户现场做定制的人)养着?Eric 的说法是不该要你专门拨工程资源去维护一堆 markdown 文件,也不该让一帮 FDE 占着你团队的时间来维护系统知识。 → 详细
- 第五问:它能不能在几分钟内连跳多步,找到离最初症状很远、并不显而易见的根因?他给了一条时间线,原话是「只要超过 5 分钟,基本就没戏了」——值班团队的耐心耗光,大家会退回自己的老习惯,所以必须又准又快。 → 详细
- 读这份清单要知道一点:下一页技术栈图的左侧把这五问倒序竖排,逐层对着自家产品的组件——标准和架构是对着写的(中间几条具体对到哪一层,读图存疑)。 → 详细
Traversal 的技术栈:生产环境世界模型加因果搜索引擎
- 口头只讲了三层:最底层是在不增加成本的前提下把接入的数据全部摄取、映射;中间层负责理解这些数据、梳理它们之间的全部关系,他们叫 production world model(生产环境世界模型);最上层把结果包装成对团队有用的场景和体验。 → 详细
- 他点名的两块核心是世界模型和 causal search engine(因果搜索引擎)——后者是交给 agent 的那套 harness(套在模型外面、给它工具和流程的外壳)与机制,让 agent 在梳理好的数据里搜索。Eric 称靠这两块能帮 Fortune 500 企业走到 L5。 → 详细
- 幻灯片上的栈比口头多出几层:最底下是数据源(MELT 遥测,即指标、事件、日志、调用链;源代码;部署记录;runbook;历史事故;Jira),往上依次是 Agentless Data Capture、AI-Native Compressor,中央球体里自下而上是 Production World Model、Knowledge Bank、Causal Search Engine,顶上一条是前面那五类场景;多出来的几个组件名口头没有展开。收尾页把 L0–L5 六根条又放了一遍,只有 L5 亮着。 → 详细
闪电问答 / 收尾
本期无闪电问答,也没有现场提问环节的录音;演讲以一句致谢结束,Eric 中途说过其余几类场景欢迎会后找他问。
联系方式
演讲里未给出联系方式。