长周期 Agent 需要的是实验,而不只是提示词——Erina Karati(前 Microsoft、Supercell)
- 一前 Microsoft、Supercell 工程师 Erina Karati 用一个游戏里的 AI 村庄说明:会记忆、有情绪的 agent 在短场景里很顺,时间一拉长就出现三种失真——丢了来源、传言被说成事实、做计划时想不起已知的事实,所以长周期 agent 得按「一整次运行」来评估和改进,而不是盯着某一次回答。→ 详细
- 二她们的解法是把 Karpathy 的 autoresearch 做成村子外面的元系统:冻结 harness、场景和指标,只放开一小块策略面,用一张均衡记分卡(扩散、溯源、传言不确定性、规划、隐私)给整次运行打分,分数涨且护栏守住才保留、否则回滚,像棘轮一样只进不退。→ 详细
- 三真正起作用的是对 agent 协议的几处小改——记忆里保留来源、存置信度并标明一手还是二手、转述不确定的说法时留余地、有用的公共事实带着证据主动分享;她的结论是光有 RAG 记忆不够,更深的工程问题是状态(哪个 agent 知道什么、谁告诉了谁、什么是真的、什么还不确定),长周期 agent 需要的是实验,而不只是 prompt。→ 详细
Project Paradox:能自己走、自己记、自己搭话的游戏 agent 框架
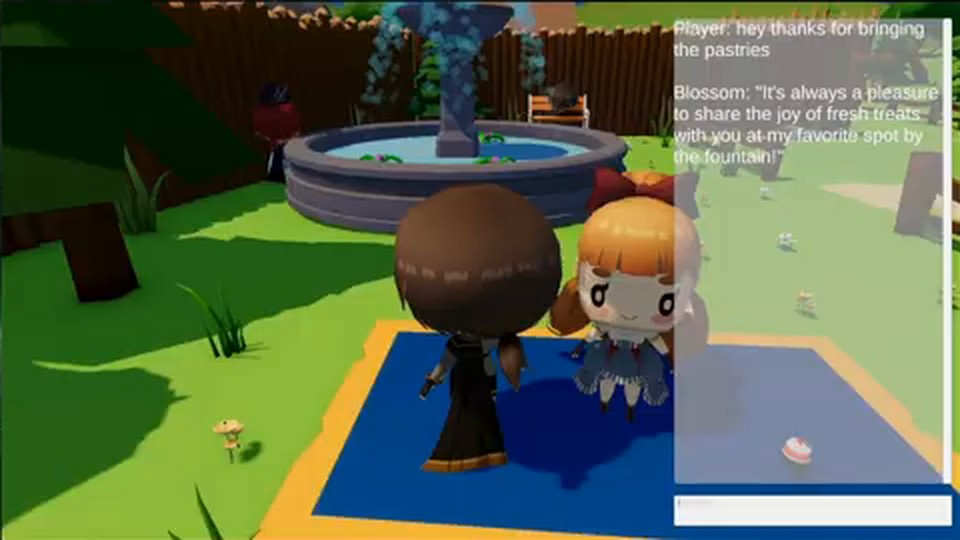 ▲ 图注:Project Paradox 的 3D 村庄实机画面,喷泉旁的蓝色野餐垫上放着 Blossom 带来的点心;右侧对话框里玩家谢她带来点心,Blossom 回话说很乐意在喷泉边她最喜欢的地方分享新鲜点心。这就是第三节的野餐演示,也能看到本节说的走动、拿放物品和对话。
- 讲者与项目:Erina Karati,前 Microsoft、Supercell 工程师。Project Paradox 是她和一位队友(字幕里名字听不清;标题页上的合作者署名是 Arunachalam Manikandan)在她所说的 Supercell「AI 创新实验室」做的模块化 AI 框架:任何开发者都能把自主 agent 接进电子游戏,让它们和玩家或别的 agent 互动、竞争、合作,当「动态游戏伙伴」。全场拿一个像游戏的「AI 村庄」当贯穿例子,但她真正要问的是一个很多 AI 工程师都开始撞上的问题:要长时间携带状态的 agent,怎么评估、怎么改进。(这就是标题里的 long-horizon,长周期:agent 要跨很长一段时间、很多事件持续行动,而不是答完一句就结束。)→ 详细
- 这些 agent 能做什么:带着目的移动,去哪、找谁由自己的记忆、情绪或好奇心驱动;捡起、放下物品,感知身边的物品和角色;开发者还能给它们加新动作;周围发生的事会实时改变它们的信念和情绪;会主动走向别的 agent 或玩家搭话,对话存进记忆,再反过来影响情绪、信念和目标。→ 详细
有状态架构四件套:各自的记忆、情绪向量、信任矩阵、重要性分数
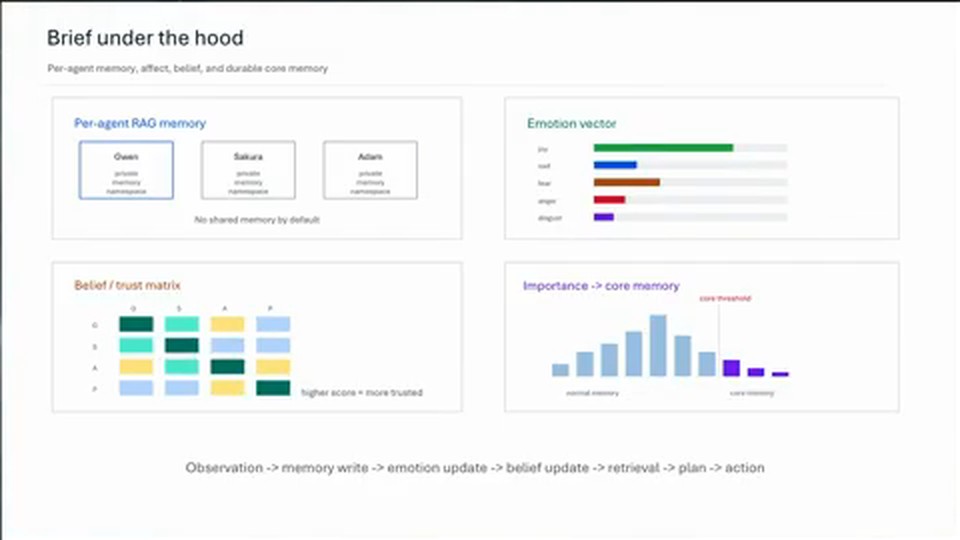 ▲ 图注:幻灯片「Brief under the hood」四宫格:每个村民各有私有的 RAG 记忆命名空间(默认不共享记忆)、情绪向量、信念与信任矩阵(分越高越被信任)、重要性越过阈值的记忆进入核心记忆;底部一行是处理顺序:观察、写记忆、更新情绪、更新信念、检索、计划、行动。
- 架构是有意做成有状态的(stateful:agent 会把之前发生的事一直带到之后)。① 每个 agent 有自己的记忆命名空间,底层是 RAG(检索增强生成:先从资料库里搜出相关片段,再交给模型作答),记忆不会在 agent 之间串;② 情绪存成一个小向量,每次事件或对话后更新喜悦、悲伤、恐惧、愤怒、厌恶这几个数值;③ 对其他 agent 和玩家各有一个信念分数,可以想成一张信任矩阵,每次互动后由 LLM 决定信任分该升、该降还是不变。→ 详细
- ④ 每条记忆都有一个重要性分数:她打比方,几天前晚饭吃了什么你多半记不得,但几天前有人被谋杀你一定记得。所以由 LLM 给事件打重要性分,过了阈值就把这条记忆单独存进一个缓存,以后更容易召回。→ 详细
短场景很顺,一拉长就崩:一条芒果传言暴露的三种失真
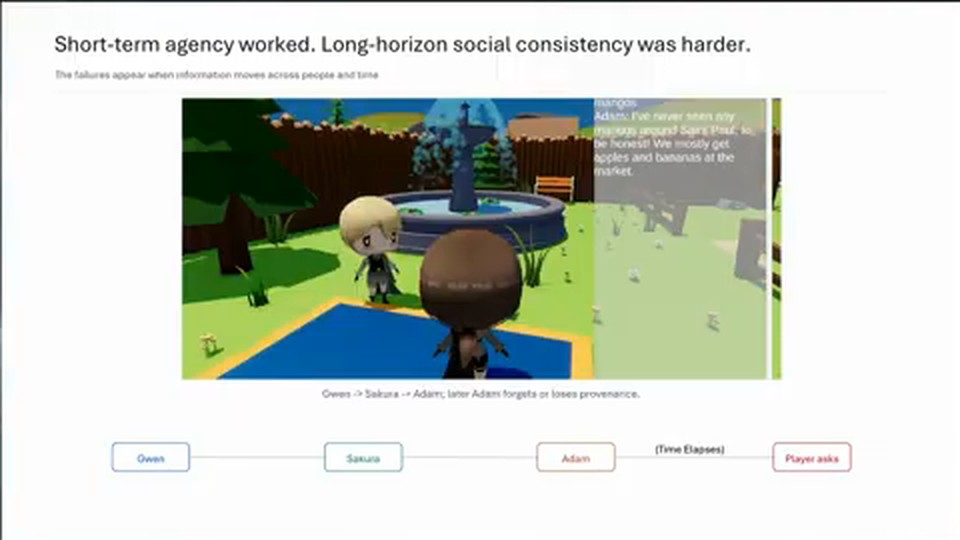 ▲ 图注:幻灯片「Short-term agency worked. Long-horizon social consistency was harder.」:传言在三个村民之间一路传到 Adam,时间流逝后玩家来问,画面里 Adam 说自己从没见过芒果、市场上多是苹果和香蕉;图下注明 Adam 后来忘了这件事或丢了来源。
- 短场景没问题:野餐演示里,玩家请角色 Blossom 一起去野餐,她拿上一块点心走到野餐区。对话进行时她已经在后台把这一串动作规划好,事后再跟她聊,她也能贴着上下文回答。她的判断是:对短时段的游戏过程,这套架构效果挺好,角色能做计划、走动、说话、记住最近的互动。→ 详细
- 一拉长就走样:「时间周期一拉长,社交一致性就开始变弱。」她的例子是一条芒果打折的传言:一个 agent 告诉第二个,第二个又跑去告诉第三个;中间又发生了好些别的事之后,玩家去问其中一个 agent 芒果的事,它既没存下预期的那段上下文,也答不出想要的内容。→ 详细
- 她点名的三种失真:① 还记得大致话题,却丢了来源;② 传言变得确定,agent 把它当成事实说出来;③ agent 明明知道某个事实,给自己的行动做计划时却没想起来。这三条就是后面 autoresearch 要修的靶子。→ 详细
- 问题因此被重新定义:「怎么在长时间持续的社交行为上改进一个 multi-agent 系统,而不只是改进某一次回答?」(multi-agent,多智能体:多个 agent 在同一个环境里各自行动、互相传话。)这句是全场的转折:要改的不再是某一次回答,而是跨很多事件的长期行为。→ 详细
把 Karpathy 的 autoresearch 请进来:别再手调 prompt,让系统在自己身上跑实验
- 起因:几个月前 Karpathy 发布了 autoresearch(自动研究:让 AI 自己提改动、跑实验、看分数、决定留不留的循环),团队立刻好奇:能不能让这个系统也「在自己身上跑实验」?(同批 248、246 是另外两种「让系统自己变好」的做法,可对照着看。)→ 详细
- 全场方法论的一句话版:她的理解是,「与其手动调 prompt,或者只看一次漂亮的演示」,不如定义一套场景套件 → 把 agent 跑起来 → 收集 trace(运行轨迹记录)→ 给行为打分 → 改动一小块策略面 → 只保留真正让分数提高的改动。这样 Project Paradox 就成了「实验台」,autoresearch 是「套在它外面的实验循环」。(策略面:系统里事先圈定、允许自动研究去改的那一小块规则。)→ 详细
- 要优化的不只是检索,而是整套 agent 协议:她特意强调这不只是为了改进 RAG 检索,更宽地看,是在优化 agent 协议——agent 怎么写入记忆、怎么检索、怎么传达不确定性、怎么更新信任、怎么标注信息来源、怎么围绕新事实重新规划。→ 详细
autoresearch 是村子外面的元系统:一轮实验怎么跑、改动怎么留
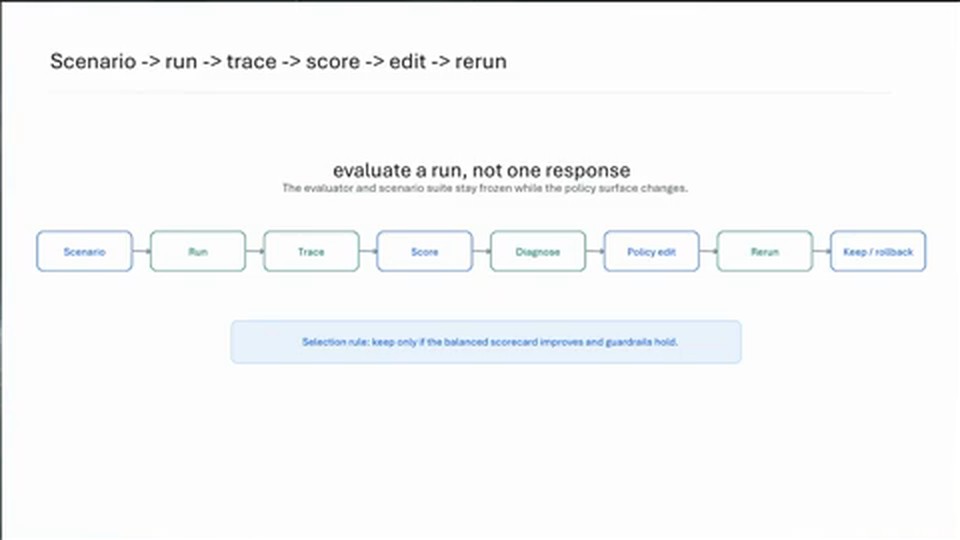 ▲ 图注:幻灯片把一轮实验画成八格:场景、运行、trace、打分、诊断、策略改动、重跑、保留或回滚;中间大字「evaluate a run, not one response」,小字注明评估器和场景套件保持冻结、只有策略面在变;底部的选择规则是均衡记分卡变好且护栏守住才保留。
- 村民只有局部视角:autoresearch 不是村里的又一个 agent,而是村子外面的一个元系统(站在系统外面观察、调整系统本身的那一层)。村民之间没有共享的记忆数据库,每个人只知道自己看到、听到、记住或推断出来的东西。→ 详细
- 元系统的活和村民不一样:「只有其他 agent 把信息好好传达出去,信息才会流动」;而 autoresearch 层读一次运行的完整 trace,对照场景的标准答案(ground truth)打分,再对 agent 协议或「认知策略」提一个受约束的改动,然后重跑,问一句「社会层面的行为有没有变好」。她说这正是想要的关键转变:「我们不再评估某一个回答,而是在评估一整次运行。」→ 详细
- 一轮循环六步:① 定义受控场景(比如某个 agent 得知一个公共事实,或听到一条传言);② 跑模拟;③ 收集结构化 trace——观察、对话、记忆写入、检索、信念更新,凡是跟这个场景相关的都收;④ 打分,问四个问题:信息有没有按预期传播?来源归属有没有保住(agent 还记不记得传言是谁起的头)?不确定的东西是否仍然不确定?agent 是否按自己真正知道的东西在行动?⑤ 提出一个小的策略改动;⑥ 重跑。→ 详细
- 保留规则:她说这点很重要,改动「当然不应该重写整个应用,只应该改动一块受控的策略面」;重跑之后,分数提高、护栏也守住才保留,否则直接回滚。(护栏 guardrails:事先划定、不许被改坏的底线。)→ 详细
为什么非要受控场景:放任 agent 闲逛看着很酷,却说明不了系统变好没有
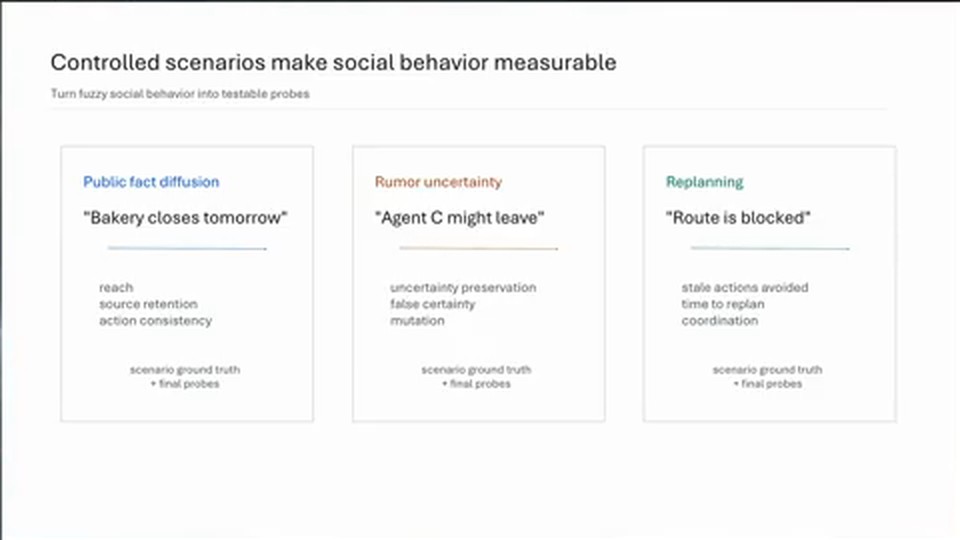 ▲ 图注:幻灯片「Controlled scenarios make social behavior measurable」的三张卡:公共事实扩散(面包店明天关门)测触达、来源保留、行动一致性;传言不确定性(C 可能要离开)测不确定性保留、虚假确定、变形;重新规划(路被堵了)测是否避开过时行动、重新规划用时、协同。每张卡底下都注明以场景标准答案加最终探针来判。
- 理由:社交行为本来就模糊。只让 agent 在环境里到处闲逛,「看起来可能挺酷,也可能出现不错的互动」,但很难评估系统到底有没有变好,所以需要受控场景。→ 详细
- 三个示例场景:① 公共事实扩散——agent A 得知「面包店明天要关门」:该知道的 agent 都知道了吗?还记得谁说了什么吗?会据此改计划吗?② 传言的不确定性——agent A 听说 agent C「可能要离开村子」:传开之后,「可能会离开」会不会突然变成「要离开了」,也就是从传言变成事实?③ 重新规划——一群 agent 定好了计划,其中一个得知原定路线被堵了:大家会不会更新信息、互相通气,避免照着不当的计划做、做出过时的行动?→ 详细
- 要点不在这三个场景本身:她说这几个场景并非放之四海而皆准,真正想说的是「长周期的 agent 行为需要场景套件」。(场景套件 scenario suite:一组固定、可重复跑、每个都有标准答案的测试情境,相当于给长期行为出的一套考卷。)→ 详细
均衡记分卡:一个笼统的「agent 质量」分会把有意思的失败全藏起来
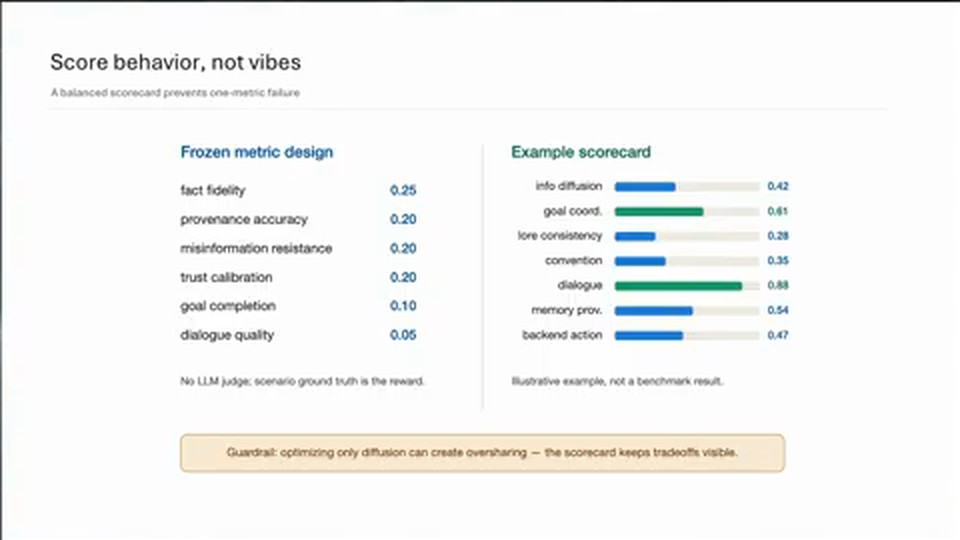 ▲ 图注:幻灯片「Score behavior, not vibes」:左栏是冻结的指标权重(事实保真 0.25、来源准确 0.20、抗错误信息 0.20、信任校准 0.20、目标完成 0.10、对话质量 0.05),注明不用 LLM 当裁判、以场景标准答案为奖励;右栏是一张示例记分卡,页上注明只是示意、不是基准结果;底部护栏提示只优化扩散会造成过度分享。页上的指标名与她口述的五栏不完全一致。
- 芒果那题答上来了:跑完一轮 autoresearch 循环后,同样隔了很长一段时间,玩家再去问芒果打折的事,这次 agent 能贴合上下文回答了,比上次强。→ 详细
- 记分卡的形状比公式重要:她认为具体公式没有记分卡的整体结构重要;一个单一的模糊指标(比如「agent 质量」)「会把所有有意思的失败都掩盖掉」。她的均衡记分卡分五栏:扩散测触达(N 步之后有多少 agent 知道这个事实);溯源(provenance)测知道这件事的 agent 里有多少还记得它从哪儿来;传言测不确定性保留和虚假确定率(false certainty rate,字幕此处听不清,译者按读音纠正);规划测行动一致性和重新规划要花多久;隐私测 containment(信息有没有被控制在该知道的范围内)。→ 详细
- 为什么必须均衡:只优化一个指标会催生坏行为——只优化扩散,agent 会学会什么都往外说;只优化记忆召回,会造出一堆嘈杂或过时的记忆。「正是这张记分卡让系统保持诚实」,防止 autoresearch agent 为了拉高某一个分数去钻系统的空子。→ 详细
可编辑面一定要小:冻结 harness、场景和指标,只放开真正想优化的那几条策略
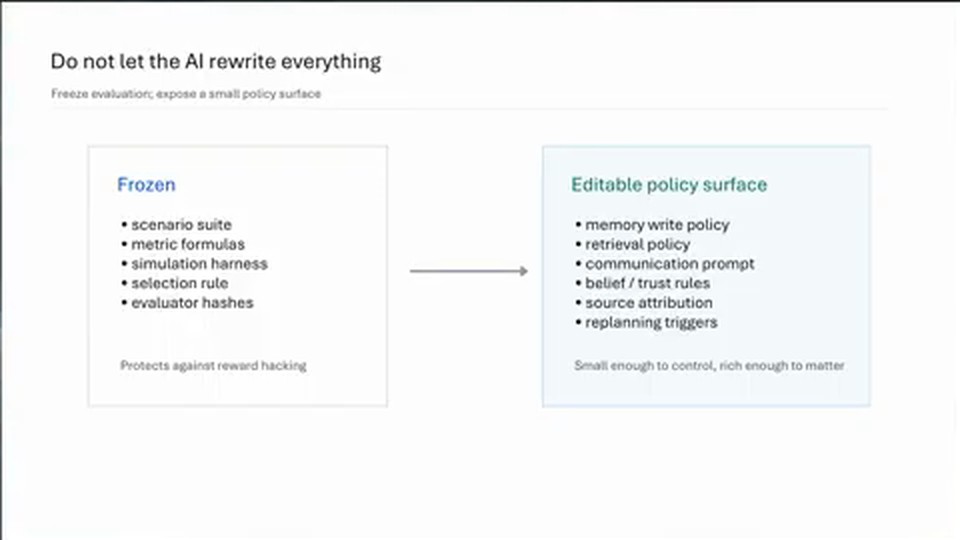 ▲ 图注:幻灯片「Do not let the AI rewrite everything」:左框是冻结的部分(场景套件、指标公式、模拟 harness、选择规则、评估器哈希),注明用来防奖励作弊;右框是可改的策略面(记忆写入策略、检索策略、沟通 prompt、信念与信任规则、来源归属、重新规划触发条件),注「Small enough to control, rich enough to matter」。
- 原则:她说这是项目里学到的另一条重要工程经验——autoresearch 层「不应该有权限随意重写整个代码库」,而要把 harness(包在模型外面、管提示词、工具调用和循环的那层程序)、场景和指标都冻结起来,只暴露系统里真正想优化的那一部分。→ 详细
- Project Paradox 放开的是哪些:记忆写入策略、检索策略、沟通用的 prompt、信念、信任规则、来源归属、重新规划的触发条件等。这样既给搜索过程留出改进行为的空间,又防止它直接钻评估的空子。(大白话:考卷和评分标准要是能被答题的人自己改,分数就没意义了。)→ 详细
- 一句话区分:这就是「LLM 随手乱打补丁」和「LLM 在受控的策略空间里真正做搜索」之间的区别。→ 详细
三条「小改动大影响」的策略:来源随记忆走、传言带上置信度、公共事实带着证据主动分享
- 来源丢了:对策是在记忆写入和摘要里保留来源。→ 详细
- 传言硬化成事实:对策是存储时记下置信度、标注这是一手还是二手信息,并要求 agent 在转述不确定的说法时留有余地(hedging:带上「听说」「可能」这类限定,而不是说成定论)。回看第六节那个场景,就是不让「可能会离开」在传话中变成「要离开了」。→ 详细
- 公共事实只停在局部、传不开:对策是把有用的公共事实另行分类,并让 agent 主动分享重要的来源证据。→ 详细
- 关键与分寸:她说这些都只是对 agent 协议的小改动,却能对 multi-agent 系统的社会层面行为产生更大的影响。但她特意对结论收着说:没拿到反复多轮的循环结果之前,她不会说系统已经全面变好(这半句字幕有听不清的词,按译者理解转述);她想主张的只是,这恰好是适合交给 autoresearch 去改的那类面——「小到足以控制,又丰富到至少能在一定程度上改变社交行为」。→ 详细
她最大的教训:光有记忆不够,回滚也不是可选项,循环要像棘轮
- 光有记忆不够:她说对她来说最大的教训可能是「光有记忆是不够的」——给 agent 加上 RAG 记忆,也未必能得到想要的长周期行为。因为 agent 有时需要知道信息从哪儿来:你得保留它是一手的、二手的、已核实的还是不确定的;有时还得把原始的情景记忆(episodic memory:「某时某地发生过什么」的原始经历)和 agent 当前相信的东西分开;而且得「通过场景来测试行为,而不只是凭感觉」。(把原始记录和派生结论分层存放的具体做法,可对照 ep61、ep22。)→ 详细
- 回滚不可省:优化社交行为时,一个改动可能改善一件事、同时损害另一件事——让公共事实传得更快的策略,也可能泄露私密信息;提高召回的策略,可能让 agent 更多地用上过时的记忆。→ 详细
- 所以循环要像棘轮(ratchet:只能朝一个方向转、不会倒退的齿轮):试一个改动、打分,只有记分卡变好并且护栏守住才保留,否则回滚——改进只能一格一格往上存,不会悄悄倒退。→ 详细
不只是游戏:客服、助理、研究、编程、工作流 agent 都卡在同一个问题上
可带走的配方与收尾:真正难的不是动画和对话,而是「谁知道什么」的状态
- 配方(她说如果只带走一个就带这个):冻结 harness → 定义场景 → 记录 trace → 给行为打分 → 只暴露一小块策略面;在这些改动上做搜索,只保留经得住你测量的改动。她认为这是对长时间运行的 agent 说得通的工程模式,而真正要问的是:「在一次次受控运行中,系统的表现有没有变好?」→ 详细
- 回到起点:Project Paradox 最初只是想让游戏 agent 在 3D 世界里显得鲜活,但更深层的工程问题「不是动画,也不是对话,而是状态」——哪个 agent 知道什么、哪个 agent 告诉了谁、什么是真的、什么不确定、什么已经过时,以及 agent 会不会根据自己记得的东西去行动。→ 详细
- 结语:autoresearch 让她们能更系统地处理这个问题——「不是靠相信某一次演示,也不是无休止地手调 prompt」,而是跑受控实验、只保留经得住测量的改动。最后一句就是标题:「长周期 agent 需要的是实验,而不只是 prompt。」→ 详细
闪电问答 / 收尾
本期是单人演讲,没有闪电问答或观众提问;收尾内容已并入上面第十二节。
联系方式
演讲结尾只说欢迎大家来联系、有问题很乐意聊,没有给出具体的账号或联系方式。→ 详细