重新思考多智能体协作:当多即是少——南京大学等
- 一这篇南京大学团队的论文用图论回答「多智能体协作什么时候才值得」:把一次任务执行看成步骤之间的依赖图,删掉就会让图断开的「桥边」就是两个子任务之间唯一的交接线——事先知道整条轨迹、又沿桥边切对,拆给多个 agent 一定省上下文;可现实里依赖图要等任务做完才看得见,编排的本质是提前猜桥边,猜错会让 agent 互相干等(局部死锁)或推高通信开销,子任务越多错得越多、协调成本越高,所以多智能体只在「长程 + 稀疏依赖」的任务上系统性占优,在紧耦合的顺序流程里,Claude Code、Codex 这类单智能体 harness 依然更强。→ 详细
- 二据此提出的 SAIGE 不预先画组织图:正在跑的 agent 只有碰到真正的交接线才派子 agent、没有就自己做完,子 agent 把结果落盘、别人要用时再去拉;在四个长程基准上(统一用 Codex CLI + DeepSeek-V4-Pro),紧耦合的 Terminal Bench 2.1 和 NL2Repo 上三种通用多 agent 方法全部输给单 agent,SAIGE 与单 agent 持平(75.50 对 76.71、49.23 对 48.74),稀疏的 Deep Research Bench II 和 AgentIF-OneDay 上 SAIGE 领先(55.23、71.80,单 agent 是 51.49、53.57),token 还比其他多 agent 方法省。→ 详细
- 三「更多 agent 不等于更聪明」有多路证据:消融里 agent 上限从 4 加到 6、递归从 1 层加到 3 层,分数大多下降、token 最多翻一倍多;SAIGE 在紧耦合任务上每题平均只用 1.10–1.22 个 agent、在稀疏任务上用 3.36–3.87 个,桥边找得最准(AgentIF-OneDay 上 F1 0.72,其他三家 0.54–0.60),尤其是少漏——而漏掉一条桥边,就足以让 make-doom-for-mips 这种长链任务卡进「构建—验证」互等的死锁;作者的建议是,协作应按任务的依赖结构有选择地引入,而不是默认选项。→ 详细
核心结论:多智能体只在「长程 + 稀疏依赖」的任务上占优,紧耦合的顺序流程里单智能体更强
- 一句话结论:作者(南京大学 / 上海交通大学,通讯作者 Jiaheng Liu)用图论给多智能体协作(multi-agent collaboration,多个 AI agent 分工合作完成一件任务)划了能力边界:它的系统性收益只出现在「长程 + 稀疏依赖」的任务里——长程(long-horizon)指要走很多步才能做完,稀疏依赖指后面的步骤只依赖前面少数几步、而不是步步牵连;而在紧耦合(tightly coupled,每一步都离不开前面一大串上下文)的顺序式工作流里,一个配备完善的单智能体 harness(外壳 / 运行框架:把模型包起来跑循环、调工具的那层软件,如 Claude Code、Codex)依然更强。→ 详细
- 收益在递减,开销在上涨:单个 agent 的能力还在往上走,多智能体协作的收益因此越来越小,要付的上下文开销却越来越大。全文的落点有两句值得原样记住:"multi-agent superiority is bounded by task structure rather than universal"(多智能体的优势受任务结构限制,并非普遍成立),以及 "more agents do not necessarily make a system more intelligent"(更多的 agent 不一定让系统更聪明)。→ 详细
- 三件贡献:① 理论——把任务轨迹建模成依赖图、用「桥边」切出子任务,说清协作何时值、何时不值;② 方法——SAIGE(Semantic-Aware Incremental Graph Evolution,语义感知增量图演化),一个轻量的协作机制:agent 按需派生,彼此的依赖靠「按内容去检索对方的结果」建立,协作图边执行边长出来,而不是一开始就把拓扑定死;③ 实验——在四个长程复杂任务基准上,SAIGE 在上下文效率和任务表现之间取得更好的权衡,而扩大 agent 池、加深递归层级都不能稳定改善结果。作者的收束是:不加区分地扩大多智能体规模的做法,值得重新考量。→ 详细
- 结论章原样重申:在单智能体 harness 越来越强的时代,多智能体协作并非普遍有益,只在稀疏依赖的长程任务上有系统性优势,因为那里能用上上下文隔离、又不至于付出过高的协调开销。→ 详细
动机:单智能体 harness 已经很成熟,通用多智能体框架却还停在「玩具级」
- 强基线已经立起来了:Claude Code(Anthropic)、Codex(OpenAI)、DeepSeek Harness 这类单智能体 harness 已经长成高度成熟的基础设施,能在真实场景里稳健地端到端执行;反观通用的多智能体协作框架,实践中往往「仍停留在玩具级别」——只在过于简单的基准上跑,性能提升也很微弱。差距越拉越大,逼着作者重新追问:比起一个装备齐全的单 agent,多 agent 到底何时、为何才有真实价值。→ 详细
- 流行解释不够硬:已有工作通常把多 agent 的主要优势归因于上下文隔离(context isolation:把任务切开,每个 agent 只看自己那一份),用来防止上下文污染(无关信息混进来干扰判断)和上下文腐化(context rot:上下文越堆越长,模型对里面信息的利用反而变差)。作者认为这个说法直觉上讨喜,但基本停留在定性层面、缺乏严谨的理论基础,所以要用图论把边界画出来。→ 详细
相关工作:多智能体协作与拓扑的谱系
理论①:把一次任务执行看成「依赖图」——拿掉某一步、后面那步就做不好,两步之间就连一条边
- 刻意走理想化路线:先问多 agent 协作从根本上对任务做了什么,再从答案里推出它的收益;理想与现实之间的差距不藏成隐含假设,而是当成可以用实验检验的预测。→ 详细
- 轨迹(trajectory):agent 做一件任务时逐步留下的记录,每一步=它收到的新观察 + 它采取的动作。走到第 t 步时,前面的全部历史都在,而它的决定可能只依赖其中任意一部分。→ 详细
- 依赖怎么判:如果把第 i 步从历史里拿掉,第 t 步那个动作的价值(预期能拿到的回报)会明显下降、超过一个预设阈值,就说第 t 步直接依赖第 i 步,从 i 到 t 连一条边。边永远指向更晚的步骤,所以整条轨迹天然构成一张 DAG(有向无环图:箭头只往前指、不会绕回来成环的图)。→ 详细
- 一个温和的假设:轨迹里没有多余步骤——每一步都至少影响后面某个决定,最后一步是唯一的终点,于是整张图是「弱连通」的(不看箭头方向时,所有步骤连成一整块)。作者说这在实践中不苛刻:不影响任何后续步骤的交互,本来就能删掉而不改变任务结果。→ 详细
理论②:桥边——删掉就让任务图断成两块的那条依赖,也就是两个 agent 之间唯一的交接线
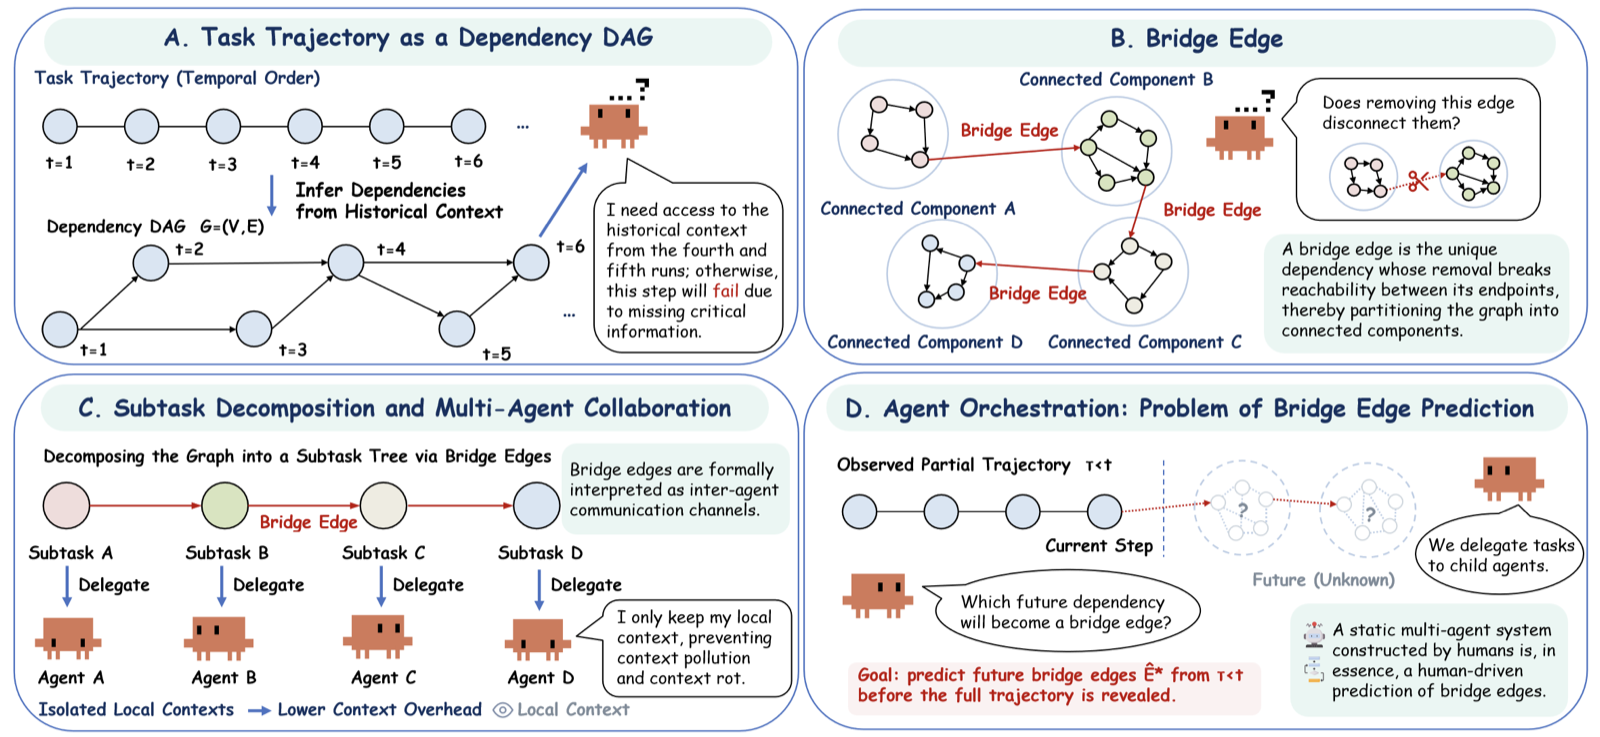 ▲ 图注:论文图 1。A 把按时间排开的任务轨迹推断成依赖 DAG,第 6 步的小机器人说「我需要第 4、5 步的历史上下文,否则会因缺关键信息而失败」;B 桥边是删掉就切断两端联系、把图分成几块连通分量的那条唯一依赖;C 沿桥边把图切成子任务 A–D,各委派给一个 agent,每个只留本地上下文,以防上下文污染和上下文腐化;D 编排的问题是在完整轨迹揭晓前,从已观察到的前半段预测未来哪条依赖会变成桥边,右下角写着:人工搭建的静态多 agent 系统,本质上是由人来预测桥边。
- 定义:图里有些边是连接不同区域的关键信息通道。删掉某条边,如果图会多出一块「弱连通分量」(不看箭头方向时彼此连成一片的一组步骤),这条边就是桥边(bridge edge)。大白话:桥边是两个子任务之间唯一的交接线,剪断它,任务就自然分成互不相干的两段。→ 详细
- 切出子任务:把所有桥边一起删掉,图就碎成 m 块,每块按时间排好就是一条子任务轨迹;所有子任务合起来恰好覆盖原轨迹、互不重叠。→ 详细
- 对应到多 agent:每个子任务交给一个独立 agent 执行,桥边就是这些 agent 之间的通信通道,只在必要时让信息跨过子任务边界流动;子任务之间再按桥边连起来,构成一棵子任务树(subtask tree),在子任务的粒度上描述信息怎么流。→ 详细
理论③:上下文成本引理——事先知道整条轨迹、又切得对,拆分只会省、不会多花
- 成本怎么记账:每往历史上下文里放进一步交互,都有一份计算开销。一个子任务的总上下文成本分两块:子任务内部一步步累积历史的成本,加上通过「进入它的桥边」从前面子任务拉上下文的成本——后者从依赖真正生效的那一步开始算,一直算到子任务结束;不拆分的整条轨迹没有入向桥边,成本就是一路把全部历史背到底。→ 详细
- 引理 1(Lemma 1):沿任意一条桥边把一段轨迹切成两段,两段的上下文成本之和不超过原来那一段;递归地切下去,全部子任务的成本之和也不超过整条轨迹。直观地说:不拆时,后面每一步都要背着前面所有步骤;拆开后,后一段只背自己的历史,外加桥边递过来的那一小份。作者据此确立:任务轨迹已知、分解执行正确时,多智能体分解能降低上下文成本。→ 详细
- 两个前提别漏看:结论建立在「完整轨迹可事先获知」的理想化条件上;作者也明说,这个分析没有考虑上下文压缩等可能改变成本结构的缓解手段。完整证明放在附录 A。→ 详细
理论④:编排的本质是「提前猜桥边」——人手搭的静态多 agent 系统,其实是人在替系统猜
- 事后分解 vs 事前预测:上面那套分解是事后(post-hoc)的,前提是已经看到整条轨迹和它的依赖结构;可现实里轨迹是一步步展开的,依赖图事先根本看不到。所以多 agent 编排(orchestration:决定拆不拆、怎么拆、谁跟谁通信的那层调度)真正要做的,是在只看到已走过的前半段时,预测未来哪些依赖会成为桥边。→ 详细
- 猜得准不准决定收益:编排的目标是让「真实桥边」与「预测桥边」这两组边的期望差异最小。猜对了,轨迹被切成真正的子任务;猜错了,分解就是次优的,省下的上下文成本也跟着缩水。图 1 的 D 格把这层意思说得更直白:人工搭建的静态多 agent 系统,本质上就是由人来预测桥边。→ 详细
讨论:协作何时值得、隔离要付什么代价、为什么加 agent 不管用
- 协作何时值得:恰恰是任务能拆出相对独立的子任务时——每个 agent 维持一个聚焦的上下文窗口,把与任务无关的信息挡在外面;单 agent 则只能不加区分地累积所有观察,信噪比下降,执行出错的风险上升。但这份收益取决于桥边猜得准不准:猜错一条边,要么让某个 agent 陷入局部死锁(local deadlock:一直在等一个永远不会出现的依赖,卡在原地),要么在 agent 们从错误划分里恢复时推高通信开销。→ 详细
- 隔离的代价:上下文隔离把每个 agent 的工作记忆限定在自己的子任务里,出了错也被关在相应范围内,不会污染全局上下文——这正好缓解了单 agent 在长程任务上的两个老毛病:工作流做不完整、过早收工。代价是总 token 消耗更高,因为分解本身拉长了整体工作流。换句话说,多 agent 买到的是「更完整、更不容易被带偏」,付出的是「更多 token」,不是白来的。→ 详细
- 为什么扩规模无济于事:每条桥边都是从已观察的前半段猜出来的,原文说 "prediction errors accumulate as the number of subtasks grows"——子任务越多,猜错累积得越多;同时每多一个 agent,就要在通信、同步和冲突消解上多付一份协调成本。于是加 agent 的边际收益递减,最终可能被累积误差和不断上涨的协调开销吃掉。这就是「更多 agent 不一定让系统更聪明」的理论解释,也直接引出 SAIGE 的设计原则:只在任务结构允许的地方才扩展协作图。→ 详细
SAIGE①:增量节点生成——不预先画组织图,跑到真有交接线的地方才派子 agent
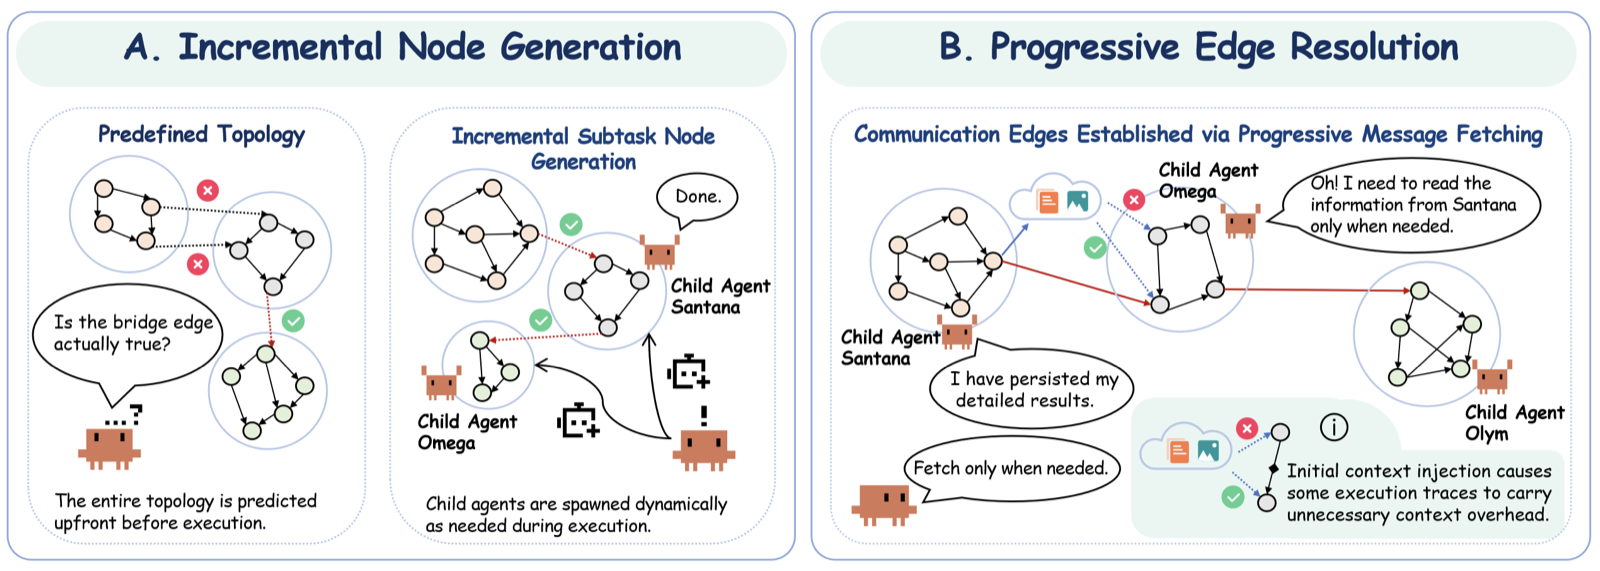 ▲ 图注:论文图 2。A 左边是「预定义拓扑」:执行前就把整张拓扑猜好,小机器人问「这条桥边真的成立吗?」,打叉的虚线是猜错的边;右边是「增量子任务节点生成」:执行过程中按需动态派生子 agent Santana 和 Omega。B 是渐进式边解析:子 agent Santana 说「我已把详细结果落盘」,Omega 说「只在需要时才去读 Santana 的信息」,右下角注明:一开始就注入上下文,会让部分执行轨迹背上不必要的上下文开销。
- 为什么不预先定拓扑:桥边天生难在一开始就可靠地预测,过早锁定一个静态拓扑,早期猜错会层层叠加。作者给了一个概率上的论证:SAIGE 是增量预测的,新一步的桥边集合只在上一步的基础上往里加,在「之前的都猜对了」这个前提下,新预测猜对的概率不低于从零一次性猜对的概率——结论是把边的预测推迟到执行证据攒够之后,比一开始就锁定拓扑更可靠。→ 详细
- 按需派生的规则:SAIGE 不预先分配子任务节点,而是由正在跑的 agent 边做边判断——只有发现一个满足桥边性质的依赖边界时,才委派一个子 agent。这种边界是一条单步依赖:跨过它之后,只要给一份有界的上下文摘要,子问题就能独立做完。有这样的边界,就把子问题连同一条自包含的指令(不需要回头追问、照着就能做完的任务说明)交给子 agent 自主执行;没有,就不派,父 agent 继续自己一口气做完整个任务。→ 详细
- 关键在「不派」:原文强调,正是这种有条件的委派,让 SAIGE 能在稠密耦合的任务上避开分解代价(decomposition penalty)。换句话说,SAIGE 的聪明之处不在于会拆,而在于知道什么时候别拆——后面的细粒度分析里,它在两个紧耦合基准上平均每题只实例化 1.10 和 1.22 个 agent(上限是 4)。→ 详细
SAIGE②:渐进式边解析——结果先落盘、要用时再去拉,不在开头一股脑推给下游
- 做法:子任务之间的边靠渐进式消息拉取(progressive message fetching)建立:每个 agent 做完就把结果写下来,别的 agent 只在真正需要时才去取。→ 详细
- 为什么更省:按需拉取的上下文成本只从「依赖真正生效的那一步」开始计;如果在子任务一开头就把所有依赖都塞进去,成本就得从第一步算起。所以就上下文成本而言,稀疏的按需检索优于基于推送的通信(push:上游做完主动把结果塞进下游的上下文)。→ 详细
- 更要紧的好处:通信通道是动态建立的,不在分解那一刻就定死,所以协作图能适应那些事先无法完全确定的依赖。原文的说法是,这把「全局拓扑预测」这道难题,转化成了一连串「以执行反馈为依据的局部检索决策」。→ 详细
实验设置:四个长程基准、四种对照方法,全部跑在同一个 harness 和同一个模型上
- 四个基准(benchmark,标准化考题集):Terminal Bench 2.1——困难、贴近真实的命令行任务,看解决率;NL2Repo Bench——只给一份自然语言需求文档、从零生成整个代码仓库,看所有任务的平均测试通过率;Deep Research Bench II——深度研究,按从专家报告里提炼的评分细则(rubric)打分,看通过的细则占比;AgentIF-OneDay——日常场景里通用 AI agent 的任务级指令遵循,实例级评分细则、二元判定、加分项与扣分项分开,还要核对产出文件的内容。→ 详细
- 四种对照:Single-Agent(整个任务在一个 agent 的上下文里做完,跑在原生 Codex CLI harness 上);TDAG(把任务拆成小子任务、为每个子任务专门生成子 agent,并把成功经验持续总结成可复用技能);DynTaskMAS(由动态任务图驱动的异步、并行多 agent 框架);GoA(Graph-of-Agents:采样相关 agent、按回复相关性连边、用图池化汇总回复)。→ 详细
- 统一口径:所有方法都在 Codex CLI harness 上实现,基座模型都是 DeepSeek-V4-Pro,多 agent 方法的 token 用量按全部 agent 汇总;所有多 agent 方法统一限定最大递归深度为 1(子 agent 不能再派自己的子 agent)、agent 总数最多 4 个,为的是系统稳定、防止执行中 agent 无节制地增殖——放宽这两个限制会怎样,留给消融实验。→ 详细
先分清两类任务:命令行与写仓库是「一环扣一环」,深度研究与日常事务是「大块各做各的」
主结果(表 1):紧耦合任务上通用多 agent 全输给单 agent、SAIGE 只做到打平,稀疏任务上 SAIGE 领先最多,token 还更省
表 1 主指标(越高越好,粗体为该列最佳):
| 方法 | Terminal Bench 2.1 解决率 | NL2Repo 通过率 | Deep Research Bench II 总分 | AgentIF-OneDay 总分 |
|---|---|---|---|---|
| Single-Agent | 76.71 | 48.74 | 51.49 | 53.57 |
| TDAG | 71.49 | 47.37 | 54.43 | 59.94 |
| DynTaskMAS | 68.27 | 44.15 | 53.44 | 65.85 |
| GoA | 67.47 | 41.04 | 48.40 | 52.67 |
| SAIGE | 75.50 | 49.23 | 55.23 | 71.80 |
表 1 token 用量(输入 / 输出,M=百万,越低越好,粗体为该列最省):
| 方法 | Terminal Bench 2.1 | NL2Repo | Deep Research Bench II | AgentIF-OneDay |
|---|---|---|---|---|
| Single-Agent | 475M / 8M | 1,408M / 10M | 2,805M / 7M | 189M / 2M |
| TDAG | 542M / 13M | 1,562M / 15M | 3,895M / 23M | 218M / 3M |
| DynTaskMAS | 533M / 12M | 1,386M / 15M | 3,240M / 21M | 233M / 4M |
| GoA | 621M / 16M | 1,380M / 14M | 3,816M / 23M | 222M / 3M |
| SAIGE | 501M / 10M | 1,282M / 11M | 2,745M / 20M | 185M / 3M |
- 紧耦合的两个基准,通用多 agent 全部掉到单 agent 之下:Terminal Bench 2.1 上单 agent 76.71,TDAG / DynTaskMAS / GoA 只有 71.49 / 68.27 / 67.47;NL2Repo 上单 agent 48.74,三者是 47.37 / 44.15 / 41.04。作者的解读是:分解把依赖链切碎了,协调开销可能超过上下文隔离带来的好处。SAIGE 没有出现这种退化——75.50 和 49.23,与单 agent 基本持平,token 也比其他三种多 agent 方法都少。→ 详细
- 稀疏的两个基准,分解开始显出好处:Deep Research Bench II 上 SAIGE 55.23(单 agent 51.49);AgentIF-OneDay 上 71.80,比单 agent 的 53.57 高出 18 分多,也明显高于次好的 DynTaskMAS(65.85),是全表最显眼的领先。而且没有别的多 agent 方法那种 token 膨胀:AgentIF-OneDay 输入 185M,比单 agent 的 189M 还少;Deep Research Bench II 输入 2,745M,低于单 agent 的 2,805M 和 TDAG 的 3,895M(不过输出 token 仍是 20M 对单 agent 的 7M)。→ 详细
- GoA 是反面教材:它的编排设计最精巧(采样 agent、按相关性连边、图池化汇总),结果四个基准的主指标全部垫底,Terminal Bench 2.1 上 token 还最多(621M / 16M)。原文的结论是:新增的协调复杂度如果和任务的依赖结构不匹配,本身并不能转化为收益。→ 详细
- 作者自己不夸大:SAIGE 并非每个基准都赢过单 agent(Terminal Bench 2.1 上仍低 1.21 分),优势主要在稀疏依赖任务上;但两种情形下它都拿到了较好的权衡——紧耦合时避开分解代价,可分解时用上上下文隔离,协作图跟着执行反馈长,而不是照一个预先定死的拓扑。→ 详细
失败模式:紧耦合任务上多 agent 容易「互相干等」,可拆任务上单 agent 容易「半途收工」
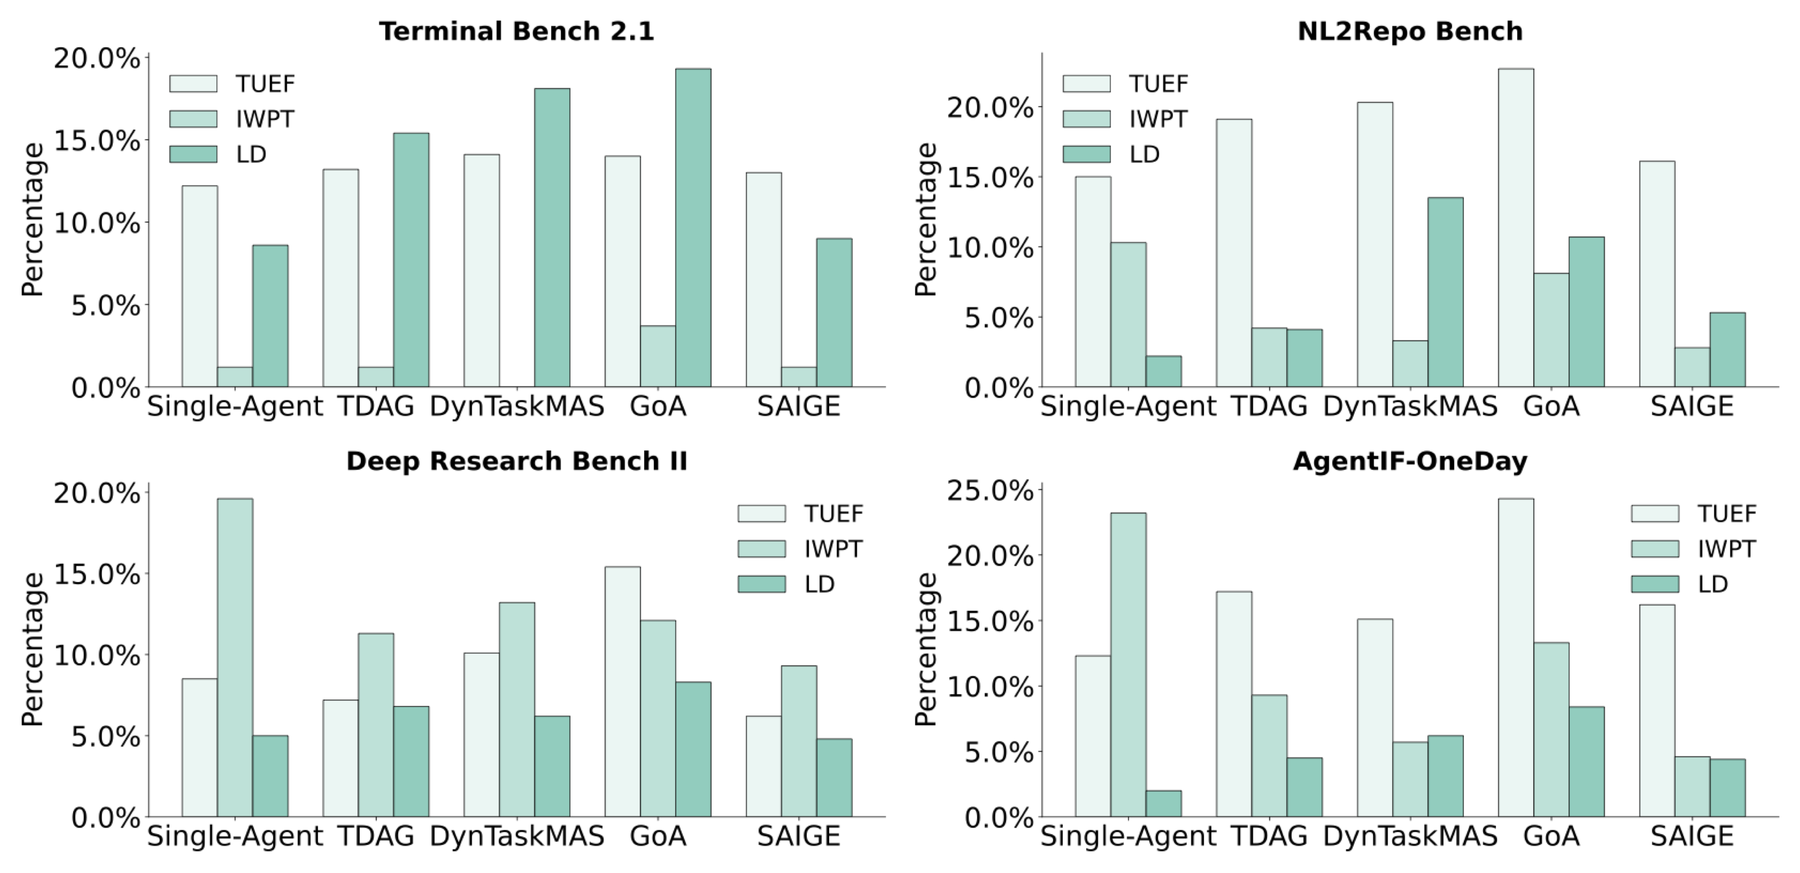 ▲ 图注:论文图 3,四个基准上低分轨迹的三类失败占比(最浅的柱是 TUEF 任务理解与执行失败,中间是 IWPT 工作流不完整与过早终止,最深是 LD 局部死锁)。左上 Terminal Bench 2.1 里多 agent 方法的 LD 柱最高(GoA 约 19%、DynTaskMAS 约 18%、TDAG 约 15%),单 agent 约 8.5%;下面两格 Deep Research Bench II 与 AgentIF-OneDay 里,单 agent 的 IWPT 柱明显高于其他方法(约 19.5% 与 23%)。
- 怎么归的类:收集评测得分显著低于基准平均的轨迹,用 DeepSeek-V4-Pro 对执行记录做语义分析,归纳出三类反复出现的失败:TUEF(任务理解与执行失败:没读懂要求或做错了)、IWPT(工作流不完整与过早终止:活没干完就收工)、LD(局部死锁:卡在等待、循环依赖或资源冲突里)。→ 详细
- 紧耦合任务 → 多 agent 更容易死锁:协调本身引入了等待、循环依赖和资源冲突,挡住了全局进展。按图 3 读数,Terminal Bench 2.1 上局部死锁的占比,GoA 约 19%、DynTaskMAS 约 18%、TDAG 约 15%,单 agent 约 8.5%,SAIGE 约 9%,与单 agent 相当。→ 详细
- 可分解任务 → 单 agent 更容易半途收工:上下文越积越多,逐步削弱了它追踪整条工具链的能力,于是在工作流通过验证、或满足解决判定标准之前就停了。按图 3 读数,单 agent 的「过早终止」在 Deep Research Bench II 约 19.5%、AgentIF-OneDay 约 23%,都是五种方法里最高的;SAIGE 分别约 9% 和 4.5%。→ 详细
- 合起来看:一边是「拆了就互相等」,一边是「不拆就背不动」——这两种倾向共同说明,只有任务结构允许有效分解时,多 agent 协作才划算。→ 详细
消融:agent 从 4 个加到 6 个、递归从 1 层加到 3 层,分数大多往下走、token 往上涨;关掉按需拉取也掉分
- 测什么:在两个稀疏依赖基准(Deep Research Bench II、AgentIF-OneDay)上,看 SAIGE 对 agent 数量上限(4 / 5 / 6)、最大递归深度(1 / 2 / 3)和渐进式消息拉取有多敏感;每种深度下都改 agent 上限,好看清两者的联合效应;「关掉消息拉取」是在默认深度 1 下禁用按需拉取。→ 详细
表 2 · Deep Research Bench II(总分 / 输入 token,粗体为默认配置):
| agent 上限 | 递归深度 1 | 深度 2 | 深度 3 | 关掉消息拉取 |
|---|---|---|---|---|
| 4 个 | 55.23 / 2,745M | 54.88 / 3,102M | 52.21 / 2,993M | 53.54 / 4,027M |
| 5 个 | 52.94 / 3,913M | 52.07 / 4,225M | 50.89 / 4,502M | 53.85 / 5,928M |
| 6 个 | 53.74 / 6,312M | 48.94 / 6,782M | 49.07 / 6,590M | 51.22 / 6,951M |
表 3 · AgentIF-OneDay(总分 / 输入 token,粗体为默认配置):
| agent 上限 | 递归深度 1 | 深度 2 | 深度 3 | 关掉消息拉取 |
|---|---|---|---|---|
| 4 个 | 71.80 / 185M | 66.39 / 261M | 63.17 / 272M | 66.22 / 237M |
| 5 个 | 67.32 / 239M | 58.33 / 272M | 58.76 / 270M | 59.15 / 268M |
| 6 个 | 64.02 / 352M | 60.16 / 360M | 56.75 / 371M | 53.50 / 366M |
- 默认配置两张表都是最优格:4 个 agent、深度 1 这一格,在两个基准上都是分数最高、输入 token 最省的(输出 token 差别不大:Deep Research Bench II 在 19M–34M 之间、6 个 agent 那一行最高,AgentIF-OneDay 都在 3M–4M)。→ 详细
- 多加 agent:把 agent 池扩到默认以上,往往分数更低、token 更高,只有个别配置偏离这个趋势。最直观的是 AgentIF-OneDay 深度 1 那一列:4 个 71.80 → 5 个 67.32 → 6 个 64.02,输入 token 却从 185M 涨到 239M、352M;Deep Research Bench II 同一列是 55.23 → 52.94 → 53.74(6 个时略回升,就是那种个别例外),输入 token 从 2,745M 涨到 6,312M,翻了一倍多。→ 详细
- 加深递归:允许子 agent 再派子 agent,同样倾向于降分、加 token——4 个 agent 时,AgentIF-OneDay 深度 1 / 2 / 3 分别是 71.80 / 66.39 / 63.17,Deep Research Bench II 是 55.23 / 54.88 / 52.21。→ 详细
- 关掉按需拉取:也伴随相当程度的下降,AgentIF-OneDay 上最明显——4 个 agent 时从 71.80 掉到 66.22,6 个时只剩 53.50;Deep Research Bench II 上 4 个 agent 时 55.23 → 53.54,输入 token 却从 2,745M 涨到 4,027M(5 个 agent 那一行是例外,关掉后 53.85 反而略高于 52.94)。→ 详细
- 结论:token 大体随 agent 数和递归深度一起涨,任务表现却没有相应提升。原文的判断是,超过某个临界点之后,边际上每多一个 agent,似乎只是在增加协调成本,带来的额外解题能力很有限。→ 详细
理论附录:两个定理和引理 1 的证明,用大白话说是什么
- 定理 1 · 依赖图一定是「连成一块、没有回路」的:只要轨迹里没有多余步骤,按「拿掉会掉分」定义出来的依赖图,一定是弱连通的有向无环图。直观理由:依赖只能从早的步骤指向晚的步骤,所以绕不出环;每一步都会往后影响某一步,顺着箭头走最后都汇到终点,于是任意两步都能经由终点连起来。→ 详细
- 定理 2 · 子任务之间的交接关系一定是一棵树:把桥边全删掉得到的各块,再按桥边连回去,结果一定连通且没有环。反证的直觉是:如果这些块之间能绕出一个圈,那圈上任何一条「桥边」删掉后,两端还能绕另一条路连上,它就不配叫桥边了。这保证了「子任务树」站得住——子任务之间的交接不会兜圈子。→ 详细
- 引理 1 的证明思路:把上下文成本拆成「内部」「外部」两块分别比。内部这块,不拆时后半段的每一步都得背着前半段的全部步骤,拆开后这一份整个省掉;外部这块,拆开后唯一新增的,是桥边起点那一步被递进后半段、从交接点开始一直背到结束的那一份,其他从更早子任务进来的依赖,要背的步数只会变少或不变。而省掉的那一份里,本来就包含「桥边起点那一步被后半段背着」,背的步数还只多不少——所以省下的至少抵得上新增的,拆分后总成本不会上升。→ 详细
实验细节(附录 B):各基准的评测口径,以及对照方法的配置
- Terminal Bench 2.1:每题有专属环境、人写的解法和验证测试;因为 agent 与模型的表现很难拆开(很多脚手架专为特定模型的习性调过),作者用只有一个无头终端(没有图形界面的命令行)的中立平台、只准用 Bash,每题跑三次取平均。→ 详细
- NL2Repo Bench:题目取自带 pytest 测试套件的真实 Python 库,生成的代码直接拿原库的上游测试来跑。→ 详细
- Deep Research Bench II / AgentIF-OneDay:前者分信息召回、分析、呈现三方面,评分细则经「LLM 抽取 → 自评迭代 → 人工修订 → 专家审核」四阶段构建;后者每题得分是满足的加分减去触发的扣分(不低于 0)再除以满分。AgentIF-OneDay 有看图需求,而 DeepSeek-V4-Pro 不支持多模态输入,作者配了一个脚本式 skill,让 agent 自行决定何时调用 DeepSeek-V4-Flash-Vision-Exp 看图,评测协议不变。→ 详细
- 对照方法:TDAG 的分解会依据前面任务的结果动态调整,成功模式沉淀成可复用 skill;DynTaskMAS 由任务图生成、异步并行执行、语义感知上下文管理、自适应工作流管理四个组件构成;GoA 的消息分「源到目标、目标到源」两阶段来回传递。→ 详细
- GoA 被统一成了同一个模型:原设计里不同 agent 用不同的基座模型,作者统一成同一模型、只按角色区分,好让对比只隔离出「编排本身」的作用——所以上文 GoA 垫底,说的是这套编排在同一模型下不占优。→ 详细
附录补充:分项得分(表 4/5)与对照方法的消融(图 4)
- Deep Research Bench II 分项(表 4):信息召回 / 分析 / 呈现 / 总分——Single-Agent 47.57 / 52.08 / 92.49 / 51.94;TDAG 50.72 / 53.56 / 91.15 / 54.43;DynTaskMAS 48.85 / 54.69 / 93.57 / 53.44;GoA 43.11 / 50.77 / 92.49 / 48.40;SAIGE 51.40 / 54.33 / 93.16 / 55.23。从表里看,SAIGE 的领先主要在信息召回(全表最高),分析略低于 DynTaskMAS,呈现各家都在 91–94 分之间、差别很小。(注:表 4 里单 agent 的总分是 51.94,与表 1 的 51.49 对不上,原文如此。)→ 详细
- AgentIF-OneDay 分项(表 5):内容 / 形式 / 执行 / 总分——Single-Agent 51.76 / 47.57 / 43.71 / 53.57;TDAG 60.92 / 59.42 / 48.12 / 59.94;DynTaskMAS 66.18 / 59.35 / 48.39 / 65.85;GoA 53.04 / 48.99 / 41.08 / 52.67;SAIGE 68.77 / 60.95 / 54.81 / 71.80。SAIGE 三个维度都是第一,拉开最多的是「执行」(54.81,次好的 DynTaskMAS 是 48.39)。→ 详细
- 对照方法也一样「越加越差」:作者对 TDAG 和 DynTaskMAS 也跑了五种配置的消融(图 4,每个点是一种配置):加 agent 或加深递归,通常都是分数降、token 涨;两个基准、两种方法上,都是默认配置(4 个 agent、深度 1)在分数与 token 成本之间的整体权衡最好,其余配置相对默认都落在「更贵、更差」的右下方。结论同上:多出来的 agent 和层级带来协调开销,却不提升解题能力。→ 详细
细粒度分析:SAIGE 按任务结构决定派几个 agent,桥边也找得最准——尤其是少漏
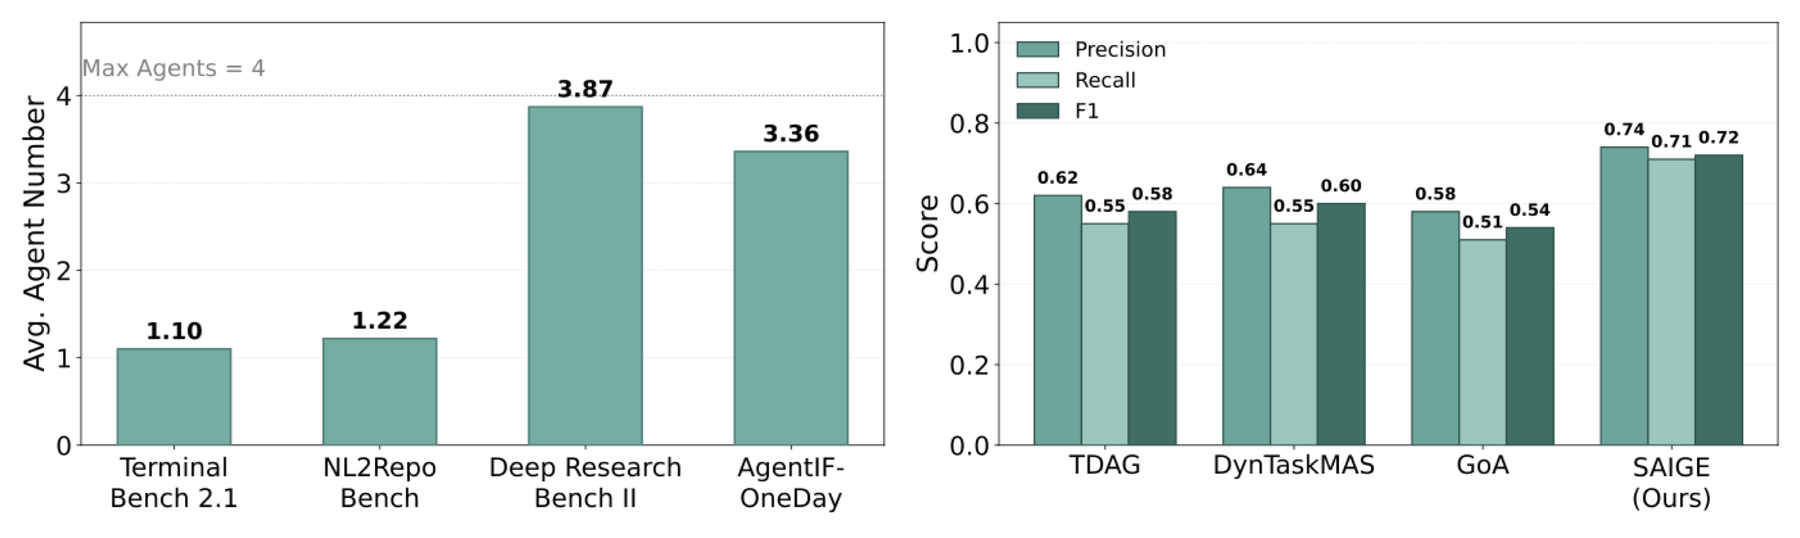 ▲ 图注:左为论文图 5,SAIGE 在四个基准上平均每题实例化的 agent 数(虚线是上限 4):Terminal Bench 2.1 为 1.10、NL2Repo 为 1.22、Deep Research Bench II 为 3.87、AgentIF-OneDay 为 3.36。右为论文图 6,AgentIF-OneDay 上桥边分解的精确率 / 召回率 / F1:TDAG 0.62 / 0.55 / 0.58,DynTaskMAS 0.64 / 0.55 / 0.60,GoA 0.58 / 0.51 / 0.54,SAIGE 0.74 / 0.71 / 0.72。
- 派几个 agent,跟着依赖结构走:为检验 SAIGE 是真按依赖结构有条件地拆、而不是乱派,作者统计了每题平均实例化的 agent 数。紧耦合的 Terminal Bench 2.1 和 NL2Repo 上只有 1.10 和 1.22——大多数子任务没法独立执行;稀疏依赖的 Deep Research Bench II 和 AgentIF-OneDay 上是 3.87 和 3.36,更积极地利用上下文隔离。原文据此说,agent 数量跟随的是基准的依赖结构,而不是某种固定分配策略,与「有条件委派」的准则一致;而且四个基准上的平均数都低于上限 4,SAIGE 不会把协作图扩张到任务结构允许的范围之外。→ 详细
- 「真实答案」怎么造:收集单 agent 在 AgentIF-OneDay 上的成功轨迹,用 DeepSeek-V4-Pro 逐对判断——对每一步和它之前的每一步,问「把前面那步从历史里拿掉,这一步的动作或观察会不会变」,得到一张只有 0 和 1 的依赖矩阵;再把「一删掉就让轨迹断成几块」的单步依赖认定为桥边,断开处就是任务可以拆成独立子任务的真实分解点。→ 详细
- 怎么给各方法打分:把每个方法生成的每条子 agent 轨迹(指令加已执行的步骤)用 DeepSeek-V4-Pro 语义匹配到真实的子任务块上;一条预测桥边如果和某条真实桥边连着同一对子任务,就算对。三个指标:精确率(precision:它认定的交接线里有多少是真的)、召回率(recall:真正的交接线它找到了多少)、F1(两者的综合分)。→ 详细
- 结果与含义:SAIGE 的分解在所有多 agent 方法里最准(F1 0.72,对 TDAG 0.58、DynTaskMAS 0.60、GoA 0.54),说明「增量、以执行为依据」的边预测,比静态或预先定死的分解更忠实地还原了真实的依赖边界。提升在召回率上最明显(0.71,其他三家 0.51–0.55),也就是更不容易漏掉桥边——而漏桥边恰恰是制造局部死锁的那种失败。作者称这是直接证据:SAIGE 在稀疏依赖基准上的提升,伴随着更准确的桥边预测,而且很可能正源于此。→ 详细
案例①:依赖矩阵——一眼看出哪种任务能拆、哪种不能
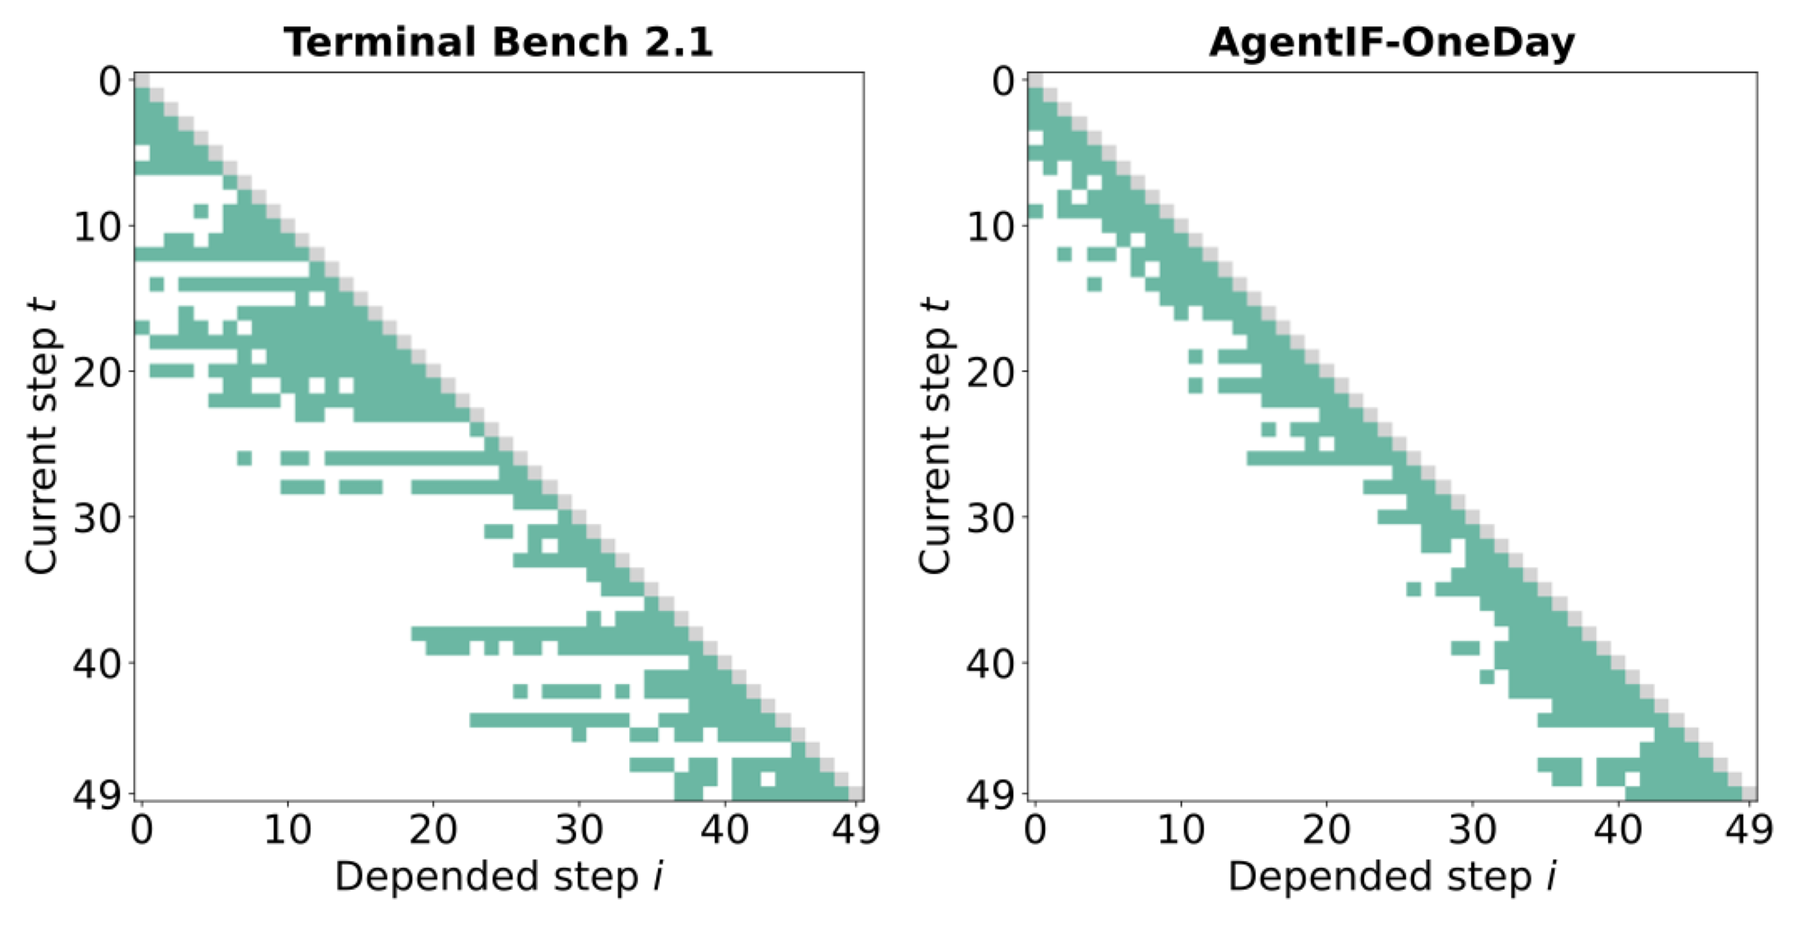 ▲ 图注:论文图 7,两条代表性单 agent 轨迹(各 50 步)的依赖矩阵,纵轴是当前步 t,横轴是被依赖的步 i,绿格表示第 t 步依赖第 i 步。左边 Terminal Bench 2.1 有大量横向长条,许多步骤依赖很早之前的步骤;右边 AgentIF-OneDay 的绿格基本贴着对角线,多数步骤只依赖紧挨着的前几步。
- 怎么画出来:从 Terminal Bench 2.1 和 AgentIF-OneDay 各挑一条有代表性的单 agent 轨迹,对每一步、以及它之前的每一步,用 DeepSeek-V4-Pro 判断「把前面那步从历史里拿掉,这一步的动作或观察会不会变」,会变就记 1、不变记 0,得到一张依赖矩阵(行是当前步,列是被依赖的步)。→ 详细
- 命令行任务:稠密、长距离:有不可忽视的一部分步骤依赖相隔很远的早期步骤,形成横跨大量先前步骤的长程依赖。这和连续的工具调用、读文件、写文件造成的长上下游链条吻合——后面的步骤必须消费前面的输出,几乎不可能独立执行。→ 详细
- 日常任务:稀疏、局部:非零格子集中在对角线附近,说明大多数步骤只依赖紧挨着的前几步,轨迹的大段内容可以互不依赖地推进。作者说这组对比直接体现了分析里的两种结构情形,也从单步层面说明了为什么多 agent 分解在紧耦合基准上受限、在稀疏依赖基准上依然可行。→ 详细
案例②:漏掉一条桥边,就能把本来会收敛的流程变成死锁——make-doom-for-mips
- 任务与依赖链:Terminal Bench 2.1 里的
make-doom-for-mips,要求 agent 构建一个 MIPS ELF(给 MIPS 架构处理器用的可执行程序文件),让它能在给定的、用 JavaScript 写的 MIPS 虚拟机里跑起来。这是一条很长的上下游链:虚拟机规定了系统调用 ABI(应用二进制接口:程序和系统打交道的约定)和内存布局 → 构建必须对准与之兼容的 MIPS ABI → 产出的 ELF 还得放进虚拟机里跑一遍才算验证通过。正确的分解必须保住连接这几个阶段的桥边。→ 详细 - 错在哪:只漏了一条桥边——真实依赖结构里,从「虚拟机内存布局」(第 3 步)指向「构建配置」(第 6 步)的那条依赖。它承载的正是「该用哪种 ABI 和内存模型」这个约束;在预测出来的结构里,这条边不存在。→ 详细
- 怎么死锁的:构建 agent 在不知道虚拟机内存布局的情况下配置 MIPS 工具链;验证 agent 一遍遍重新构建,等一个能满足那条被漏掉约束的构建结果。两边谁也打破不了这个圈:构建 agent 调的编译选项根本不是真正的瓶颈,验证 agent 则不停发起「重建—运行」循环。随之而来两笔代价:通信开销上升(反复的构建与运行消息始终不收敛),冗余执行累积(每一轮都重跑同样的构建和同样的虚拟机验证)。→ 详细
- 如果猜对了:构建配置会以虚拟机内存布局和系统调用 ABI 为前提,在第一次构建之前就选对 ABI 和软浮点(soft-float,用软件模拟浮点运算)配置;验证阶段拿到的是一致的 ELF,轨迹几轮「构建—运行」之后就结束。作者由此说明为什么编排天然可以表述成桥边预测:漏掉一条桥边,不只是少省一点上下文成本,还可能把一个本可收敛的工作流变成局部死锁。→ 详细
影响声明:协作该按任务结构有选择地引入,而不是默认选项
- 给从业者的主信息:多智能体的优势受任务结构约束,盲目扩大 agent 数量可能只增加协调开销、不提升表现。所以协作应该依据目标任务的依赖结构有选择地引入,而不是被当作默认的设计选择。→ 详细
- 正面影响:SAIGE 根据执行反馈长出协作图、靠按内容检索建立依赖,可能有助于减少不必要的上下文累积、提升长程执行的可靠性,对软件工程 agent、仓库级代码生成和深度研究助手这类应用有参考价值;把多 agent 分解的成本—性能权衡摆上台面,也可能促使这个领域形成更严谨的评估与报告习惯。→ 详细
- 风险:能力更强、更自主的 agent 系统可能被滥用,比如自动化利用软件漏洞、未经授权访问计算资源、大规模生成误导性内容;本文的基准运行在受控环境里,但底层技术并不天然局限于良性场景。另外,多 agent 分解会带来更难审计的失败——局部死锁、依赖误判、agent 之间不透明的协调——让调试、问责和监督都更复杂。→ 详细
- 读的时候记住这几条前提:理论结论建立在「完整轨迹事先可知」的理想化条件上,也没算上下文压缩(见上文六);SAIGE 并非每个基准都赢过单 agent(见上文十三);主实验里所有多 agent 方法都被统一限定在深度 1、最多 4 个 agent,放宽限制的消融只做在两个稀疏依赖基准上(见上文十五、十八)。→ 详细
闪电问答 / 收尾
本文为论文,无问答环节。
联系方式 / 资源
- 论文:arXiv 摘要页 https://arxiv.org/abs/2609.19759 ;HTML 版 https://arxiv.org/html/2609.19759v2
- 作者:Yishuo Yuan、Yibo Wu、Yihan Zhang、Minyuan Sun、Shenliang Li、Xinkai Ma、Yifan Li、Jiaheng Liu(除 Yihan Zhang 来自上海交通大学外,其余均为南京大学);通讯作者 Jiaheng Liu(南京大学)。→ 详细
- 文中用到的基准与对照方法:基准 Terminal Bench 2.1(Merrill et al., 2026)、NL2Repo Bench(Ding et al., 2026)、Deep Research Bench II(Li et al., 2026)、AgentIF-OneDay(Chen et al., 2026);对照 TDAG(Wang et al., 2025b)、DynTaskMAS(Yu et al., 2025)、Graph-of-Agents(Yun et al., 2026);统一的 harness 是 Codex CLI,基座模型 DeepSeek-V4-Pro。→ 详细