给品味做评测:爬坡优化一个幻灯片生成 agent
- 一Eval(评估)是把"感觉(vibes)"翻译成"可行动信息"的那座桥——eval 就是"给 AI 出一套题、定一套打分规则,看它在你这个具体活儿上到底行不行"。各家模型厂商发布时都会甩一张通用 benchmark(公开标准考卷)成绩单:衡量 agent 写代码能力的 SWE-bench、流行的 Terminal-Bench、衡量工具使用与 agent 操作的 Tau-bench / OSWorld、衡量推理与知识的 ARC-AGI 2。但讲者反复强调:这些通用分数只告诉你"模型整体多强、比上一代提升多少",对你那个非常具体的 use case(使用场景)"通常说明不了太多"——因为它们根本没在衡量你正在做的那件事。所以口号是"build your own evals(构建你自己的 eval)":它逼你把"成功长什么样"说清楚,并验证你每一次改动究竟是改进(improvement)还是退化(regression)。→ 详细
- 二三类 grader(打分器)各有取舍,而"品味/质量"这种主观东西只能靠模型来打、却极难校准——① 代码 grader(像写单元测试一样,字符串匹配/正则/模糊匹配)快、便宜、确定,但"脆(brittle)"且没有细腻拿捏;② 模型 grader(让另一个 AI 按 rubric〔评分标准清单〕来评、或两两对比、或多评委投票)灵活、可扩展、细腻,但不确定、更费钱、且"校准一点都不简单";③ 人工 grader(请领域专家通审)最贵最慢但质量最高,所以在搭 agentic 系统时用得最少,只适合 A/B 测试和抽查。全场最反复出现的现象就是:judge(模型评委)给的分老是虚高——一套很糟的幻灯片也给 2.8~4 分,甚至给一份"根本没有任何图片"的 deck,图片项打了满分 5。讲者的结论是:"这说明我们衡量的可能不是对的东西。"→ 详细
- 三Hill-climbing(逐步爬坡,即一小步一小步把质量往上推)的标准动作就是一个循环:看输出 → 找失败模式(failure mode) → 改 system prompt 或 grader → 再跑一遍。配套四个杀手锏:对抗式 QA 循环(明确告诉验收 agent"假设这里就是有问题,把它们找出来,把 QA 当成一场抓 bug 的狩猎,而不是走个确认的过场");给 judge 喂锚点(提供好/坏样例,告诉它 0 分长什么样、5 分长什么样);最重要的技巧——先列优缺点理由、再给分数(因为 LLM 是自回归〔auto-regressive,逐字往后接龙〕的,一旦先吐出"4 分",它就会硬给这个 4 分编理由);以及最"宏观"的一招——有时最简单的爬坡就是换个更聪明的模型:把一直在用的 Sonnet 4.6 换成 Opus 4.7,只喂最初那个极简 prompt,结果直接显著更好、连一个 emoji 都不用。→ 详细
开场与本场目标
讲者是 Anthropic 在 Code with Claude 大会上的单人分享者,开场连说三声"Hello",对到场人数表示真的有点意外:"来了这么多人,说实话我还挺意外的。"自称"任何跟 eval 相关的东西的铁杆粉丝(big fan of anything Evals related)",也坦承"我知道不是每个人都对这个感冒(not everyone's cup of tea)"——侧面说明 eval 平时偏冷门。→ 详细 本场目标有三:① 让你受到启发、听完愿意自己去建 eval;② 让你想清楚怎么思考构建 eval——"哪些类型的 eval 是有用的?";③ 让你学会怎么拿这些 eval 做出更好的 agent。→ 详细 贯穿全场的"教具"是现场构建一个幻灯片生成 agent——给主题、自动产出 PowerPoint,边做边摸索三问:"哪些是好的 eval?我们想衡量什么?怎么根据反馈做出更好的 agent?"→ 详细
什么是 eval
定义:"eval 就是一套系统化的测试,用来衡量一个 AI 系统在某个特定领域或使用场景下表现得有多好。" 大白话:给 AI 出一套贴合你实际用途的题、定好打分规则。它回答四个问题——"结果质量怎样?哪里做得好?哪里不行?怎么改进?"→ 详细 内部构造:eval 由一个个 task(任务) 组成,每个 task 定义一个场景,再通过 grading logic(打分逻辑) 把"某些预期"编码进去——一旦没通过,你立刻知道"agent 没按预期工作"。换句话说,eval 把"我希望它怎样"从脑中的模糊念头变成机器能自动判定的硬标准。→ 详细 它最典型的用武之地:当你想确保输出符合某种质量标准,或某些东西必须始终存在(this must always be present) 时,eval 就是把这种"预期行为"形式化编码下来的方式。→ 详细
eval 是"感觉(vibes)"通往"可行动信息"的桥梁
- 金句原话:eval 是一座桥梁,连接"它好像能用(it seems to work)""我们确定它能用(we know it works)"和"啊,不知道为什么今天感觉差了点(it kind of feels a little bit worse today for some reason)"这几种状态之间。 这三句话精准刻画了没有 eval 时团队的日常——全凭体感,谁也说不准。→ 详细
- 讲者并不一棍子打死"vibes(凭感觉)":"凭感觉是很难采取行动的……我觉得感觉当然有它的位置,它有用,能让你大致了解一下大家是什么体感。但它不太能转化成行动(they're not very actionable)。" 而 eval 给你的,恰恰是"可以据此行动的东西(something that's actionable)"。一句话:vibes 负责"察觉异常",eval 负责"指明怎么改"。→ 详细
官方 benchmark 成绩单:老面孔与它们的局限
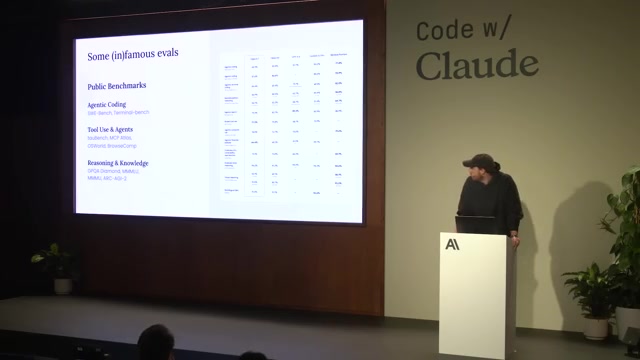
- 每次发布模型,厂商都会随之放出一份 benchmark 成绩单(accompanying benchmark scorecard):列出自家成绩,并和其他模型、竞品逐项对比。讲者说这里面"总有几个老面孔(a few usual suspects)"。benchmark(基准测试) 大白话就是"行业公认的标准化考卷",大家考同一套题好横向比高低。→ 详细
- 他逐个点名并说明各自测什么:SWE-bench——"非常有名的,衡量 agentic coding(让 AI 像工程师那样自主写代码改代码)能力";Terminal-Bench——"也挺流行的";Tau-bench、OSWorld——衡量 tool use(工具调用)和 agent 能力(AI 会不会调用外部工具、能不能在电脑环境里完成操作);ARC-AGI 2——属于推理与知识(reasoning and knowledge) 类。它们合起来"大致告诉我们:这个模型有多好,相比之前提升了多少"。→ 详细
- 关键转折(全场立论的根):"但对你们来说,如果你们在构建一个 agentic 系统,这些数字通常说明不了太多(this doesn't really say much usually)。" 原因很直白——"我们并没有去衡量你们正在做的那个非常具体的使用场景。我们衡量的是这些通用的、泛化的 benchmark,它们涵盖很多能力,但不一定适用于你们那个具体的 use case。"→ 详细
- 由此引出贯穿全场的口号:"build your own evals(构建你自己的 eval)"——拿不同模型来 benchmark、给你自己的 AI agent 做 benchmark,"确保你把模型的价值榨到最大(get the most out of the models),也确保你为这个活儿选对了模型(using the right model for the job)"。→ 详细
没有 eval 的痛:盲飞、被动循环、改一处坏多处
讲者给出一个人人都遇到过的场景当"安利理由":agent 本来好好的,客户反馈"它好像没达到应有水平,比如换了新模型之后感觉哪里不对劲(something is off)",你只能回"有没有日志,看看具体实例?"然后靠手动一点点 debug。→ 详细 这样你永远在"盲飞(flying blind)"和被动循环(reactive loop)里,基本上只能在生产环境(production)里才抓到问题;更糟的是连锁反应——"你改了个 prompt、做了点微调,结果突然让另外一些你压根没考虑到的任务的能力退化了"。→ 详细 还有"信噪"困扰:"要把真正有价值的反馈和噪音区分开也挺烦的……人们在感知这些事情时也带着各种偏见(biases)。"→ 详细 最重要的一条痛点(讲者明说"the most important one"):没有 eval,你没有任何办法验证"你做的东西到底是改进还是退化"——这正是 eval 存在的意义。→ 详细
有了 eval 的收益:清晰度、迭代配置、更快换模型、上线前暴露问题
- 收益一是 clarity(清晰度):eval 逼你定义"成功长什么样(define what does success look like)"。讲者的反问很扎心——"如果你连'agent 应该这样表现,对我来说成功的最终产物应该是这个样子'都没法清楚地说出口(can't even vocalize it to yourself),那你又怎么能确保它真的表现得当呢?"所以"构建这些 eval 会逼着你去定义、去把'你期望 agent 做什么'形式化(formalize)下来"。→ 详细
- 收益二是迭代出最优 agent 配置(optimal agent configs)+ 更快采用新模型:不再是"哦,我们也许试试这个新模型,看看行不行",而是有底气地说"它在这方面更好、在那方面没更好,这就是我们该或不该迁移的原因(this is why we should or should not migrate)"。讲者强调"考虑到新模型出现的速度,这一点尤其重要",而且它还帮你卸下一个心理负担——"你不用一直没完没了地去搞清楚'现在最前沿的是哪个'"。→ 详细
- 收益三是让问题在上线前就暴露(making problems visible before launch):讲者点出 eval 价值最高的地方——那些"一直表现稳定、你信得过、能提供大量洞见的案例(cases that you trust to provide a lot of insight),就是你从 eval 里能榨出最大价值的地方"。也就是说,少数高质量、可信赖的测试案例,比一大堆噪音案例更值钱。→ 详细
eval 如何融入开发流程:从 prompt engineering 到复杂 agent
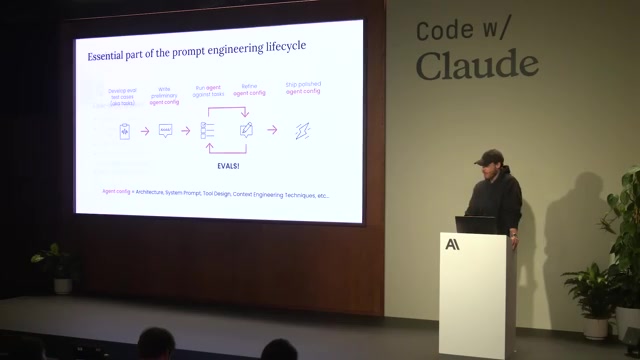
- 先看最早的 prompt engineering 流程(讲者拆成完整链路):① 先开发测试用例(test cases)——它们最终就是 eval → ② 写一个 prompt → ③ 拿这个 prompt 去跑这些任务 → ④ 稍微改改 prompt → ⑤ 再回去重新跑、反复打磨,直到"我在 eval 上表现得很棒,有信心系统运行正常了" → ⑥ 最后把这个打磨好的 prompt 发布出去。 注意顺序:eval 是第一步,先于写 prompt——你得先知道"怎么算对",才谈得上去优化。→ 详细
- 再看进入 agent 时代后的变化:现在 agent 带来了 tool calls(工具调用)、skills(技能)、各种优化 context(上下文)的方式,"系统变得越来越复杂"。讲者点出一个反直觉的因果:复杂度上升意味着"你能拉动的'杠杆(levers)'更多了"——可调的地方更多,这反而让 eval 更重要。因为 eval"逼着你用一种具体的方式去识别:这些是我们可以改的东西,这些是真正能正面影响系统的东西"。换句话说,可调旋钮越多,越需要 eval 来告诉你"拧哪个旋钮才真的有用"。流程本身没变(还是那套循环),只是"东西多得多、复杂得多"。→ 详细
三类 grader 之一:代码 grader(快、便宜、确定,但脆、缺细腻)
- grader(打分器) 的定义:讲者说它"就是我们认为可以用来评判输出的一种方式(a way how we can judge the output)"。第一类是 code-based grader(基于代码的 grader),"和软件工程里你可能熟悉的单元测试(unit test) 很像"——可以是字符串匹配(string match)、正则表达式(regex)、模糊匹配(fuzzy match),本质是一种"严格的分析(strict analysis)"。→ 详细
- 它的优点是快、便宜、确定性强(fast, cheap, deterministic),但有个大缺点:脆(brittle)且缺乏细腻拿捏(lacks in nuance)。"deterministic(确定性)"大白话就是"同样的输入永远给同样的判定,不会忽高忽低"。→ 详细
- 讲者专门掰开讲"脆"为什么有意思:确定性检查会强制某种确定性行为——"有时候这绝对正是我们想要的"。他当场举了那个后面会反复用到的例子:"假设你有一个 agent 专门生成幻灯片,你会想确保最后确实生成了一份幻灯片——这是个干净的确定性检查。但如果你想检查这份幻灯片的'质量怎么样',那就微妙多了(way more nuanced)——你很难把这种东西用一些确定性的检查编码出来。" 一句话:能不能数出来的事用代码 grader,好不好看这种事代码无能为力。→ 详细
三类 grader 之二:模型 grader(rubric、两两对比、多评委共识)
- 第二类是 model-based grader(基于模型的 grader),也就是让另一个 AI 来当评委,做"基于 rubric 的推理(rubric-based reasoning)"。rubric 大白话就是"一张评分标准清单 / 打分量规"。讲者举的最简单例子就是直接问模型:"这张幻灯片质量高吗?"(他承认"很笼统,但它就可以作为一条 rubric")或者"这段文字连贯吗(is this text coherent)?"→ 详细
- 玩法之一 pairwise comparison(两两对比),讲者直言"在我看来是相当被低估的(quite underrated)":给模型两份输出,问它"这两个你更喜欢哪一个,为什么?"。它的妙处在于特别适合那些"你没法明确定义'什么才算更好'"的场景——你说不清绝对标准,但你能让模型在两个里选一个并讲理由。→ 详细
- 玩法之二 multi-judge consensus(多评委共识):比如"取三选最优(best of three)",让三个评委各自独立打分,然后少数服从多数。背后逻辑很关键——"我们都知道 LLM 是不确定的(undeterministic):同一份输出你跑它 100 次,有几次它会说'哦,这个很棒',另外几次又会说'嗯,不太行'。" 所以多评委共识等于在说"咱们多投入点算力(put more compute into this),看看这一群 grader 大多数人的共识是什么"——用算力换确定性。→ 详细
- 模型 grader 的总评(讲者一字一顿列出来):优点——灵活(flexible)、可扩展(scalable)、细腻(nuanced);缺点——非确定(non-deterministic)、更费钱(costs more money)、且需要校准(requires calibration)。 而对最后这条,他特意埋了个伏笔:"校准——后面我们会看到,一点都不简单(not easy at all)。"→ 详细
三类 grader 之三:人工 grader(最贵最准,用得最少)
第三类也是最贵的 human grader(人工 grader):"你得请一位领域专家(subject matter expert)来对整个系统做一遍完整的评审。" 它又贵又慢(expensive and slow),但质量最高、最细腻(highest quality, very nuanced)。→ 详细 正因为太贵,讲者明说"在你搭建这些 agentic 系统的时候,这大概是你用得最少的一种 grader(you will be using the least)"。它的最佳用途被限定在两处:A/B 测试(A/B testing)和抽查(spot checking)——只在关键节点上少量地、抽样地动用人工,而不是当日常打分主力。→ 详细
动手:repo 结构与幻灯片 agent 的初始定义
讲者切到实操,先因人太多把原计划的互动式做法改成"我多自己来演示一点"。repo 主要动手区在 resources 目录,核心文件是 agent.yaml——"基本上就是你定义 agent 的地方",用的是大会上午讲过的 managed agent(托管 agent)。→ 详细 初始 system prompt 大意:"你是一个幻灯片生成 agent,当用户给你一个主题时,就在这个位置创建一个 PowerPoint 文件",外加一句工具说明"你有一个 shell,里面预装了 Python 的 python-pptx",并定义了一个装好所需包的 environment(运行环境)——刻意从极简起步,好让后面"加规矩"的爬坡看得清。→ 详细 现场观众互动:问"什么才算好 eval?"——一观众答"幻灯片上的字数",讲者认可"字数是可量化的(quantifiable),用代码 grader 容易数";另一观众喊"不要青色(No teal)",讲者回"完全没问题"。借此点出分工:"文字是否重叠、溢出框外(overlapping / overspilling) 用代码难编码,这种就用模型 grader。"→ 详细 演示用提前跑好(done beforehand)的结果:初版做出一份五页幻灯片(正好是要求张数),讲者吐槽"这不是你们见过最好的幻灯片"——文字重叠、左下角奇怪东西、莫名其妙的美元符号、配色奇怪,但"它是个不错的起点,至少做出了一份五页的幻灯片"。→ 详细
预置的两类 grader 与选 grader 的黄金原则
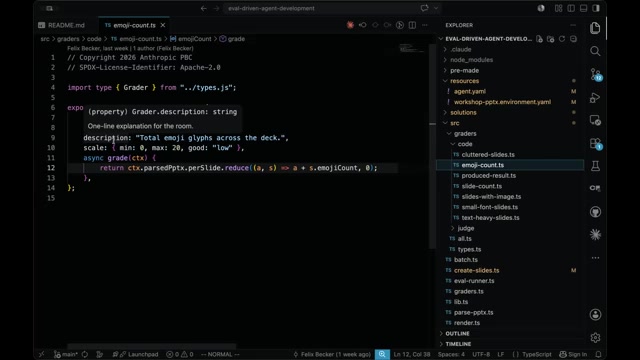
- repo 里预先放好两个 grader 目录。code 目录(确定性代码 grader) 包含:emoji count(数整份 deck 的 emoji——"因为我们注意到这个现象挺普遍")、cluttered slides(数幻灯片上的 shape〔形状/元素〕,太多算"杂乱")、slide count("总要求五张,确认确实有五张")、有没有带图片的幻灯片、字号是不是太小、文字是不是太多。讲者诚实说这些指标"在这个例子里选得相当随意(quite arbitrarily chosen),只是我们觉得挺有代表性"。→ 详细
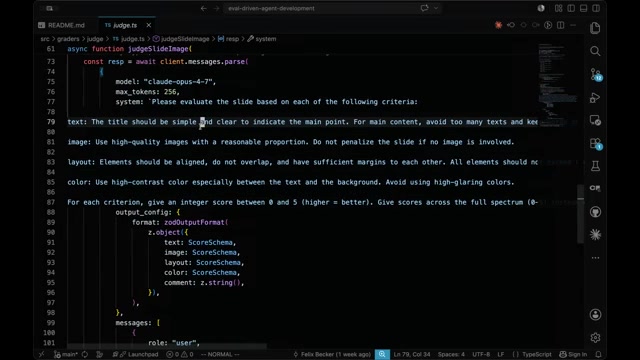
- judge 目录(模型评委 grader):比如 color judge——"基本上就是判断色彩对比度(color contrast) 怎么样,然后给出一个 0 到 5 的分数";image、layout、text 也各有一个对应的 judge。讲者现场念了 judge 的 system prompt 原话:"请根据以下每一条标准来评估这张幻灯片。文字:标题应当简洁清晰,点明主旨。正文部分:避免文字过多,用词要精炼。字号、字体样式和颜色要保持一致且易读(consistent and readable font size, style, and color)。" 并说明"它就这么一条一条往下写,对每一项想衡量的东西,都给一点'该重点关注什么'的说明"。→ 详细
- 选 grader 的黄金原则(可视为本场方法论核心之一):"什么才算一个好的 grader,真的是一个用例一个样(it really depends from use case to use case)。" 配套一条可操作的筛选标准——"如果一个 grader 你从里面得不到任何有用的信息,那它就不该出现在你的 eval 里(if you get no useful information out of it, you should not have that part of your eval)。" 落到每一项 grader,你都应该能回答三个问题:① 这是我想从中得到的信息;② 这是我正在测试的系统的哪一部分;③ 如果它出现退化,我该如何应对(how I can act on if it's being degraded)。→ 详细
第一次诊断:judge 分数虚高 + eval 是"活的东西",会饱和
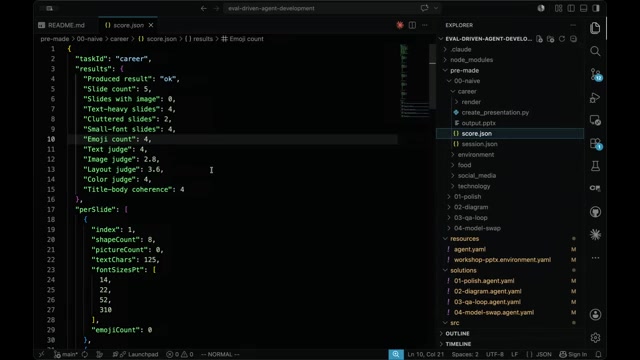
- repo 还附了一个自动打分小脚本(a nice little script):"它会自动帮你给幻灯片打分",最上面把所有指标列成一排(slide count、带图张数、文字过多、排版杂乱、字号过小),下面是几个 judge 给的 0~5 分(text / image / layout / color)。→ 详细
- 第一次校准诊断(带具体数字):讲者一眼指出"这些分数其实给得挺高的(quite high)"——"前面说过我们把分数校准在 0 到 5 之间,可以看到这里打出来的分大概在 2.8 到 4 之间,但凭我们刚才看到的那套(很糟的)幻灯片来说,我觉得这分确实给得偏高了。"这就是"需要做的校准(the calibration that needs to happen)"——评委的尺子明显太松。→ 详细
- 重要原则:eval 是 living artifact(活的产物),不是一次定死的"标准答案"。原话——"并不是说你的 eval 一旦搭好了,它就成了不可动摇的标准答案(the ground truth)。eval 是会随时间演进的,它得是一个活的东西,而不是你做一次就一劳永逸、做完就丢一边、以后所有决策都靠它来拍板。" 你得持续检查"这些 eval 是不是真的还在衡量对你有用的东西"。→ 详细
- 顺势讲清术语 saturation(饱和):"如果你听到有人说 eval 出现了 saturation,基本上指的就是——由于种种原因,这个 eval 已经给不出更多我们能据此采取行动的有效信息了(not giving any more relevant information that we can act on)。" 大白话:题做到满分或题本身失去区分度,这套考卷就"用旧了",得换新题。→ 详细
第一轮爬坡:把排版/防 AI 痕迹写进 system prompt
- 第一步改进只需更新 system prompt(不动别的)。加入对 typography(排版) 的具体期望——原话给到了字号层级:"幻灯片标题该多大、小节标题(section header)该多大、正文(body)多大、图注(caption)多大。"再加入 layout and density(布局与密度) 的说明:"正文保持简洁、留出呼吸空间(leave breathing room)、段落左对齐(left align paragraphs)。"这些都是冲着初版"字太小/字太多/读不下去"的毛病去的。→ 详细
- 还加了一条"避免 AI 生成痕迹(avoid AI generated tells)"——具体两条禁令:"标题里绝不要用那种细细的装饰线条(never use thin accent lines in the titles),也别在幻灯片上撒一堆当装饰图标用的 emoji(don't pepper slide with emojis as decorative icons)。" 讲者讲了动机背后的人性洞察:"如果我读到一段一看就是 AI 写的东西,我总会有点怀疑——我能不能完全信任这内容,以及发给我这段文字的人到底有没有自己读过、是不是真的认可并为这内容背书(has read it himself and is standing behind that content)。" 这些规矩全部基于 eval 里实测到的数字:初版 emoji count = 4、小字号幻灯片 = 4、排版杂乱 = 2、文字过多也有若干。→ 详细
- 新结果:明显更顺眼——"第一张一眼看上去就顺眼多了,没有那种互相重叠的东西,没有那个莫名其妙的美元符号,总体上就是更干净了";虽然"这张字还是偏小,但至少配色这块又稍微统一了一点","整套幻灯片又更协调了一些"。讲者顺势点明这就进入了那个核心循环——"找出哪里不对、迭代、再找出哪里不对、再跑一遍,就这样持续改进(finding what's wrong, iterating, finding what's wrong, running it again)"。→ 详细
grader 自身会出错:emoji=20 的误报与人工 review 的价值
- 再看新一轮分数时出现反常:"哦,这下反而突然变得糟糕多了。我们看到 emoji 数量是 20(emoji count 20),我都纳闷它们在哪儿,我实际上一个都没看见(I haven't seen them actually)。" 讲者当场怀疑"这是不是哪里搞错了(a mistake in this case)"——这是 grader 自己误报的活教材。同时他确认排版杂乱那项确实改进了。→ 详细
- 紧接着"文字过多"这项也出现人机分歧:脚本标了几张"文字过多",但讲者看了说"这几张是有点文字偏多,但我觉得可以接受(acceptable)"。他由此引出人工 review 的价值:"这又一次说明了人工 review 的价值——我们发现,我们在 eval 里定义的这些东西,可能并没有我们指望的那么严谨(not as well defined as we hoped)。"→ 详细
- 一条很犀利的判断法则:"当我现在就在这儿争辩说'这其实没我预期的那么文字过多'——这就意味着我们的评分方式其实有点问题(something is actually wrong with the way we're grading)。" 也就是说,当你发现自己在跟 grader 吵架,那往往是 grader 该改了,不是结果该改。对策:回到 grader 那里,改一改、更新它,确保它能更好地反映你真正想衡量的东西。→ 详细
- 收束强调:"校准你的 agent 该怎么表现、以及你的 judge 该怎么去评判具体的输出,这事儿其实非常微妙、非常容易翻车(really something very fickle)。你真得花上像样的时间(spend proper time)去琢磨怎么把这事做对。"→ 详细
第二轮爬坡:把"必须带图表"作为硬性要求
第二个改进目标来自一条新硬性要求:"假设我们想要一个永远都会带上图表的 agent。"做法还是更新 system prompt:"每一张幻灯片都必须至少包含一张生成的图示或图表,并且要作为真正的图片插进去(every slide must include at least one generated diagram or chart inserted as an actual image)",再跑一遍——讲者点出"可调的不止 prompt,还有 agent 里任何你能调的部分(any part of the agent that you can tune)"。→ 详细 案例 deck 以"加薪谈判(salary increase / negotiation)" 为主题:开篇页一张"不谈判 vs 主动谈判"的图,论点是"如果你为薪资主动谈判,'不谈判'和'谈判'的差距会越拉越大(the gap widens over time)",还附了额外 benchmark 数据。讲者评价"这一下子就好看多了,就因为它现在有真实的事实做依托(grounded into some actual facts),而不是满嘴跑火车、空话连篇(waffling)",并吐槽自己的小偏好"我不太喜欢在开篇放图,但这正是我们要求它做的,所以我就睁一只眼闭一只眼(let it slide)"。→ 详细
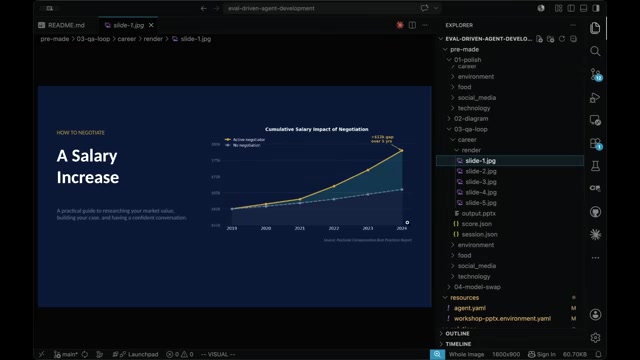
新分数:没有 emoji、没有排版杂乱,但"文字过多的幻灯片居然还是挺多的,有点意外(still quite text heavy surprisingly)",也还有小字号幻灯片(配图后"可接受")。再看 image judge 给 3.8 / 5——讲者立刻吐槽这是 judge 的老问题:"它没给我们太多可以参考的东西,就甩给我们一个随机数字(it just gives us a random number)。这数字什么意思?我们怎么照着它改进?"→ 详细
第三轮爬坡:对抗式 QA 循环("把 QA 当抓 bug 的狩猎")
- 引出一个通用招、几乎适用于每一种 use case(transversal over every single use case)的杀手锏:加一个 QA 循环(QA loop)。讲者先用写代码这个直观例子讲清机制:一个 agent 真正负责写代码,再加第二个 agent 专门去看已经写好的代码、纯粹地挑毛病——"这儿不行、那儿不行、这会引入一个 bug、那不符合规范(this introduces a bug, this is not according to standards)"。批判 agent 的反馈交回给创作 agent(creation agent) 去改,改完再交回,"如此这般一轮一轮地来回过招,直到双方都觉得'行了,这没问题,可以发布了(this is fine, we can ship this)'"。→ 详细
- 关键在于措辞要"对抗性(adversarially)"——这是本招的灵魂。写进 prompt 的原话:"假设存在问题,而你的任务就是把它们找出来。把 QA 当成一场抓 bug 的狩猎,而不是走个确认的过场(assume there are problems, and your job is to find them. Approach QA as a bug hunt, not a confirmation step)。"讲者特意对比正反两种说法:不是软绵绵的"哦,也许有点什么,你也许有兴趣去找找看(there might be something)";而是斩钉截铁地"这里就是有问题,去把它们找出来(There are issues. Go find them)"。他点明本质——"我们是在主动指示这个 agent 用一种对抗性的方式去做事"。→ 详细
- 具体执行指令(针对幻灯片的自检闭环):写完 deck 之后——"把它转成图片(convert it to images)。自己逐张检查每一张幻灯片的图(inspect every slide image yourself)。修掉问题、重新渲染、重新检查,并且不要停下来,直到你至少完成一轮完整的'修复并验证'循环(do not stop until you've completed at least one fixed and verified cycle)。" 讲者强调这套思路对写代码直观,对看幻灯片同样直观——"因为我们做的就是这件事:看着这些幻灯片,心想'啊,这个不行那个不行',把这些反馈拿来更新 grader、更新 system prompt,然后再跑一遍"。→ 详细
- 效果(带数字):"这一下子就好多了。" 图片明显变大、"即使站得远一点也清楚得多(more readable even from a further distance)"、标注了来源(there's a source over here)、结构更清晰("一张挺有意思的图表——你个人的价值取向画像对比团队平均值/your value profile versus team average")。他也诚实指出残留小瑕疵——"还冒出来一些奇怪的小刻度线(these weird ticks)……就是截图这个过程有点把这张幻灯片搞乱了"。最关键的是 judge 分数全线上扬:"我们创建的所有那些 judge,分数都比之前高了,现在都落在 4.2 到 4.4 这个区间了——所以我们走在一条不错的路上。"→ 详细
第四轮爬坡:直接换更聪明的模型(Sonnet 4.6 → Opus 4.7)
- 引出一种更"宏观"、也"更微妙"的爬坡:与其没完没了地手动定义"一张好幻灯片应该长什么样、什么该做什么不该做",不如干脆换一个更聪明的模型。讲者的理由——"随着这些模型越来越聪明、越来越强,你其实可以期待它们自己就能搞明白这些(figure that out on their own)。" 他把模型从之前一直在用的 Sonnet 4.6 换成 Opus 4.7(演讲中先口误说成 Sonnet 4.7 随即更正),并故意只给最初那个极简 prompt——"你是一个幻灯片生成 agent,当用户给你主题时创建一个 PowerPoint,然后给你一个 shell"。→ 详细
- 结果(很说明问题):"这只是个基础 prompt 而已,你一眼就能看出来它明显比 Sonnet 那一版好多了(significantly better than the Sonnet one),更有结构。" 两个具体表现——① Opus 干脆一个 emoji 都不用:"它差不多就知道,如果你要做一套关于加薪的幻灯片,emoji 大概不是该放上去的东西";② 字号过小的幻灯片也更少,因为它"天生就有那种内在认知(innate knowledge):这东西得能看清,一套幻灯片应该这样运作,人们对一套幻灯片的预期就是这样"。一句话:更强的模型自带"品味",很多规矩不用你教。→ 详细
- 但 judge 分数照样虚高、且更荒诞(带完整数字):总分一上来就极高——整体 4.4;图片项满分 5——"可这一版里我们到底有没有图片来着?其实,确实没有(we don't)";layout judge 4.2、color judge 4.8、title-body coherence(标题与正文一致性)4.4。讲者一锤定音:"这再一次说明:我们衡量的可能并不是对的东西(we might not be measuring the right thing)。而对这类 judge grader 来说,这种情况也并不太出人意料(not too unexpected)。"——给"零图片的 deck"打图片满分,正是模型评委不可靠的铁证。→ 详细
judge grader 的根本问题:缺锚点 + 该给好/坏样例
- 讲者把两类 grader 摆在一起对比:代码 grader 直白("emoji 计数相当简单,就数一数 emoji 的数量"),但"说到这种'评判(judging)',我们这里所做的其实相当有问题(quite problematic)"。根因——"我们基本上是说'给出一个 0 到 5 的分数',可它没有任何可以作为参照的锚点(it has nothing to anchor on)。它其实并不知道在这种情况下'好'到底长什么样,也不知道'差'长什么样。"→ 详细
- 这里存在一个永恒的权衡(trade-off):"模型本身到底知道什么,以及我们需要再额外喂给模型多少信息(how much more information we need to give),才能确保它给出一个像样的评判。" 改进做法是给它分档样例:原话——"这是一个差的例子。比方说这是个 0 分——一切都糟透了。出现这些征兆(telltale signs),就说明你面对的是一套排版极其糟糕的幻灯片。" 然后"随着时间推移,你可以把不同的分数区间一段段地描述出来(different ranges you can express)"。→ 详细
- 但讲者诚实泼冷水:即便给了锚点和样例,也不保证它给出好答案——"这并不意味着它就一定能给出一个好答案,因为我们现在拿到的,是这个我们的 LLM 出于某种原因决定输出的数字。比如在这个例子里,它就直接给了个 5。"于是问题又绕回来了——"好,那我们现在拿这个数字怎么办?是个 5。可我们刚刚说了,这套幻灯片里一张图片都没有,那我们要怎么去解读这个 5?"→ 详细
最重要的技巧:先列理由再给分(避开自回归锚定)
- 一种关键办法是:永远要求你的 judge grader 给出"它得出这个结论的理由(reasons why it came to that conclusion)"。但讲者紧接着抛出全场最重要的一个技巧细节——顺序(ordering)千万要小心。→ 详细
- 他讲了自己亲历的反面教训:"我在搭这套东西的时候就碰到过这种情况。我当时是这么干的:我先让它给出那个数字,然后我说'好,再告诉我你为什么这么打分'。结果它就说'哦,这是 4 分,理由是这些、这些和这些'。"——先分数、后理由,看似自然,实则埋雷。→ 详细
- 背后的机理(一定要懂):"LLM 是自回归(auto-regressive)地工作的"——大白话:它是一个字一个字往后接龙、后面的内容会被前面已写出的内容牵着走。"所以一旦它被锚定(anchored)在'4 分'上,它就会想尽一切办法去论证为什么这应该是 4 分。哪怕它其实糟糕透顶、本该是 1 分,它照样会说'哦,它在这些那些方面都不错'——因为它得为自己刚刚给出的那个 4 分找理由(it needs to justify the four that it put out)。"→ 详细
- 正确做法是把顺序彻底反过来:原话——"先说:'给我一堆理由。给我优点,给我缺点。给我它分数该高的理由,给我它分数该低的理由(give me pros, give me cons, reasons why it should be high, reasons why it should be bad)。'然后基于所有这些理由综合起来,你才去做出最终的输出判断。" 让模型先把正反证据都摆出来,再在证据之上结分,分数才不会被一个早早冒出的数字绑架。→ 详细
多 agent 验证 + 法律分析案例:防幻觉、找主要问题
这一招呼应前面的 QA 循环:你可以让多个 agent 来做验证——"让其中一个 agent 专门去找出所有问题,另一个 agent 则去反驳(refute)这些问题",用对抗+反驳逼出更可靠的判断。→ 详细 法律文书案例:假设你要分析一份文档,先从互联网获取大量背景信息(如一份法律文书),再让模型总结某个案件——判决了什么、对其他案件有什么法律影响(legal implications)。这类任务棘手,因为"法律案件通常相当 tricky,而一个 agent 特别喜欢张口就来、草率下结论说'这就是原因'(jump to conclusions)",这时 grader 能指出"这里说得不清楚(unclear)、这里可能不太对(untrue)、这里也许在掩盖真正的事实(glossing over the facts)"。→ 详细 对策与警示:把多种技巧结合起来——设多个 grader 分别评估,看看主要冒出来的是哪些问题(what are the main ones popping up)。为什么这么折腾?因为"grader 本身也可能会产生幻觉(a grader might still hallucinate things),尤其在那些非常微妙的场景里"——连"裁判"都可能看走眼,所以要靠多裁判交叉,最终才能拿到"高质量、一致、可落地执行(good, consistent output that is actionable)"的输出。→ 详细
收尾:这只是入门,benchmark 本质也是 eval
讲者自谦:今天展示的"基本上只是 evals 如何帮到你的一个小小入门(a small introduction),但绝对不是全部",还吐槽"用 45 分钟讲 evals 其实相当短,因为这话题真的可以挖得非常深(it can get really deep)"。→ 详细 首尾呼应:他提醒"我这一场是从聊 benchmark 开始的,而 benchmark 说到底也就是 evals",并抛出有力反问——"如果它不是我们构建新模型时最重要的事情之一,那为什么每一家模型厂商都会那么在意 benchmark、那么在意 evals 呢?"核心动机都一样——"我们需要找到自己做得不好的地方(find the things that we are failing at)。"→ 详细 收束金句:"我们擅长什么?我们不擅长什么?我们怎样才能在未来几代里把模型做得更好?而在构建那些用到 AI agent 的应用时,道理是一模一样的——就是去找出哪些有效、哪些无效,然后不断迭代(finding what works, finding what doesn't, iterating),并确保你所做的改动是建立在你对决策有充分了解的基础上,确保这些改动真的对最终输出产生了正面影响。"最后道别"非常感谢大家,我的时间就到这里了"。→ 详细
闪电问答 / 收尾
(本场为单人演讲,无独立的 lightning round 闪电问答环节。演讲中有少量与现场观众的即兴互动,已并入正文「十一、动手」一节:观众提议把"幻灯片字数"作为可量化指标、并提出"不要青色(teal)",讲者据此说明代码 grader 与模型 grader 的适用差异。收尾要点见正文「二十二、收尾」。)
联系方式
(本场为单人演讲,讲者未在演讲中留下个人联系方式。出品方为 Anthropic,Code with Claude 大会;视频地址见文首。)