在新代码库与老代码库上给编码 agent 做基准测试——Denys Linkov(Wisedocs)
- 一Wisedocs 处理的是动辄上万页的医疗理赔 PDF(有些文件比视频文件还大),跑这条 AI 管线的代码散在十多个 repo(repo =代码仓库,一个独立管理、独立发布的代码包)里、已经存在六年多、没人愿意去碰;2025 年他们决定用六个月把它合并成一个 monorepo(单一大仓库,所有代码收进同一个仓里管),这场演讲就是讲者的诚实复盘——这一步到底该现在做,还是该等模型再变强两代? → 详细
- 二他把同一个重构任务在不同世代的模型上重跑,当成一条私有基准线:当年 o3 在 Cursor 里来回聊了三小时、犯了十个重大错误;今天 Sonnet 4.6 只多迭代一轮就解决,Opus 4.8 基本 one-shot(一次成、不用返工),同一件事现在只要五分之一的时间——但换成让 GPT 5.5 的 extra high 档零样本直接重构整个代码库,它 10 分 22 秒交了 2,000 行代码,扒开一看只搭了脚手架、模型部分压根没实现。 → 详细
- 三他的答案是「值」:重建到功能对齐之后,pipeline 耗时降了、成本降了、能吃更大的文件,原本要几个月的功能一周之内就能上线;而更关键的反证是——AI 原生写出来的代码,正在以更快的速度长成新的 legacy,所以真问题不是「等不等模型」,而是「有没有护栏」。 → 详细
起点:三个问题,和一个六个月的赌注
 ▲ 图注:全场的分水岭章节页:2025 年 4 月,那次重构——从这里开始讲他们花六个月把十多个仓库并进 monorepo 的全过程。
- 业务先出问题,才轮到技术。2025 年 Wisedocs 在扩张,但「情况并不乐观」:客户加得太多、吞吐量跟不上。讲者把痛点拆成三条——第一,速度跟不上客户需求;第二,这套 AI pipeline(管线,指数据从进来到出结果要经过的一串处理环节)太复杂、改都改不动;第三,它是一套 legacy codebase(遗留代码库,指还在生产上跑、但没人愿意维护的老代码)——准确说是散在十多个 repo 里——「根本没人愿意去碰那些代码,那不是什么愉快的体验」。第三条是人的问题,不是技术问题,但它才是最后压垮决定的那根稻草。 → 详细
- 业务场景决定了这件事有多难:Wisedocs 处理复杂医疗理赔材料,PDF 动辄上万页,「有些文件比视频文件还大」,管线里跑着好几个 ML 模型——所以「把它各个部分扩容起来一点都不简单」,不是加机器就能解决的那种慢。 → 详细
- 他把整场演讲定义成一道复盘题:「我们做了个决定:用六个月做一次 refactor(重构,指不改变对外功能、只重写内部结构)。而今天这场分享真正想回答的问题是:这一步走对了吗?」——注意这不是成功学分享,是一次带反方论证的自我审判。 → 详细
技术债不是道德问题,是一笔要算清的 ROI
- 人人都写过烂代码,区别只在是不是明知故犯。他自嘲十五年前的自己:想把某个电子游戏角色的图片打印出来,却不明白 Java 里
System.out.println根本没法在屏幕上渲染图像。 → 详细 - 技术债要像金融债一样严谨地算:它「会以各种隐蔽甚至意想不到的方式利滚利」。你之所以愿意背债,是为了换 ROI——上一个新功能、拿下一个新客户。所以关键动作是确认这笔 ROI 算得过来:一旦往代码库里塞进额外的复杂度,「你赚到的那点 ROI 很快就会被吃光」。这句是全场的定盘星:后面所有「该不该现在重构」的争论,本质都是在比较这两条曲线谁涨得快。 → 详细
- 参照系是两个 Anthropic 的 case study——一个 Spotify、一个 Stripe,讲的都是他们在交付速度和重构代码能力上的巨大进展。这两个案例后面还会被他拿回来当「六个月后我们也能做到」的锚点。 → 详细
交付确实更快了,产品却没有更好
选型任务:当年花两个月,他说今天能快 90%
- 原来的做法:花了大概两个月给 AI pipeline 选编排器(orchestrator,负责调度管线里各步骤的执行顺序、重试、并发的那层),看了五个开源项目;启动时 Google 和 OpenAI 的 deep research 还没出来,「那种靠联网搜索做全面调研的能力当时还不存在」。需求梳理清楚后,用三个人的小组做了几个 POC(proof of concept,概念验证——先做个小样确认方案真能跑通)。人工一条条过、稍微用一点 AI,然后把所有东西堆进一份 Confluence 文档,按团队自己定的 17 个维度逐项评估。 → 详细
- 今天的做法:「我很有信心用手上的工具能快 90%」——先用 deep research 起头,把结果对照自己的问题陈述做校验,为每个评估维度、每个候选产品各开一个 sub-agent,最后再做 POC 和评估。注意这个结构:不是「让 AI 帮我调研」,而是把原来那 17 个维度直接变成 17 条并行的子任务。 → 详细
- 但质量标准得守住,因为人太容易掉进他说的「AI 精神错乱(AI psychosis)」——「你看着一份二十页的 deep research 报告说『哇,这看着不错』,结果那些功能在产品里压根不存在,你反而把自己拖后腿了」。快 90% 的前提是你仍然会去戳穿那份报告。 → 详细
【本期最值钱】同一个重构任务,跨模型代际重跑
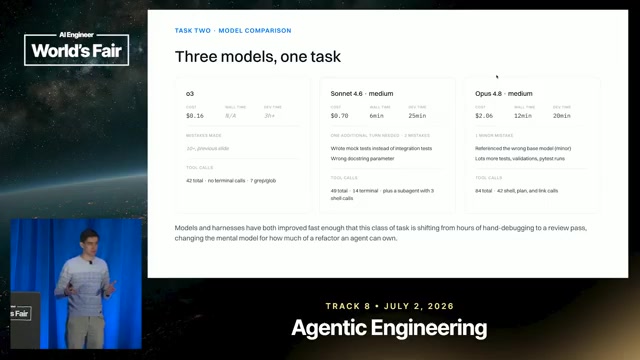 *▲ 图注:本场最值钱的一页:三个模型,同一个任务——左 o3、中 Sonnet、右 Opus,每列给出成本、耗时与结果差异。页面底部那句是结论:模型和 harness 都进步得足够快,这类任务正在从「几小时手工调试」变成「过一遍 review」,从而改变了「一次重构能交给 agent 多少」的心智模型。(转写里的模型版本号 ASR 不确定,以原片幻灯片为准。)*
- 基准任务是什么:他当时在用 Temporal(一个工作流编排框架,负责把一串任务按顺序、可重试、可恢复地跑起来)做初步调研,提交了一些 activity 和 workflow 的代码,目标是把 legacy codebase 里已有的东西复刻出来。他先把想做的事迭代拆解好,再交给 o3 去真正实现——「它确实比我快多了」。这道题就是后面所有代际对比的同一份考卷。 → 详细
| 模型 / 时点 | 同一个重构任务的结果 |
|---|---|
| o3(当时,在 Cursor 里) | 来回聊了 3 小时,犯了 10 个重大错误;全程「非常依赖人工——你得随时介入、给模型指路,还要手动改代码、删代码」 |
| Sonnet 4.6(现在重跑) | 只多迭代了一轮就把任务解决 |
| Opus 4.8(现在重跑) | 基本上是 one-shot 搞定的(一次成、不用返工) |
| 整体 | 「如果让我现在重做当初那个 refactor 任务,大概只需要原来五分之一的时间」 |
- 变的不只是成绩,还有模型的行为方式:「以前用 o3,在某些类别上几乎没有像样的工具调用」;到了 Sonnet 4.6 和 Opus,在现代 harness(承载模型干活的那层外壳——负责给它工具、管上下文、跑循环)里能看到 sub-agent、plan 类调用、各种 shell 命令、各种验证动作。也就是说新一代模型不是「答得更准」,而是自己会查、会计划、会验证。 → 详细
- 代价与收益的账:「虽然模型这一侧跑起来贵了一点,但人工介入少了很多,我们能完成的事情反而多得多。」——省的是人的注意力,花的是 token,这笔换算在他看来明显划算。 → 详细
- ⚠️ 模型名存疑(照原转写保留,未做「合理化」修改):Opus 4.8、GPT 5.5 extra high、以及后面 METR 那段的 Metis preview,都是自动转写出来的名字,置信度不确定;同段出现的 Sonnet 4.6 同理。另外「Incursr」几乎肯定是「in Cursor」被连读成一个词,中文按「在 Cursor 里」处理。数字(3 小时 / 10 个错误 / 五分之一)在原文里表述清晰,可信。 → 详细
软件开发生命周期的位移:从「喂代码片段」到「喂 spec」
别看 50% 那条线:METR 曲线该按 80%、90%、99% 来读
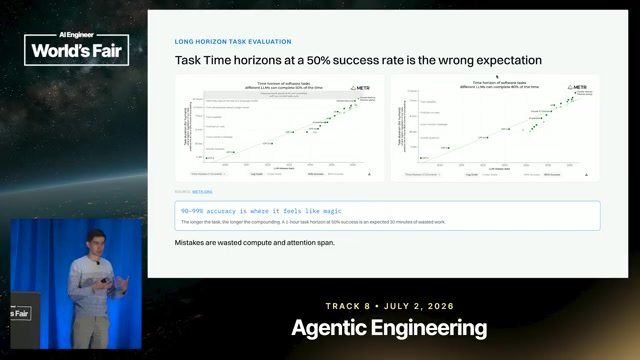 ▲ 图注:「按 50% 成功率去读任务时长曲线,是错误的预期」——两张 METR 曲线并排。下方蓝框那句是重点:90–99% 的准确率才是「感觉像魔法」的区间;再下面一行更狠——「错误就是被浪费掉的算力和注意力」。
- 一个全场共鸣的提问:「在座有谁启动了一个 agent 之后,才发现 prompt、计划或者需求本身是残缺的、漏东西的?」很多人举手。他描述那个画面:「你想着『好,可以开跑了,现在是晚上十一点或者傍晚五点,我先放个 agent 出去,回头再来看』,结果回来发现里面有个致命缺陷。」 → 详细
- METR 曲线是什么:一张广为流传的图,横轴是「这类任务人类要花多久」,纵轴是模型完成它的成功率——模型越强,能扛的长任务就越长。 → 详细
- 他的核心修正:「通常大家分享的是 50% 成功率那条线,但我觉得看 80% 甚至更高的成功率要有意义得多。」换到 80% 那条线,指数上升的趋势仍在,但你就不能再宣称模型能完成人类需要 18 小时以上才能做完的任务了。 → 详细
- 他真正想用的是 90% 和 99%,因为「那才是这套心智模型最划算的位置:你做好计划、写好 spec,交给 agent,然后你相当有把握它能把活干完」。反面账算得很直白:「如果你启动的是一个要跑一小时的流程,而它只有 50% 的完成概率,那你很可能就是白扔了这一小时,这段时间本来能干点别的。」——注意他扔掉的不只是算力,还有「你的注意力」。 → 详细
- 一个更扎心的数据点:METR 大约一个月前对前沿模型 Metis preview(名字存疑)的测试显示,成功率在四小时那个刻度上开始明显下滑;但即便在更早的位置——15 秒量级、甚至还没到 15 分钟量级——就已经有一些任务是它没法稳定、有效完成的。结论:「我们还没到『随手丢个 agent 出去就能可靠地把事做完』的阶段。」 → 详细
想做好 agentic 开发,得先把一批基础件铺下去
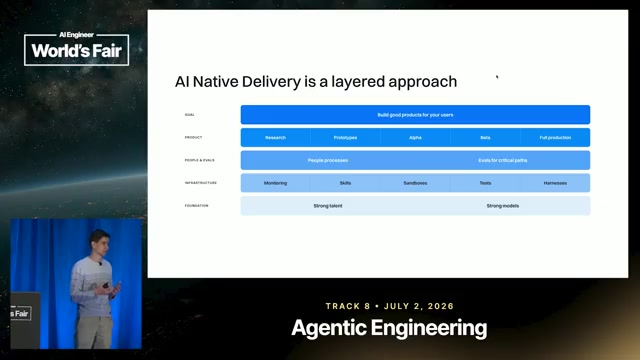 ▲ 图注:「AI 原生交付是一套分层结构」——顶层是为用户构建产品,往下依次是产品、流程与人、基础设施与工具、模型层。意思是 agent 能跑多远,取决于底下这几层铺没铺好。
- 「要想把 agentic 开发做好,你得先把一批框架和基础件(primitives)落地」——正是这些东西保证了他们「能有效地把方案落地,而不是陪着模型在原地打转、空耗时间」。这条他没展开细节,但明确说和这次大会上反复听到的一致。 → 详细
monorepo 之后的生产力数据:那条曲线陡到什么程度
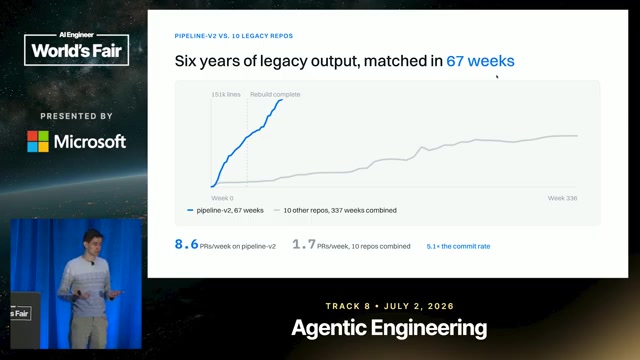 ▲ 图注:「六年的遗留产出,67 周就追平了」——蓝线是新的 pipeline-v2(67 周),灰线是另外 10 个老仓库加起来(337 周)。下方两个数字是关键:新仓库每周 8.6 个 PR,10 个老仓库合计每周 1.7 个,约 5.1 倍提交率。
- 动作本身很简单:把原来那 10 个 repo 合并成一个 monorepo,然后在上面继续加新功能。之前那些 repo 已经存在六年多了,「你能看到那段时间的推进速度相当慢」——一部分是背上的技术债,另一部分是「我们当时还没有 AI 编码工具」。 → 详细
- 重建的头六个月:等做到和以前功能对齐(parity)的时候,「那条曲线陡得惊人」。而且之后也没有减速——图上中间那条虚线之后,他们不断往这个仓里加新功能,交付速度快了非常多,既体现在代码量上(他自己吐槽「虽然代码量并不是个好指标」),也体现在开发者的提交频率上。 → 详细
- 参与人数是更硬的指标:他放的是一张提交数的对数图——中间有一段提交数偏少,因为「在纯 refactor、纯复刻的阶段提交代码要容易得多」;但到后期开始加产品功能时依然保住了速度。现在公司里几乎每个开发者都在往这个新 monorepo 提交代码,哪怕那不是他们的专长领域——他们可能只是需要改改 schema(数据表结构定义)、API 调用,或者技术栈里的其他部分。一个「没人愿意碰」的代码库,变成了「谁都能顺手改一笔」的代码库。 → 详细
第四章实验:现代 LLM 能不能一句话零样本重构整个代码库?
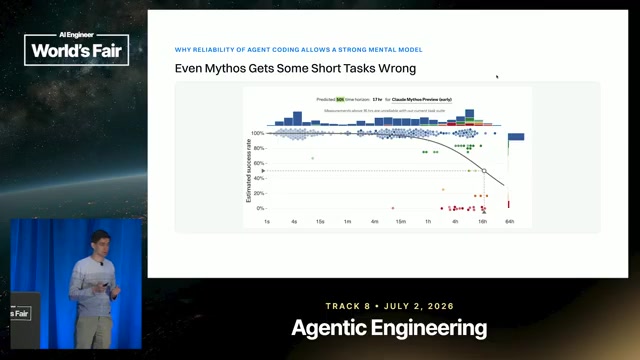 ▲ 图注:「连 Mythos 也会做错一些短任务」——横轴是任务时长、纵轴是成功率,散点显示即便最强模型在短任务上也有明显失手,这正是他质疑「零样本重构整库」的依据。
- 实验设计:「我能不能直接说一句『嘿,牛逼的 LLM,去把这个 codebase refactor 了』?」他用 GPT 5.5 的 extra high 档(名字存疑)设定目标,把几个 repo 的名字连同底层模型和其他组件都告诉它。 → 详细
- 结果:10 分 22 秒完成任务,只写了 2,000 行代码——「这就有点可疑了」。往深里扒之后发现:它其实只是搭了一堆脚手架,模型部分压根没实现。证据是它自己写在输出里的一句:「我还没有加 Ray Serve 的 deployment,也没加 bootstrap 命令。」 → 详细
- 他的判读:「所以我们还没到模型能自我校验、一把梭解决这类问题的阶段,但已经在逼近了。我觉得再过六个月,我们就能像 Stripe 那个案例里一样,稳定地完成相当有分量的 refactor。」注意关键词是「稳定」——不是「能做到一次」,是「across the board 地一致做到」。 → 详细
正反两方:等模型确实越来越划算,但 AI 写的代码正在变成新的 legacy
- 反方(该等)的理由他自己先说全了:「一切都在快速变好,模型在变强,工具调用能力在变强,我们还有了 sandbox、监控框架这些基础设施,能真正看清模型引擎盖底下发生了什么。所以『先背着技术债、以后再 refactor』这个选项,正在以指数级的速度变得越来越容易。」 → 详细
- 但他给了一条把反方顶回去的反证:「很多时候你在这种 AI 原生的模式下写出大量代码,写着写着它就开始长得像我们过去见过的那些 legacy code:代码量很大,性能和质量都不高,而更麻烦的是,没人真正搞得清里面到底发生了什么。」一旦出问题、或者要按客户需求调整,改起来就难得多。所以不管你做全量重构还是只重构一部分,都必须有合适的护栏(guardrails)。 → 详细
- 最终答案:值。他的逻辑链是完整的两段——第一段,当年为了满足客户需求,用好几个 repo 搭出那套模式,花了不少时间,但最终确实达成了业务目标(也就是说当初背那笔债本身没错);第二段,然后回过头来 refactor,速度就起来了:pipeline 耗时降下来了、成本降下来了、能支持更大的文件,而且原本要几个月才能做完的功能,一周之内就能上线。 → 详细
比速度更持久的收益:开发者终于愿意进这个代码库了
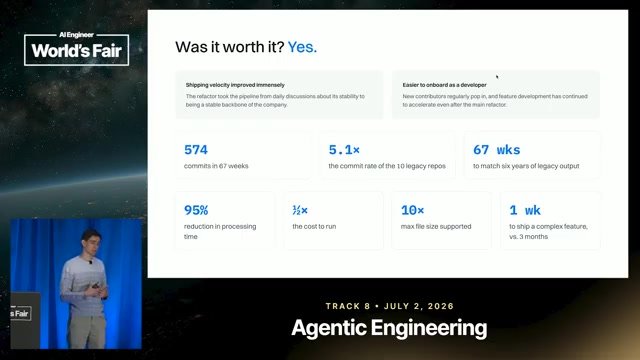 ▲ 图注:「值不值?值。」——他把六个月的账摊开:574 次提交 / 5.1 倍于 10 个老仓库的提交率 / 67 周追平六年产出 / 处理时间降 95% / 运行成本减半 / 支持的最大文件大小提升 10 倍 / 复杂功能从 3 个月压到 1 周。左上两栏写的是比数字更持久的那部分:交付节奏稳了,新人上手也容易了。
闪电问答 / 收尾
现场 Q&A 三问(讲者复述了问题再作答):
Q1:你们之前是多个 repo,后来真的迁到 monorepo 了吗?
- 「是的,我们迁了。」但他补了个反直觉的观察:模型在多个 repo 之间导航的能力已经强很多了——只要你把它们放到一个上层文件夹里,它就能在文件目录里找路。 → 详细
- 那为什么还要合? 因为「要做端到端的测试、验证和部署,多 repo 依然难得多」;而且如果你要搭一个沙箱环境跑一整套「AI 工厂」式的流程,克隆多个 repo、把环境都装好也更费时间。也就是说:合并的理由不再是「让模型读得懂」,而是「让结果验得了、跑得起来」。 → 详细
Q2:定下功能和需求之后,你们会回头核对、做调整吗?那套护栏框架是怎么回事?
- 「我记得我们推进这次 refactor 的时候,17 条需求里做对了 15 条。」——这是全场唯一一个把重构成果量化成「对了几条」的数字,也说明他们真的有一份可核对的需求清单。 → 详细
- 验证流程是边做边长出来的:「我们刚开始做的时候,plan mode(先出计划、人确认后再动手的模式)才刚进 Claude Code,Cursor 里还没有这个东西,但我们把它纳入了自己的开发流程。」 → 详细
- 谁当闸门:「那次 refactor 期间 PR review 全部是人工 review 的。」他们也在本地跑了一些检查——用 skills 让它「审一下这段代码,确认没问题」,「而且这类工具的自主性还在不断变强」。 → 详细
- 人工 PR review 的额外用途:在那个阶段,「PR 对我们来说是建立这个 repo 上下文的绝佳方式——因为参与的开发者只有几个人,我们希望大家都清楚这次 refactor 里到底改了什么」。review 在这里不只是把关,更是同步理解。 → 详细
Q3:往后哪些因素会变?
联系方式
(本期无)——讲者 Denys Linkov 只在开场提到自己就职于 Wisedocs,全场未留任何社交账号、邮箱或链接。