← 主页 NO.31
专栏 · Agent 工程手艺 › 第 31 期 · AI 产品 · 收录于 2026 年 8 月 16 日
Andrej Karpathy:软件(再次)正在改变
双人对谈 · 本期速读电台 00:00 / 01:01:41
TL;DR · 三句话
- 一软件在底层 70 年没怎么变,最近几年却接连变了两次:从 Software 1.0(人手写的代码)→ 2.0(用数据"训"出来的神经网络权重)→ 3.0(直接用英语写 prompt 去指挥大模型 LLM)。Karpathy 自己的原话是"软件在这么底层的层面上,已经七十年没怎么变过了,然后在过去这几年里,它差不多以非常快的速度变了两次"。这件事的分量在于:世界上现存的海量软件——他用一张 "map of GitHub"(把人类写过的所有代码画成一张星图)来让你直观感受这片版图有多大——现在都面临被重写、重做。对刚要入行的学生来说,这是天大的机会窗口("有海量的活要干——海量的软件要写、要重写"),但前提是你三种"写法"都得会,而且要能根据任务在它们之间流畅地来回切换,因为"它们各有各的小优缺点",没有哪一种永远最优。→ 详细
- 二LLM(大语言模型,能用自然语言对话的 AI)本质是一种"新型计算机",Karpathy 用三个类比层层逼近它的样子:它像电网/公用事业(实验室砸资本开支把模型训出来 ≈ 建电网,再按 token 计量把"智能"输送给你 ≈ 按用电量收费);也像芯片厂 fab(烧天量资金、技术壁垒极深、研发机密都往实验室内部集中);但最像操作系统(不是水电那种简单大宗商品,而是一整套复杂软件生态,有闭源有开源)。而且我们正处在它的"1960 年代"——算力太贵,所以智能都集中在云端、大家像当年一屋子人共用一台大型机那样分时排队共用。它还干了件前所未有的事:把技术普及的顺序倒了过来——历史上电力、计算机、GPS 都是政府大企业先用,这次却是普通人先用上(拿它问"鸡蛋怎么煮"),企业和政府反而落在后面。→ 详细
- 三当下最该做的产品是"部分自治 app"——AI 负责生成、人负责把关:用顺手的图形界面(GUI)让人快速验证(因为看图能动用大脑里那块"视觉 GPU",是一条直通大脑的高速公路,比逐字读文本快太多),再给一个"自治滑杆"决定放多少权给 AI。别急着造全自动 agent——他拿自己在特斯拉和 2013 年坐 Waymo 的亲身经历警告:"2025 是 agent 元年"这种话让他非常担忧,这分明是"agent 的十年"("the decade of agents"),软件跟开车一样棘手,长期都需要"人在回路"。一句最响亮的口号收尾:多造"钢铁侠战衣"(增强人、人还在驾驶舱里),少造"钢铁侠机器人"(花哨但甩手不管的全自动 demo),然后用十年时间把那根滑杆一点点从左推到右。→ 详细
01
核心命题:软件 70 年没大变,过去几年却变了两次
- 一开场他就把时机点透了:台下"很多人都还是学生——本科、硕士、博士……你们正准备进入这个行业",核心情绪是"现在其实是个特别特殊、特别有意思的入行时机。" 标题里那个"又一次"(Again)也有出处:这题目他之前讲过一回,"但软件一直在变,所以我手上一直有新素材去做新演讲"——变化快到连讲稿都得不断翻新,本身就是"软件在变天"的侧写。→ 详细
- 他的核心判断:计算机软件最底层的样子大约 70 年没怎么变过;然后就在最近这几年,以非常快的速度连着变了两次。"70 年"与"最近几年"的强烈反差是全场地基——一个几十年纹丝不动的东西突然连变两次,意味着积累的存量极其庞大。于是那句给学生打气的话:"现在有海量的活要干——海量的软件要写、要重写(a huge amount of software to write and rewrite)。"越是存量大、变得急,刚入行的人能撬动的空间就越大。→ 详细
- 为让"软件版图有多大"可感知,他先放一张 "map of GitHub"(真实可视化工具,把人类写过的所有代码画成一张星图)当引子,让你"放大来看"那密密麻麻的代码仓库——它们归根结底都是"给计算机的指令,让它在数字世界里去完成各种任务"。用意:先让你震撼于这片版图的辽阔,再抛出重话——这么大一片版图,正在被新范式改写。→ 详细
02
三种"写软件"的范式:Software 1.0 / 2.0 / 3.0
- Software 1.0 是传统编程——人用 Python、C++ 一行行写明确指令,"是你为计算机写的代码"。Software 2.0 是 Karpathy 几年前就观察到并亲自起名的概念:"出现了一种新类型的软件,我当时把它叫做 Software 2.0。"写法截然不同:你不直接写逻辑了,而是"调数据集(tuning the data sets),然后跑一个优化器(optimizer),去生成神经网络的参数/权重(weights,网络里那几百万、几十亿个数字)"。换句话说,2.0 的"代码"是这一大堆训练出来的数字,程序员的工作从"写指令"变成"准备数据、调训练"。他补了句有历史感的话:当时"神经网络多少还被看作只是另一种分类器,跟决策树差不多",所以"Software 2.0"这个框架更点醒人——它把神经网络从"众多分类器之一"重新定位成"一种全新的软件形态"。→ 详细
- 2.0 也长出自己的一整套基础设施,与 1.0 一一对应:"Hugging Face 在 Software 2.0 里基本上就等价于 GitHub"(一个存模型、一个存代码);还有人把上面的模型画成 "model atlas"(模型星图),对应 1.0 那张 "map of GitHub"。他指出图中那个巨大的圆圈是 flux 的参数(flux 是文生图模型),并把 2.0 的协作类比到 git 上:"每当有人在 flux 模型之上做微调,你基本上就在这个空间里产生了一次 git commit,造出了一种不一样的图像生成器。" 他还用 AlexNet(深度学习史上里程碑式的图像识别网络)作为 2.0 的具体例子。→ 详细
- Software 3.0 是这次演讲的真正主角,关键在"可编程"三个字:"直到最近我们熟悉的所有神经网络,基本上都像固定功能的计算机(fixed function computers)——从图像到类别之类的"(喂进一张图,吐出一个标签,功能写死改不了)。"而我觉得已经发生、且相当根本性的改变,是神经网络变得可编程了,靠的就是大语言模型。" 过去是一台功能焊死的机器,现在变成一台你可以下指令、改用途的通用机器——这才是"新计算机"说法的由来。"它值得有一个新的称呼:Software 3.0。本质上,你的 prompt(提示词)现在就是程序,是用来给 LLM 编程的程序。"→ 详细
- 为让三种范式落地,他举情感分类(判断一句话正面还是负面)为例:同一件事可三种写法任选——"写一段 Python 来做"(1.0,手写规则)、"训练一个神经网络"(2.0,用数据喂)、"或者去 prompt 一个大语言模型"(3.0,用英语描述任务)。3.0 就是写一个 few-shot prompt(给模型看几个例子让它照办),"改一改它,用稍微不同的方式去给计算机编程"——改 prompt 就像改代码,调一调措辞,程序行为就变了。→ 详细
- 他特别点出这次最让他震撼的不是"新"、而是"用母语":"它还是用我们的母语——英语来写的,所以它是一种非常有意思的编程语言。" 分量在于:传统编程语言再"高级"也要专门学,而英语是几十亿人天生就会的——这把"会编程"的门槛从专业技能降成了"会说话"。他观察到代码形态都在变:"很多 GitHub 上的代码已经不再只是代码了,里面夹杂着一堆英语和代码混在一起"。这事几年前让他"大开眼界(blew my mind)",于是发了那条至今置顶的推文金句:"很了不起,我们现在是用英语在给计算机编程。"→ 详细
03
特斯拉 Autopilot 的亲身实证:2.0 一点点"吃掉"1.0
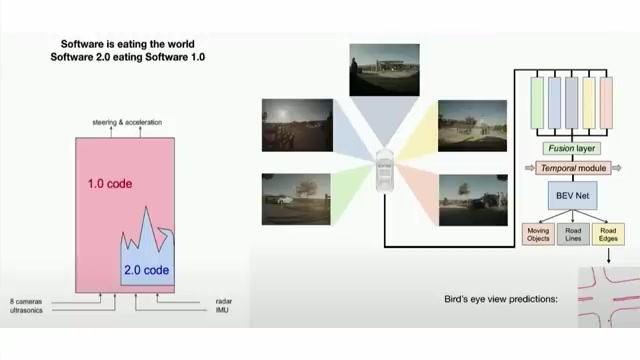
- 这不是空谈:Karpathy 在特斯拉做 Autopilot 时亲眼见证 2.0 蚕食 1.0。系统结构是"车的输入在最底下,经过一整套软件栈,最后产出转向和加速";随时间推移,"神经网络的能力和体量不断增长,与此同时那些 C++ 代码在被一点点删掉,很多原本用 1.0 写的功能逐渐迁移到 2.0"。具体例子是把多摄像头、跨时间的图像信息"缝合"成连贯图景——原来大量人写代码干,后来"交给神经网络,于是得以删掉大量代码"。一句总结:"Software 2.0 这套栈真真切切地把 Autopilot 整个软件栈'吃'掉了(ate through the software stack)。" 现在 3.0 正在更大范围重演同一幕——"它正在一路吃穿整个软件栈"。所以忠告很实在:1.0/2.0/3.0 三种范式都得"游刃有余(fluent)",还要能按任务"流畅地来回切换(fluidly transition)",因为"它们各有各的小优缺点"。日常要做的取舍他一连串列出:"某个功能想用 1.0、2.0 还是 3.0 写?训练神经网络还是直接 prompt?这块该不该是显式写出来的代码?这些决策我们都得自己拿。"→ 详细→ 详细
04
把 LLM 看成"新电力":它有公用事业的一面
- 第一大块的目标是讲清"这个新计算机是什么、什么样子、生态什么样",他会一连给三个类比(公用事业 → 芯片厂 → 操作系统)层层递进。第一个借 Andrew Ng(吴恩达,"待会儿就紧接着我上台")的名言"AI 是新的电力"——因为 LLM 现在确实给人一种公用事业(utility,水电煤那种按需取用的基础服务)的感觉。拆细:OpenAI、Gemini、Anthropic 这些实验室"花大量资本开支(capex)训练 LLM,好比搭建一张电网",再通过 API 按计量收费把智能输送给你(按每百万 token 付费 ≈ 按用电量收 opex);于是诉求也"用电化"了——低延迟、高可用、稳定质量。家里有 转换开关(transfer switch) 在电网/太阳能/电池间切,LLM 世界对应 OpenRouter;而且"因为 LLM 是软件,不争抢物理空间,你完全可以有六家'供电商'随时切换"。他还造了个传神的词:就在演讲前几天"很多 LLM 都宕机了,大家一下子卡住没法干活",那就像全世界经历一次"智能限电(intelligence brownout)"——"我们对这些模型越依赖,整个地球就越变笨"。→ 详细→ 详细→ 详细
05
LLM 也像芯片厂(fab)
- 但单一类比抓不全本质:"LLM 不只有公用事业的属性,还带有一些晶圆厂(fab)的属性"——因为钱和技术门槛高得吓人:"建一个 LLM 的资本开支相当庞大,这可不像建个发电站,你要砸进巨额资金,而且这项技术的'科技树'还在飞快往上长",结果"研发的秘密都在向 LLM 实验室内部集中"。半导体术语他一一对上:"4 纳米制程节点也许对应某个有特定算力上限的集群";用 Nvidia GPU 只做软件像无晶圆厂(fabless)模式,"像 Google 那样在自研 TPU 上训练,就像 Intel——你拥有自己的晶圆厂"。但他诚实标了边界:"这个类比有点站不住,因为这是软件,而软件的护城河要弱一些——它太容易被改写、太有可塑性了(malleable)。"(芯片厂壁垒是物理的、难复制;软件底层逻辑一旦被摸清就容易被重写、被开源版追上。)所以他把它定位成"一个值得琢磨一下的有意思话题",分量不如下一个最准的"操作系统"类比。→ 详细→ 详细
06
最贴切的类比:LLM 是新一代"操作系统"
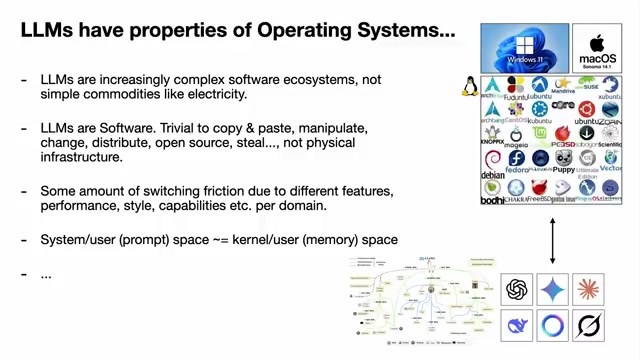
- 三个类比里他认为最准的是操作系统(OS):"LLM 跟操作系统有非常强的相似性。"关键在复杂度:"这不只是电、不只是水,不是那种从水龙头流出来的大宗商品。这些东西越来越像复杂的软件生态系统",重点还不只在模型本身,"还有所有的 tool use(调用外部工具)、多模态,以及这一切怎么协同"。生态格局也长得一模一样:"你有几家闭源提供方,就像 Windows 或 macOS;然后有一个开源替代品,就像 Linux"——当前 llama 生态(Meta 开源)"最有可能成长为某种 Linux",但他反复强调"非常早期",今天的格局只是雏形。对应关系画得很整齐:LLM ≈ CPU、context window(上下文窗口)≈ 内存,LLM 调度内存和算力来解决问题(这个映射后面讲"顺行性遗忘"时反复用到)。他还举"跨平台"类比说明可移植性:拿一个 LLM app 比如 Cursor,让它跑在 GPT、Claude 或 Gemini 上,就是一个下拉菜单(drop down)的事——上层应用和底层模型解耦,正是操作系统生态的典型特征。→ 详细→ 详细→ 详细→ 详细
07
我们正处在 LLM 的"1960 年代":算力太贵,所以分时共用
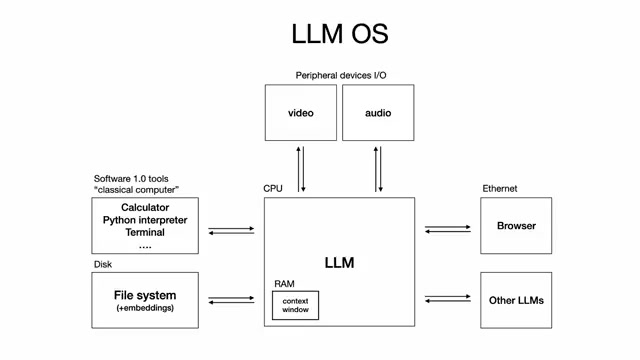
- 一个让他"印象很深"的时间定位:我们现在处在 1960 年代——"LLM 算力还非常昂贵,迫使它必须集中部署在云端,我们所有人都只是瘦客户端(thin client)",没人能独占算力,于是"采用分时(time sharing)很合理——我们每个人只是这一批(batch)里的一个维度","operating system 都在云端,所有东西流式传输,还有 batching"。属于个人的"AI 个人电脑革命还没到"——"它就是不划算(not economical)、没有道理。不过有些人在尝试";早期苗头是 Mac mini 适合跑某些 LLM,"因为 batch size 为 1 的推理基本全是受内存带宽限制的(super memory bound)"(高内存带宽恰是 Mac mini 的强项)。他还点出当前交互多原始:"直接用文字跟 ChatGPT 对话,我感觉像透过终端(terminal)跟操作系统打交道"——"目前还没真正以通用方式发明出 GUI,还没有那种横跨所有任务的 GUI"。形态远未定型:"也许你们当中有人就能发明出它应该是什么样子。"→ 详细→ 详细→ 详细
08
LLM 把"新技术普及的顺序"倒过来了
- 一个他专门写过文章的特性:"LLM 翻转了技术扩散的方向(flip the direction of technology diffusion)。" 历史常规路径是——电力、密码学、计算、飞行、互联网、GPS"通常最先使用它们的都是政府和大公司,因为它又新又贵,要到后来才扩散给普通消费者"。"但 LLM 有点反过来了。" 他用带点幽默的对比点破:"早期计算机全是关于弹道学和军事用途,但 LLM 全是关于怎么煮个鸡蛋——这肯定是我自己很大一部分用途";"事实上在采用所有这些技术上,企业和政府反而落在我们所有人后面。" 这对创业者的启发是:既然普通人先用起来,那"最早的一批 app 会出现在哪里、该面向谁做"答案也变了——不必盯政府大企业招标,去服务那个已经人手一个、正拿 AI 问东问西的普通用户群。他给第一部分作的小结:"LLM 是复杂的操作系统,处在大约 1960 年代的计算阶段,通过分时方式、像公用事业一样供给;真正前所未有的是,它们不掌握在少数政府和大公司手里,而是掌握在我们所有人手里——ChatGPT 几乎一夜之间瞬间被广播到几十亿人的计算机上,这太疯狂了。现在轮到我们进入这个行业、去给这些计算机编程。"→ 详细→ 详细→ 详细→ 详细
09
LLM 的"心理画像":像人的精魂,记忆力却超凡
- 教人"给 LLM 编程"前,他说得先搞懂"这些东西到底是什么",而且切入点很特别——不是技术参数、而是它们的"心理学(psychology)":与其把 LLM 当一段代码,不如当成一个有脾气、有长处也有怪癖的"人"来打交道。核心比喻:"我喜欢这样理解 LLM:它们有点像人的精魂(people spirits)。它们是对人类的随机性(stochastic,同一问题问两次答案可能不一样)模拟。" 来龙去脉他讲透了:模拟器是一个自回归(autoregressive)transformer,"在 token 层级上运作,一块一块一块地往下走(go chunk chunk chunk,逐个字块往下猜下一个词),每一块花的算力几乎相等";这个模拟器"涉及一堆权重,我们把它拟合到整个互联网上的所有文本"。关键因果链:正因为它在人类写的海量数据上训练,"它就有了涌现出来的、类似人类的心理(emergent psychology that is humanlike)"——它像人不是被刻意设计,而是"读人读多了"自然长出来的。它的第一个超能力是记忆:"LLM 拥有百科全书式的知识和记忆,比任何单个人类记住的都多得多。"他用 《雨人》(Rain Man) 打比方("真心推荐去看"):"Dustin Hoffman 演一个自闭症天才(autistic savant),有近乎完美的记忆力——可以读一本电话簿,然后把所有名字和电话号码都记下来";LLM 也"能记住 SHA 哈希值之类各种东西,非常非常轻松"(人记不住的乱码字符串,模型过目不忘)。→ 详细→ 详细
10
LLM 的认知缺陷:聪明得参差不齐,还会"失忆"
- 有超能力,但马上转折——"它们同时也有一堆认知缺陷(cognitive deficits)",这正是后面反复强调"人要留在回路里验证"的原因。
- ① 幻觉:它们会 hallucinate(一本正经编造不存在的事实,语气笃定内容是假)"相当频繁,对自我也没有很好的内在认知模型(不太清楚自己懂不懂,该说'我不知道'时反而硬答)"——一个会信口胡说、又意识不到的助手,必须有人替它把关。→ 详细
- ② 锯齿状智能(jagged intelligence):他造的词——"它们在某些问题求解领域会是超人级的,然后却犯一些基本上没有任何人类会犯的错误"。两个著名翻车例子:坚持说 9.11 比 9.9 大,或说 strawberry 里有两个 R(实际有 3 个)——"有一些粗糙的边角,你会在上面绊倒"。→ 详细
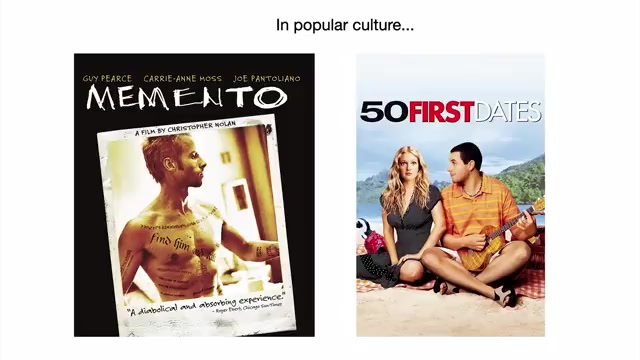
- ③ 顺行性遗忘(anterograde amnesia,能记住过去、却记不住"此刻之后新发生的事"):对照特别鲜明。真人新同事会"随着时间积累起对组织海量的上下文;回家睡觉就把知识巩固下来(consolidate knowledge),慢慢发展出专长";而LLM 天生做不到:"这在 LLM 研发里也还没真正被解决。context window 更像工作记忆(working memory,一块用完就清空的临时白板)——你得相当直接地去给它编程"。这直接解释了"机会一"里为什么 app 要替你打理 context:模型自己不会积累。"很多人就是在这种类比上栽了跟头。"他用 《记忆碎片》(Memento)和《初恋50次》(50 First Dates) 打比方——"主角的权重是固定的,而他们的 context window 每天早上都会被清空",正对应模型每次对话都从一块擦干净的白板重新开始。→ 详细
- ④ 安全短板:"LLM 相当容易上当(gullible),很容易受到 prompt injection 风险的影响"(坏人把恶意指令藏在模型会读到的内容里劫持它),"它们可能泄露你的数据"。
- 这一整段的结论收成一句心法,也是后半场所有"机会"的出发点:"你必须同时把这件事想透:这是一个超人级的东西,同时又带着一堆认知缺陷。而它们偏偏又极其有用,所以我们要怎么给它们编程、怎么绕开缺陷、同时享受超人能力。"→ 详细
11
机会一:做"部分自治 app",好产品都有这四个共性
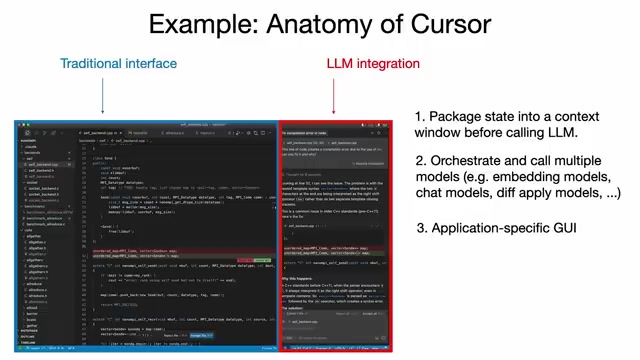
- 进入后半场"机会"主线,他先打预防针:"这不是一份详尽的清单,只是我觉得比较有意思的一些点。"第一个、也是他最兴奋的机会叫 "部分自治 app"(partial autonomy apps)。他拿写代码对比好坏做法:笨做法是对着聊天框硬来——"去 ChatGPT 来回复制粘贴代码、bug 报告……你为什么要直接去面对操作系统呢?为此专门做一个 app 显然合理得多"(呼应"用文字聊天 ≈ 透过终端直连操作系统")。他直说:"很多人用 Cursor,我也用……Cursor 就是那种你真正想要的东西,你不会想直接去用 ChatGPT。"关键设计是新旧并存:"有一个传统界面允许人类进去像以前一样手动完成所有工作;除此之外现在还有了 LLM 集成,让我们能以更大的步子(chunk)推进"——人随时可接管手动干。
- 然后他总结出一个好用 LLM 应用通常具备的四个特征("在所有 LLM app 里都通用"):
- ① LLM 在背后大量打理 context(上下文管理)。 "LLM 基本上承担了大量的 context 管理工作"——自动决定该把哪些文件、信息塞进有限的"工作记忆",不用你手动一份份贴。正对症前面的"顺行性遗忘":模型记不住,就让 app 替你把每次该喂的背景准备好。→ 详细
- ② 把好几次模型调用编排起来协作。 "拿 Cursor 来说,底层有给你所有文件做嵌入(embedding,把文件转成数字向量便于检索)的模型、真正聊天的模型、把 diff(改动)应用到代码上的模型,这一切都帮你编排好了。"分工合作,而非一个模型包打天下。→ 详细
- ③ 有专门的 GUI,而且它很重要。 "你并不想直接用纯文本去跟操作系统对话。文本很难读、难解读。所以更好的方式是直接看一个 diff——红色和绿色的改动一目了然,⌘Y 接受、⌘N 拒绝,要轻松得多。"一句点睛:"GUI 让人类能够审查这些会犯错的系统的工作成果,而且能让你跑得更快。"→ 详细
- ④ 有一个"自治滑杆"(autonomy slider),让你自己决定放多少权给 AI(下一节展开)。→ 详细
- 他再用搜索问答产品 Perplexity 印证这四点不是 Cursor 独有、而是好产品通用配方,逐条对上:"它把大量信息打包整合(① context),编排调度多个 LLM(②),有 GUI 让你审查它的部分工作(③)——比如标注来源(cite sources),你可以逐一检查(这正是'人来验证'的抓手);也有 autonomy slider(④):你可以只做一次快速搜索,也可以做 research,或者做 deep research、10 分钟后再回来看结果。"一个搜索产品和一个代码编辑器表面八竿子打不着、骨架却一模一样——这正是他想让产品人记住的"模板"。→ 详细→ 详细
12
什么是"自治滑杆":你来定 AI 放多开
- 他用 Cursor 把"自治滑杆"四档从保守到放手讲死,放权一档比一档大:"只用 tab 补全,这时主要是你在掌控(AI 只顺手补一两句);选中一段代码、按 ⌘K 只改这一段;按 ⌘L 改整个文件;或者按 ⌘I,直接放手让它在整个仓库里随便折腾(let it rip),那就是完全自治的 agent"。四档差别就是"交给 AI 的活儿范围"从一行→一段→一个文件→整个项目逐级放大。核心原则:"根据手头任务的复杂程度,你可以调节自己愿意为这个任务交出多少自治权(tune the amount of autonomy you're willing to give up)"——任务越简单越可控就往放手那头推,越复杂越要紧就收回来、多盯着、小步走。→ 详细
- 然后他把"该不该做部分自治"变成一串可天天自查的问题,几乎是一份产品检查清单:"很多软件都会变成部分自治的……对维护着产品和服务的人来说,你们要怎么把产品做成部分自治?LLM 能不能看到人类能看到的一切?能不能用人类能用的所有方式去行动?人类能不能监督、并一直留在这个活动的回路里?因为这些都是会犯错的系统。"他把难点具象化:"那么在 Photoshop 或类似的东西里,一个 diff 又长什么样?"(图像编辑这种非文本场景,怎么让人快速"看清 AI 改了啥"本身就是待解的设计题。)最后点出更大的工程量:"现在很多传统软件都有这一大堆专为人类设计的开关。所有这些都得改变,得变得对 LLM 也可访问、可使用。"→ 详细
13
关键心法:让"AI 生成 → 人验证"这个循环转得飞快
- 他特意强调一个"关注还不够多"的点——人机协作的本质是一个循环:"我们现在某种程度上在跟 AI 协作,通常它们负责生成(generation),我们人类负责验证(verification)。让这个循环转得越快越好,是符合我们自身利益的。"有"两个主要办法"给它提速。→ 详细
- 第一招:大大加快"验证"那一步。 他给 GUI 一个生理学解释,把人脑也类比成硬件:"GUI 调用的是我们脑子里都有的那块计算机视觉 GPU(computer vision GPU,大脑天生擅长并行处理视觉信息)。读文本是费劲的、也不好玩,但看东西很好玩,它就像一条直通你大脑的高速公路(a highway to your brain)。" 让人逐字读 AI 吐的长文本,走的是大脑里又慢又堵的小路;把同样信息做成图、做成红绿色块,眼睛一扫就进脑子,验证速度差出一个量级。→ 详细
- 第二招:把 AI"拴住"(keep the AI on the leash)、别让它放飞。 他直言很多人兴奋过头:"给我的仓库丢来一个改了一万行代码的 diff,对我并没有用。我还是那个瓶颈——哪怕瞬间生成出来,我还是得确保它没引入 bug、做的事情是对的、没有安全问题。"他坦白真实体感并区分两种场景:"如果我只是在 vibe coding(凭感觉随便写),那一切美好得很;但如果真想干出活来,那就没那么美好了——你身边有个反应过度(overreactive)的 agent 到处瞎折腾,这可不行。" 他自己的做法是小步快跑:"我总是很怕拿到太大的 diff,总是一小步一小步、增量式地推进,围绕一件具体的小事,我想让这个循环转得非常非常快。"→ 详细
- 他还从一篇博客里拎出一个实用的"拴住"技巧,并把因果链讲完整:"如果你的 prompt 很含糊,AI 可能就不会完全照你想要的去做,这种情况下验证就会失败,你就得再去要别的东西。一旦验证失败,你就会开始原地空转(start spinning)。所以更划算的做法是花多一点时间,把 prompt 写得更具体,提高一次验证成功的概率,你就能往前推进了。"——prompt 越具体,一次过概率越高,越不容易陷进"要了又错、错了又要"的死循环。→ 详细
14
把 AI 拴住的实操案例:教育 app 拆成两段
- 他用自己在琢磨的教育方向当案例,先说为什么"直接聊"不行:"在我看来,有很大一部分思考都花在怎么把 AI 拴住上。 我不认为你直接去 chat 里说一句'嘿,教我物理(teach me physics)'就管用——AI 会在林子里迷路(gets lost in the woods)"(没有边界约束、没有既定路线,就会东拉西扯、忽深忽浅、跑偏失焦)。这其实是把"prompt 太含糊就会原地空转"的道理套到了完整产品设计上。→ 详细
- 解法是把"教我物理"拆成两个独立应用,而不是塞进一个万能聊天框:"有一个给老师用的应用负责生成课程;然后另一个应用把课程拿过来提供给学生。" 妙处在于这一拆,中间多出一个可被人先审一遍的产物:"我们现在都有了'课程'这么个中间产物(intermediate artifact),它是可审查的(auditable),可以确保它是好的、一致的(consistent)。而且 AI 是被拴在某一份特定教学大纲(syllabus)上的"。结论:"这就是把 AI 拴住的一种方式,成功的概率要高得多,AI 也不会在林子里迷路。"——把流程切开、在关节处插入一个"人能把关的中间件",AI 后面就只能在确定的轨道上走。中间产物既是给人验证的抓手,也是给 AI 套上的缰绳。→ 详细
15
自动驾驶的前车之鉴:这是"agent 的十年",不是"元年"
- 他亮出最硬资历谈"部分自治":"我在 Tesla 干这个干了大概五年,那也是一个部分自治的产品,有很多相同特性。" 把汽车套进同一框架:"仪表盘上那块就是 Autopilot 的 GUI,会显示出神经网络看到了什么;我们也有 autonomy slider——在我任职的那几年里,我们替用户做了越来越多的自治任务。"(注意是逐年放权、不是一步到位。)→ 详细
- 然后是全场最有说服力的亲历故事,时间线很关键:"我第一次坐自动驾驶汽车是在 2013 年,我有个在 Waymo 工作的朋友带我在 Palo Alto 兜一圈。我用 Google Glass 拍了照片……我们在高速、街道开了大概 30 分钟。这趟车开得堪称完美。零干预(zero interventions),而这是 2013 年——到现在已经 12 年前了。" 当时感受是技术近在眼前:"经历了这趟完美车程,我感觉,哇,自动驾驶马上就要实现了。"→ 详细
- 然而现实给了重锤:"但如今 12 年过去,我们还在攻关驾驶 agent,到现在也还没真正算把这个问题解决掉。" 他还揭了"看起来无人"的真相:"Waymo 的车看起来像无人驾驶,但背后其实还有大量的远程操控(teleoperation)、大量的 human in the loop(人在回路)支撑着。所以我们甚至都还没法宣布成功。"(他补一句:到这阶段它"肯定会成功,只是花了非常长时间"。)这段经历支撑起他最响亮的一句泼冷水:"软件真的很棘手,它棘手的方式跟驾驶很像。所以当我看到'2025 是 agent 元年'这种说法时,我会非常担忧,我倒觉得这是属于 agent 的十年(the decade of agents)。我们需要 human in the loop。"——把"元年(year)"换成"十年(decade)",是他对全行业过度乐观的一次精准纠偏。→ 详细
16
钢铁侠的比喻:现阶段多造"战衣",少造"机器人"
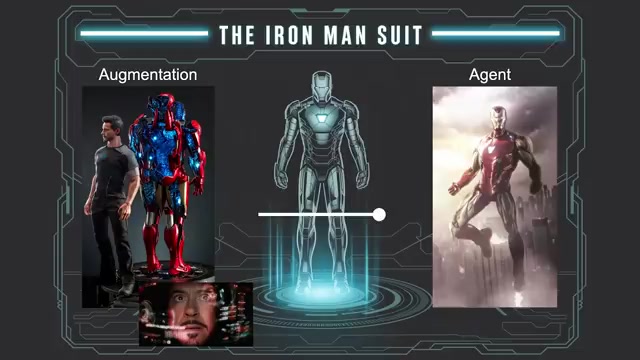
- 亮出比喻前他先郑重定调:"我们得小心地来做这件事。这是软件,咱们认真点儿(Let's be serious here)。"(别被全自动炫酷演示冲昏头,软件出错代价高。)然后端出"一直特别喜欢"的钢铁侠类比,说它"在科技会怎么演变这些方面,在很多点上都'对'得不行"。关键在战衣本身就是两种东西的合体:"它既是一种增强(augmentation)——Tony Stark 可以亲自驾驶它,也是一个 agent。在某些电影里它相当自治,能自己飞来飞去去找到 Tony。"——"增强"(人钻进去亲自开)和"自治"(脱离人自己飞)正是自治滑杆的两端,而"我们多少是两者都想要一点"。
- 落到现阶段该怎么选,他给出那句标志性口号并拆成可操作指引:"你想构建的东西,应该少一点 Iron Man 机器人、多一点 Iron Man 战衣。少去做那些花哨的自治 agent 演示,多去构建部分自治的产品。" 这些产品有定制的 GUI 和 UI/UX,为的是让"生成-验证循环"转得非常快。但他特别叮嘱别因此放弃自动化的长期目标:"但我们同时也没忘记:原则上把这份工作自动化是有可能的。你的产品里应该有一个 autonomy slider,你应该去思考:要怎么拨动它、让你的产品随着时间推移变得越来越自治。"——先做战衣,但要在产品里给"将来变机器人"预留好那根滑杆。→ 详细→ 详细
17
机会二:用英语就能编程 → 人人都成了程序员
- 第二个"非常独特的维度",他态度是"极度看涨(extremely bullish)、完全前所未有":"这是一种用英语来编程的、自然的接口,于是突然之间人人都成了程序员,因为人人都会说英语这样的自然语言。" 门槛被砸到多低:"以前你得花五到十年钻研某样东西,才能在软件领域做出点什么。现在不再是这样了。"→ 详细
- 他讲了 vibe coding(凭感觉编程) 这个词的由来,还自嘲:"就是这条推文最早把它引出来的,现在已经变成一个大热梗了。我在 Twitter 上混了大概 15 年,到现在还是完全摸不准哪条推文会爆……我本以为它会石沉大海,结果它彻底变成了一个梗。"解释:"它大概戳中了某根弦,给一种大家都隐约感觉到、却说不上来的东西起了个名字。现在它都有维基百科词条了。"→ 详细
- 他借一段视频表达对下一代的乐观,情绪相当外露:"HuggingFace 的 Tom Wolf 分享了这段我特别喜欢的视频,里面是一群小孩在 vibe coding。我太爱这个视频了——你怎么可能看着它还对未来感到悲观?未来一片光明。" 他还把这个比喻往长远说:"我觉得这最后会成为通向软件开发的'入门毒品'(gateway drug)"(小孩从 vibe coding 玩起,玩着玩着就被领进真正的软件开发大门),并表态"我对这一代人的未来不悲观(not a doomer)"。→ 详细
- 他也现身说法玩了两把。第一把 iOS app:"vibe coding 在你想做一个超级定制、市面上又不存在的东西时特别棒……我做了一个 iOS app,我其实根本不会写 Swift(苹果的编程语言),但居然能做出一个超基础的 app……这就花了我一天时间,当天晚些时候它就跑在我手机上了。我不用先啃五天 Swift 才能上手。" 第二把是 MenuGen:"它现在上线了,你可以在 menu.app 上试。我基本上是有这么个问题:到一家餐厅看着菜单,完全不知道上面那些东西是什么,我需要图片,但这种东西不存在。所以我 vibe code 了一个——打开 menu.app,拍一张菜单照片,MenuGen 就会生成那些图片。" 商业上它反倒成了笑话:"每个人注册时还免费送 5 美元额度,因此这成了我生活里的一个大成本中心。这对我来说是个负收益(negative revenue)的 app,我在 menu 上亏了一大笔钱。"→ 详细
18
MenuGen 的教训:让 AI 写代码容易,"变成真产品"才难
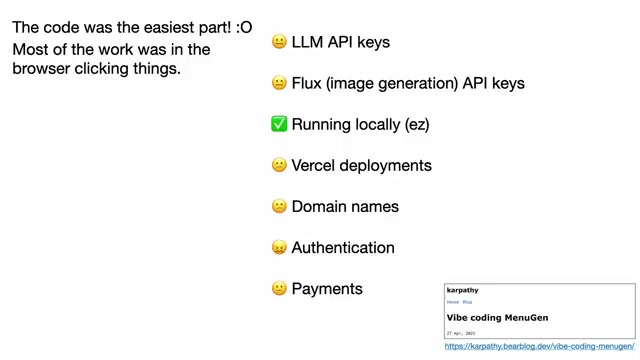
- MenuGen 最让他"着迷"的,是它暴露了一个反直觉真相——写代码反而是最容易的那部分(和大众对"AI 写代码"的想象正好相反):"vibe coding 那部分的代码其实是最简单的,大部分工作是在我试图把它变成真东西的时候——让它真的能有身份认证(authentication)、支付(payments)、域名(domain name)、还有 Vercel 部署。这部分真的特别难,而且这些全都不是写代码(all of this was not code)。所有这些 devops 的活儿都是我在浏览器里点来点去,极其极其慢,又多花了我一周。" 时间对比讲得很扎心:"我几个小时就在笔记本上把 MenuGen 的 demo 跑通了,然后又花了我一周,因为我想把它变成真东西,而原因就是这事儿实在太烦人了(really annoying)。"(devops 泛指部署、配置、运维这类把软件真正跑起来、上线、能收钱的工程杂活。)→ 详细
- 他举了最让他抓狂的具体场景——给网页加"用 Google 账号登录":"就是这个 Clerk 库(一个做登录认证的第三方服务)给我一大堆操作说明:去这个 URL、点这个下拉菜单、选这个、再去那个、点那个。它就这么一步步告诉我该干什么。"荒诞点在于:这些步骤本是机器最擅长的重复操作,却要一个人类照着清单手动一条条执行。他的吐槽几乎脱口而出,也正是引出第三个机会的钩子:"一台计算机在告诉我该做哪些操作。你自己做啊,凭什么是我来做?搞什么鬼(What the hell)?这太疯狂了。"→ 详细
19
机会三:直接"为 agent"来改造你的网站和文档
- 接着上面那段吐槽,他几乎赌气式地抛出第三个机会:"我们能不能干脆为 agent 而构建(build for agents)?我不想干这种活,agent 能不能来干?" 他随即定义了一类全新的"数字信息使用者"诞生了,这是理解整个机会的关键:"过去要么是通过 GUI 的人类,要么是通过 API 的计算机(人靠点界面,程序靠调接口)。而现在我们有了一个全新的东西——agent,它们是计算机,但又有点像人,是'人的精灵'(people spirits);互联网上出现了一群人的精灵,需要跟我们的软件基础设施打交道。我们能不能为它们而构建?"——它正好卡在"用图形界面的人"和"用 API 的程序"中间:既能像人一样读网页看文档,又能像程序一样批量自动地操作。专门"为它"设计产品,就成了一片全新的空白市场。→ 详细
- 他给了一串很具体的做法,逐条都讲了为什么:
- ① 放一个 llms.txt。 类比老约定 robots.txt(指示爬虫怎么在你网站上行事)。"它就是一个简单的 markdown,告诉 LLM 这个域名是关于什么的,对 LLM 来说非常好读。"反面是:"要是它只能去抓你网页的 HTML 然后试图解析,那非常容易出错、根本行不通。所以我们干脆直接对 LLM 说话。"→ 详细
- ② 把给人看的文档转成对 LLM 友好的 markdown。 "海量文档写给人看(列表、加粗、图片),LLM 没法直接获取。Vercel 和 Stripe 就是这方面的早期行动者(early movers),用 markdown 提供文档。markdown 对 LLM 超级好理解。"他插了个亲历例子证明这有多管用:"3Blue1Brown 写了一个叫 Manim 的库(用代码生成数学动画)……我不想通读它的详尽文档,就把整份文档复制粘贴给一个 LLM,描述了我想要什么,然后它就开箱即用地成了(worked out of the box)——直接给我 vibe code 出了一段动画,正是我想要的。" 引申出一句预判:"如果我们能让文档对 LLM 可读,那将释放出海量的用途。"(一份本要人花半天啃的文档,喂给 LLM 几秒钟就转化成能跑的代码。)→ 详细
- ③ 不只是换格式,还要改文档内容本身。 "这不只是变成 markdown 那么简单——那是最容易的部分。我们其实得去改文档本身,因为只要你的文档里写'点击',那就不行——LLM 现在还没法原生地执行这个动作。所以比如 Vercel 就在把每一处'点击'替换成一条等效的 curl 命令(一行就能让程序自动发起网络请求/执行操作),让你的 LLM agent 能替你执行。"→ 详细
- ④ 用 MCP 协议直接跟 agent 对话。 "来自 Anthropic 的 model context protocol(MCP,模型上下文协议)是一种直接跟 agent——这类新的数字信息消费者和操纵者——对话的协议。"前三招是把"给人看的东西"翻译得让 agent 能读,MCP 更进一步:直接定义一套 agent 听得懂的接口语言。态度很明确:"我对这些想法非常看好(very bullish)。"→ 详细
- 他还"特别喜欢"一类"把数据喂顺"的小工具,共性是改一下网址就能让数据对 LLM 可读:gitingest——"把 GitHub 仓库 URL 里的 GitHub 改成 gitingest,它就把所有文件拼接成一个巨大的文本、还生成目录结构,可直接复制粘贴进你喜欢的 LLM"(他拿自己的 nanoGPT 仓库举例);DeepWiki(Devin 团队做的)——"更夸张,它让 Devin 对这个 GitHub 仓库做分析,为你的仓库搭起一整套文档页面"。"我爱所有这些小工具,基本上就是你改一下 URL,它就把某个东西变得对 LLM 可访问。"他还公允补了"那 agent 不是自己会点吗"的反驳与权衡:"完全有可能今天 LLM 就能到处跑、点击东西,但我仍觉得很值得跟 LLM 各走一半路、迎上去(meeting LLMs halfway),因为那么用目前还相当贵、也困难得多。" 他预判"会有很大一批长尾软件不会去适配,那时候就需要这些工具",结论是"所以我对两边都看好"。→ 详细→ 详细→ 详细
20
收尾:这是把滑杆"从左推到右"的十年
- 全场总结,他把几条主线拢成一段:"这是个多么了不起的入行时代啊。我们需要重写一大堆代码……这些 LLM 有点像公共事业设施(utilities),有点像晶圆厂(fabs),但它们尤其像操作系统(especially like operating systems)。可现在还太早了,就像操作系统的 1960 年代。"——他特意用"尤其"再次把"操作系统"从三个类比里拎出来强调,这是他给"LLM 到底是什么"下的最终定性。再次呼应前半场的"心理学":"这些 LLM 有点像会犯错的(fallible)'人的精灵',我们得学着跟它们协作。而要把这事儿做好,我们需要调整我们的基础设施来适应它们(adjust our infrastructure towards it)"——这一句正好把第二、第三个机会(部分自治 app、为 agent 改造基础设施)都收了进来。→ 详细
- 行动指南也是三条主线的回收:做"部分自治"产品、把"生成-验证"循环做到飞快、"还有很多代码也得更直接地为 agent 来写"。最后回到钢铁侠战衣,把整场钉进一个十年尺度、方向明确的画面里——这也是为什么标题用"十年"而非"元年":"在接下来大约十年里我们会看到的,是我们把那个滑杆从左往右推(take the slider from left to right)。" 今天先造"战衣"(人主导、AI 增强),随着模型一年年变强,再把自治权一点点交出去,慢慢逼近"机器人"那一端。结束语带着他一贯的乐观和号召:"看看那会是什么样子会非常有意思。我已经迫不及待要和你们所有人一起去构建它了(I can't wait to build it with all of you)。谢谢。"→ 详细
21
金句
- "It's amazing we can program computers in English now."(太了不起了,我们现在能用英语给计算机编程)—— Karpathy 置顶推文 → 详细
- "Software 2.0 quite literally ate through the software stack of the autopilot."(Software 2.0 这套栈,可以说是真真切切地把 Autopilot 的整个软件栈"吃"掉了)→ 详细
- LLM 像 "people spirits, stochastic simulations of humans"(人的精魂,对人类的随机仿真)。→ 详细
- "When the state-of-the-art LLMs go down, it's actually kind of like an intelligence brownout in the world."(当最先进的 LLM 宕机,那就像是全世界经历了一次"智能限电")→ 详细
- "A GUI utilizes your computer vision GPU... looking at stuff is fun and it's just a kind of like a highway to your brain."(GUI 调用的是我们脑子里那块视觉 GPU……看东西很好玩,就像一条直通大脑的高速公路)→ 详细
- "It's not the year of agents, it's the decade of agents."(这不是 agent 的元年,是 agent 的十年)→ 详细
- "We need humans in the loop."(我们需要人在回路)→ 详细
- "Build Iron Man suits, not Iron Man robots."(多造钢铁侠战衣,少造钢铁侠机器人)→ 详细
- "A computer is telling me the actions I should be taking. Like you do it. Why am I doing this?"(一台计算机在告诉我该做哪些操作。你自己做啊,凭什么是我来做?)→ 详细
- "I can't wait to build it with all of you."(我已经迫不及待要和你们一起去把它造出来了)→ 详细
22
提到的概念 / 工具清单
- 三种范式:Software 1.0(人写代码)/ 2.0(训练出的权重)/ 3.0(英语 prompt)、prompt 即程序、few-shot prompt、情感分类示例、vibe coding(凭感觉编程)
- 核心比喻:AI 是新电力、公用事业 / 芯片厂(fab) / 操作系统、capex vs opex、转换开关(transfer switch)、分时复用(time sharing)、瘦客户端(thin client)、batch、智能限电(intelligence brownout)、4 纳米制程、fabless vs Intel/自有 fab、CPU≈LLM 与内存≈context window、人的精魂(people spirits)、自回归 transformer、雨人式记忆、顺行性遗忘、锯齿状智能(jagged intelligence)、9.11>9.9 / strawberry 两个 R、prompt injection、钢铁侠战衣 vs 机器人、自治滑杆(autonomy slider)、生成-验证循环、把 AI 拴住(on the leash)、视觉 GPU、在林子里迷路、中间产物(artifact)
- 产品 / 工具:map of GitHub、Hugging Face、model atlas、flux、AlexNet、OpenRouter、Cursor(tab / ⌘K / ⌘L / ⌘I)、Perplexity(快速搜索 / research / deep research)、ChatGPT、Mac mini(batch-1 推理、内存带宽受限)、MenuGen(menu.app)、Clerk、Vercel、Stripe、llms.txt、robots.txt、curl、MCP(Anthropic)、gitingest、nanoGPT、DeepWiki(Devin)、Manim(3Blue1Brown)、Google Glass、Waymo、Tesla Autopilot、TPU、Nvidia GPU
- 影视引用:《雨人》Rain Man(Dustin Hoffman / 自闭症天才)、《记忆碎片》Memento、《初恋50次》50 First Dates
- 人物:Andrej Karpathy、Andrew Ng(吴恩达,"AI 是新电力")、Tom Wolf(HuggingFace)、3Blue1Brown、Tony Stark(钢铁侠)