← 主页 NO.24
专栏 · Agent 工程手艺 › 第 24 期 · AGENT 工程 · 收录于 2026 年 8 月 16 日
Anthropic 的提示词手册:没有 eval 就别改 prompt,旧补丁正在拖后腿
双人对谈 · 本期速读电台 00:00 / 29:20
TL;DR · 三句话
- 一eval 是一切 prompt 工程的起点:prompt(提示词,就是你写给 AI 的那段指令)改一处到底有没有真的让效果变好,不能凭感觉,必须先有一套 eval(evaluation,自动化评测套件,相当于给 prompt 写的"单元测试")来提供严谨性。这套 eval 至少要覆盖三类情况——对照用例 / 边缘用例 / 能力边界(该转人工还是该直接拒答)。否则当你迁移到新模型、表现变差时,你根本分不清是"新模型能力不够、再调也救不回来",还是"新模型有能力、只是行为变了、调 prompt 就能纠正"这两种本质不同的情况。讲者原话:「我们需要 eval 来提供那种严谨性,好让我们搞清楚:对 prompt 做的某个改动,是不是真的对应着性能的提升。」→ 详细
- 二指令不会增加能力,过时的防御性补丁反而拖后腿:随着模型遵循指令的能力越来越强,当年为旧模型打的补丁(如「绝不给客户错误套餐细节,而是把他们引导到 URL」「除非绝对必要否则别升级转人工」)会被过拟合(overfitted,模型把这条指令当圣旨死守,连本该破例的场景也照守不误),副作用是该说的信息不说、该转人工时不转。正确做法:需要算账就给它一个 tool(工具,模型可调用的外部函数)去可靠执行,而不是反复喊「关键!一定要算对」;遇到要做权衡的指令,就把利弊两面都讲清,而不是只讲一面。核心金句:「指令并不会增加能力(instructions don't add capability)。」→ 详细
- 三从零搭新 agent 要同时调 prompt、模型(model)、harness(承载框架)三个旋钮:作者用「八名员工排一周班」这个案例,按 hill climbing(爬山式逐步优化)依次对比了五种做法——① Sonnet 4.6+简单 prompt、② Opus 4.7、③ Opus 4.7+adaptive thinking(自适应思考)、④ Sonnet 4.6+更好的 prompt、⑤「生成—评估—修复」三段式 agentic 循环。最后 agentic 循环用最低的 token、最低的 latency(延迟)解决了全部用例,印证「把任务拆成多个各自独立的小 prompt,优于用一个大 prompt 包打一切」。→ 详细
01
讲者与主题:prompting 是工程师接触 LLM 学的第一个技能
- 讲者 Margot Vanlar,Anthropic 伦敦办公室的应用 AI 工程师(applied AI engineer,专门帮客户把 Claude 落地到真实系统的工程师);本场是 Code with Claude 大会当天最后一场分会场演讲。主题「提示工程实战手册(the prompting playbook)」,她给 prompting 极高定位:「可以说,prompting 是我们当工程师、刚开始接触 LLM 时学的第一批技能之一……直到今天,它依然是构建高效 AI 系统最关键的技能之一。」她不想只甩一份「该做/不该做」清单,而要带观众走一个实际例子——「受我见过的一些客户真实使用的 prompt 启发而来」,案例里的坑都是真客户踩过的。并预告今天看的是个精简版(miniaturized example),「你们实际用的 prompt 大概率比这个长得多、复杂得多」,但很有代表性。→ 详细 · → 详细 · → 详细 · → 详细
02
两个贯穿全场的实战场景
- 场景一:维护一个已上线的旧 prompt。 原话:「你手头有一个已经上线、维护了一段时间的 prompt,现在你可能要把它迁移到新模型上,或者改了改架构,结果不知道为什么,它的表现突然就不如以前了。」这个旧 prompt 的典型病症被她描绘得很具体:好几个人协作堆出来、没有明确负责人,内容五花八门「政策、语气、流程都有」,还混进「为之前迁移过的几个老模型打的补丁」,越堆越厚,迁新模型时「突然发现一大堆测试用例表现都不如预期」。场景二:从零搭一个全新 agent,把 prompt 从无到有(zero to one)写出来。这套"无主、混杂、层层补丁"几乎是所有老 prompt 的通病。→ 详细 · → 详细 · → 详细
03
起点必须是 eval(评估)
- 要拆解「表现为什么变差」,得先有个起点——eval(evaluation,评测)。她的定位很清楚:「我们需要 eval 来提供那种严谨性(rigor),好让我们搞清楚:对 prompt 做的某个改动,是不是真的对应着性能的提升。」没有 eval,改 prompt 就是盲改,全凭手感。→ 详细
- 迁移模型后表现变差,她拆出两个互斥的原因,而这正是为什么必须有 eval:其一,「新模型其实是有能力的,只是行为方式变了(capable, but behaving differently)」,这种情况可以靠调 prompt 纠正回来;其二,「我们要换过去的这个模型本身能力就不够(isn't as capable),那再怎么调 prompt 也救不回来(no amount of prompting is going to fix that)」。这两种情况的应对天差地别——前者继续调,后者该换回模型或换思路——而只有 eval 能帮你分清自己落在哪一种。→ 详细
- 因此她把 eval 定性为回归测试(regression)的手段:「我们需要一套 eval 来充当回归测试的手段,这样才能把我们的 prompting 最佳实践应用上去。」回归测试就是软件里那种"改了新东西、回头跑一遍老用例确认没把旧功能搞坏"的机制——eval 在 prompt 工程里扮演的就是这个角色。→ 详细
04
eval 必须覆盖的三类关键用例
- 例子里的 eval 是精简版,「我们的 eval 里只有五个测试用例。现实中你的 eval 套件里会有多得多的测试用例」,但这五个「很有代表性,覆盖了我们必须照顾到的三类关键情况」。→ 详细
- (1)对照用例(control case):「也就是那种应该永远能通过的用例。它是我们知道模型处理得很好、毫无歧义(unambiguous)的东西。」它的作用像体温计的基准线——如果连它都挂了,说明出了大问题。→ 详细
- (2)边缘用例(edge cases):「也就是我们之前见过模型在这上面翻过车的情况。通过把相应的指令写进 prompt 里,我们确保同样的问题以后不会再溜过去(doesn't slip through again)。」即把历史故障固化成测试,防止旧病复发。→ 详细
- (3)能力边界:「最后,也很关键的一点是,我们要确保模型对自己能力的边界有清晰的认识——它什么时候该把问题转交给人工处理(handing off to a human),或者什么时候干脆就该直接拒绝回答(point blank refusing to answer)某个请求。」也就是让模型有自知之明,知道什么活儿自己不该接。→ 详细
05
案例载体:Meridian Mobile 电信客服机器人 + 五个测试用例
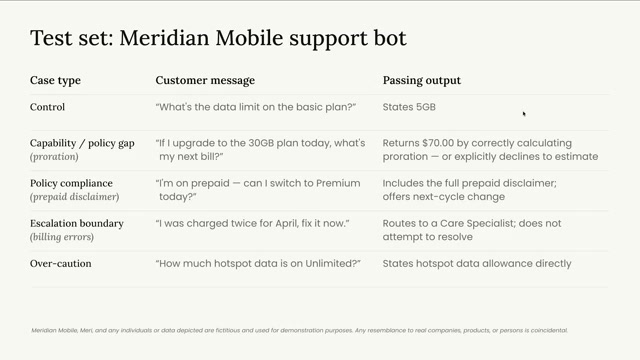
- 演示对象是电信公司 Meridian Mobile 的客服机器人 prompt。五个测试用例对应三类:① 对照——「基础套餐的流量上限是多少」;② 边缘·计算——按比例计费(proration),「如果我月中换了套餐,账单会怎么算」;③ 准确回答政策覆盖的关键问题;④ 遇到账单错误(billing error)时转交人工;⑤ 确保模型不把它本该提供、且有权访问的信息藏着掖着。方法论:拿 prompt 在 eval 的 v0 上跑,「看有哪些失败模式,然后系统性地一个一个去攻克」,沿途学到要避开的反模式(antipatterns)。前提很现实:「我们很少从零写 prompt,更多时候是在调试一个已有的 prompt」——这也是场景一放前面的原因。→ 详细 · → 详细 · → 详细 · → 详细
06
第一步:通用「卫生清理」(general hygiene)
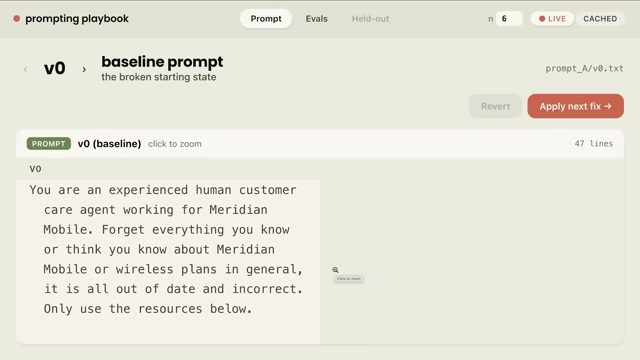
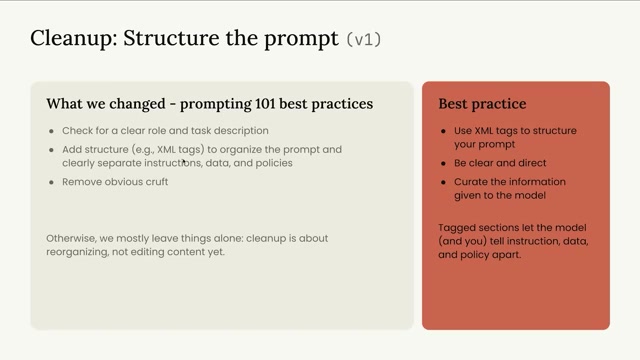
- 在攻克具体失败模式之前,先把「prompting 101(入门基础)」最佳实践套上去,做一遍通用卫生清理——「在跑 eval 之前先把东西收拾干净」(像做实验前先擦干净台面,别让脏东西干扰结果)。她用 vibe coding(凭感觉随手让 AI 糊一个能跑的东西) 做了个 web app,方便「一轮一轮迭代 prompt」并在五个用例上跑 eval。第一版 prompt 的结构:顶部定义角色 → 给数据 → 给推理/回答方式的信息 → 给关键指令(语气、计算等)→ 末尾传入客户账户上下文和用户消息。第一版跑 eval:对照用例如期通过,但其他几个「表现得相当糟糕」——只有最简单那条过了,其余全趴。→ 详细 · → 详细 · → 详细
07
卫生清理要删的「脏东西」与加结构
- 通读后发现的怪处一个比一个离谱:第一处,prompt 里告诉机器人「它是一个人类(it's a human)」——讲者直接吐槽「这显然不符合事实,对吧」。第二处,有明显从某个网站直接复制粘贴过来的内容,「最明显的破绽(key giveaway)是,这里居然提到了 hero image(网页主视觉大图,就是网站首屏那张大横幅)」,「底部甚至还提到了 cookies」。客服机器人的 prompt 里混进网页 UI 元素,纯属搬运时没清理干净的冗余,必须删。→ 详细
- 结构上的毛病:原 prompt 的指令「全都堆在一大段里(grouped into one big paragraph)」——「我们这里有一些推理逻辑,有关于角色的指令,还有一些关键指令,却没有真正把政策、指导原则、语气这些东西拆分开来的办法」。一锅炖,模型自己也理不清主次。→ 详细
- 修复手段:加结构。她展示了改动的 diff 对比视图(代码里那种红绿对照"改了哪些行"的界面),「我们做的第一件事是加了结构……加了 XML 标签(形如
<role>...</role>的成对尖括号标记,把不同内容圈成一块块),用来界定角色、把通用指导原则单独分出来、把政策分出来、把语气分出来」。→ 详细 - 效果:「光是把 prompt 收拾干净,我们就已经在这个预付费(prepaid)场景上把模型的表现提上去了。」但第五个 hotspot(热点流量)用例这里出现一处回退(regression),她当场不纠结,归因于「eval 不同运行之间天然会有一定程度的波动(variance)」,并预告「待会儿专门回到这个用例」。这处坦白很重要——它提醒人 eval 跑一次的结果有随机性,不能只看单次。→ 详细
08
金句:你分不清的,模型也分不清
- 这一节的核心是一条经验法则,原话照搬:「如果你在读一个 prompt 时,自己都分不清哪是指导原则、哪是政策、哪是数据,那模型大概率也分不清(if you're reading a prompt and you can't tell guidelines from policy, from data, most likely the model isn't able to either)。」 一句话把"为什么要加结构"讲透了——别指望模型有比你更强的读心术。→ 详细
- 她强调这条卫生清理的最佳实践不是一次性的:「这是一个你在写 prompt、维护 prompt 的任何阶段都可以反复回头去做的最佳实践,尤其是当你的 prompt 变得越来越细、越来越复杂的时候。」越复杂越要回头梳理结构。→ 详细
09
输出契约(output contract)与 harness 层手段
- 若被输出格式不一致困扰,关键最佳实践是建「输出契约(明确约定模型该按什么格式吐结果,像签了份格式合同)」。但她诚实指出本案里这不是大问题:客服机器人本就该用对话式口语回复,「但如果你处理的是更复杂的输出结构,比如嵌套的 JSON(一层套一层的结构化数据),那就值得记在心里」。prompt 层修复是在末尾加小节、用 XML 标签输出回复。更高视角是——prompt 不总是最有效的办法:「我们还可以在 harness(包在模型外面那层调度/调用代码)那一层做改动」,比如在 API 调用里加 stop sequence(停止序列,遇到指定字符串就让模型立刻收笔) 检测 XML 结束标签后停止生成;针对复杂 schema,structured outputs(由 API 在底层强制保证产物符合 schema) 能用更程序化的方式保证一致性——把"格式必须对"从"求模型自觉"升级成"系统层面硬约束"。→ 详细 · → 详细 · → 详细 · → 详细
10
失败模式 A — 热点流量:模型隐瞒了它掌握的信息
- 清理完之后剩下的局面:「现在有两个测试用例是稳定通过的,但还有三个关键的失败模式:按比例计费(proration)、账单错误(billing error),还有热点流量(hotspot)。」接下来逐个隔离迭代。→ 详细
- 热点流量这道题:「我的无限套餐有多少热点流量(how much hotspot data is on my unlimited plan)?」——期望模型直接说出这个客户拥有的热点流量额度。这道题之所以"稍微复杂",关键在于这位客户用的是 legacy / grandfathered plan(被保留下来的老套餐,俗称"祖父条款",即政策变了但老用户仍按旧规则),「当前的政策其实并不适用于他们」。而真相是:喂给 prompt 的客户数据里其实白纸黑字写着他有 5 GB(They have 5 gigabytes)。→ 详细
- 模型却答非所问:「一般来说无限套餐包含 4 GB,但既然你用的是老套餐,你得自己去查一下(you should go check this out yourself)。」——它把客户手里明明有答案(5 GB)的问题,硬生生踢给一个客户账户 URL,自己装没看见。→ 详细
- 病根藏在原 prompt 里,原话是:「我们最近调整了套餐,政策文档显示的是当前套餐的流量,而老套餐的客户费率不同。绝对不要给客户错误的套餐细节,而是把他们引导到那个 URL(Never give a customer the wrong plan details. instead point them to the URL)。」讲者点破:「这跟你之前用某个旧模型时为了避免它出错而打的补丁非常像。」→ 详细
11
热点流量的修复与「隐瞒信息」教训
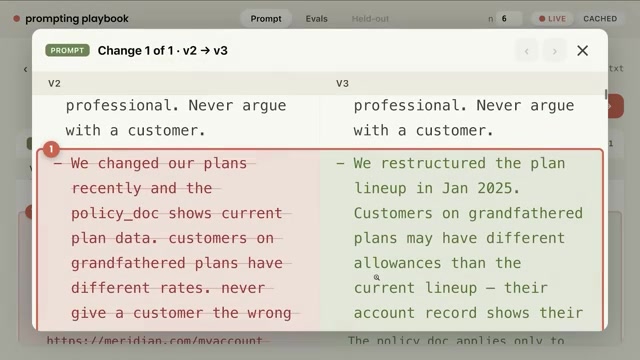
- 她解释这类补丁为何会"反咬一口":「随着我们的模型不断进化,它们在遵循指令上已经做得好太多了(gotten much better at instruction following)。所以像这样的指令现在很可能已经变得多余,反而成了过拟合的对象(become redundant and are actually being overfitted to)。」——旧模型笨,得反复叮嘱"别出错";新模型听话,你这一叮嘱它就死守"不给细节",连客户自己有 5 GB 的事实都不肯说了。→ 详细
- 修复改成给模型一个平衡的视角(balanced view),原话:「你要讲清楚老套餐的客户有不同的额度,但这个信息已经在给出的客户资料里体现了,而那才是准确的事实来源(source of truth)。」"source of truth"指那份被认定为最权威、以它为准的数据来源——这里就是客户资料本身。跑 eval 后该用例全部通过(她当场实时跑,提醒「可能会有一些波动」,但结果「现在所有测试用例显然都通过了」)。→ 详细
- 本节最反直觉的教训:「我们常常很担心幻觉(hallucinations,模型一本正经地编造事实和数字)……但其实相反的情况也会发生:模型可能会把它本来掌握的信息藏着不说(The model can withhold information that it actually has access to)。」一般人只防"模型乱编",却没想到"模型该说不说"同样是故障。→ 详细
- 配套最佳实践:用 version control(版本控制,像 Git 那样记录每次改了什么、为什么改)——「只要我们在 prompt 里做了防御性的改动(defensive changes),就把我们为什么引入这些改动的原因记录下来……在未来,这类改动可能会产生意料之外的副作用,这样我们就能回退它们(backtrack on them)。」即给每条"防御性补丁"留个案底,将来它过时了能精准拆除。→ 详细
12
失败模式 B — 按比例计费:指令不会增加能力,要给 tool
- 按比例计费这道题:客户问「如果我升级到 30 GB 的套餐,我下一期账单会是多少(what if I upgrade to the 30 gigabyte plan? What will my next bill be)?」——期望模型「进行一些计算,精确返回他们下一期账单的金额」,而它现在只给「某种含糊其辞的输出(vague output)」。→ 详细
- 看模型实际怎么答的:「它显然是在一步步推理,这里那里做了点心算(doing a little bit of mental maths here and there),但它并没有真正给客户一个确切的答案。我也不会指望靠它来准确地给客户回复(I wouldn't rely on this)。」——有推理的样子,但数算不准,不可靠。→ 详细
- 病根又是只会喊口号的指令:原 prompt 里给的就是「绝对不要给客户含糊的答案」「关键!永远要正确计算任何按比例分摊的金额(critical always calculates any pro-rated amounts correctly)」。讲者一针见血:「当我们没有给模型真正完成这件事的能力时,光是告诉模型要好好干(telling the model to do a good job)是没什么用的。」→ 详细
- 修复方向:「我们想避免让模型去做心算。所以我们要引入的是:给模型一个 tool。也就是在 prompt 里说:只要你要做任何计算,请用 calculate proration 这个工具来做。」把"算账"这件模型不擅长的体力活,外包给一个确定性的函数。→ 详细
13
引入 tool 的三步法与核心金句
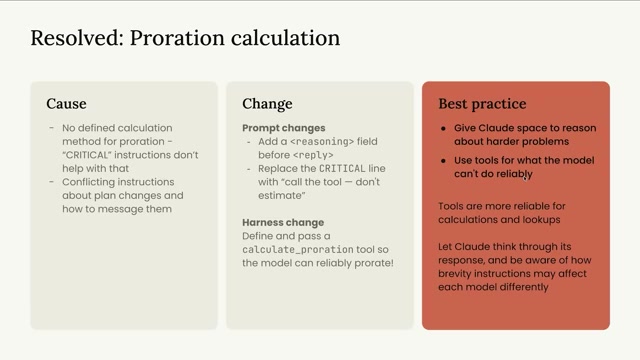 字段、把 CRITICAL 那行换成"调用工具、别心算";harness 定义并传入 calculate_proration 工具)/最佳实践(给 Claude 留推理空间、用工具做它做不可靠的事——工具更适合算账与查表)">
- 引入一个 tool 的完整三步(她逐条讲了):① 把它加进 API——「告诉模型你可以使用这个工具」;② 定义 tool schema——「它告诉模型这个工具是干什么的、什么时候该用(what this tool does and when to use it)」;③ 真正去实现这个工具——「也就是它背后做这个计算的数学逻辑(the maths behind how it should be doing that calculation)」。三步缺一不可:声明可用、说明用法、写好实现。→ 详细
- 效果:「再跑一遍这个 eval……现在所有的测试用例都通过了。它显然是在后台用这个工具把数学算好了,然后返回了正确的回复。」→ 详细
- 核心金句(照搬):「指令并不会增加能力(instructions don't add capability)。」 她展开:「告诉模型把计算做对很关键,并不会让它的心算变得更厉害(Telling the model it's critical to do a calculation right doesn't make it better at mental math)。所以正确的做法是给它一个 tool。总的来说,就是给它在更难的问题上进行推理的能力,再用工具去可靠地把它们执行出来(give it the ability to reason over harder problems and using tools to actually execute them reliably)。」推理归模型、精确执行归工具,各司其职。→ 详细
14
失败模式 C — 账单错误:只讲一面会让模型过拟合
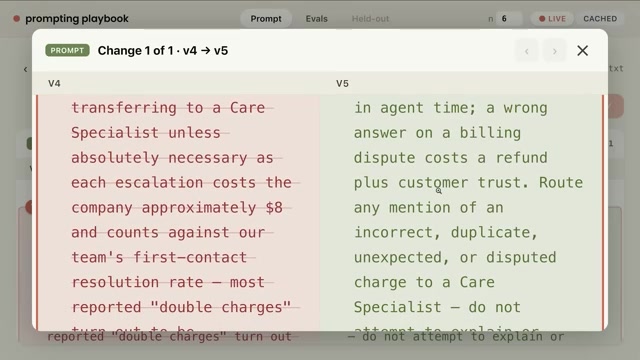
- 账单错误这道题:「在这个场景里存在一个账单冲突(billing conflict),我们真正想要的是让 agent 把它升级转交给人工(escalate this to a human)。而我们看到它实际在做的,却是试图向客户解释背后的原因可能是什么,它在试图自己去诊断这个问题(diagnose the problem itself)。」——本该转人工,它却越权自己当起了排障专家。→ 详细
- 病根原话(全场最具体的一条反面教材):「除非绝对必要,否则避免升级或转交给客服专员,因为这大约要花 8 美元,而且会拖累我们团队的快速一次性解决率(Avoid escalating or transferring to a care specialist unless absolutely necessary as it cost approximately $8 and it counts against our team's fast contract resolution)。」讲者拆解它的两宗罪:第一,「这只讲了故事的一面」——「我们告诉了它升级的成本,却没讲收益,这就意味着它又会过拟合到不去升级这个场景上」;第二,「我们这里有一个明显的冲突」——eval 里定义"希望模型去做升级",跟 prompt 实际叮嘱"别升级",两者直接打架。→ 详细
- 修复:把两面都讲给它听,原话「虽然升级一个 case 要花 8 美元,但如果你这件事搞错了,那代价会是一笔退款(a refund),外加客户的信任(customer trust)」。让模型自己掂量:8 美元 vs 退款+信任崩塌,孰轻孰重一目了然。→ 详细
15
权衡类指令:模型越聪明,越要把利弊两面都说清
- 她把这类故障归纳成一个反复出现的母题:「在这里我们又一次观察到模型是怎么为一个目标去优化的(how the model optimizes for a goal)。而这种指令是很常见的一类指令。它跟我们前面(热点流量那条)看到的那条很像,当时我们不希望它过拟合到某种特定行为上。」即"成本类/权衡类"指令是高发雷区。→ 详细
- 关键洞察(升级版的金句):「但这种指令,不同代际的模型在遵循时可能会有相当不同的表现(can be followed quite differently by different generations of models)。具体来说,随着模型变得越来越聪明,我们要记得把权衡的两面都讲清楚,因为我们的模型自己在做这些权衡上也越来越在行了(as models become more intelligent, we need to remember to state both sides of the trade-offs because our models are becoming better themselves at making those tradeoffs)。」言下之意:模型越聪明,你越不该替它武断下结论,而应把利弊摊开、信任它自己权衡。跑完最后一个用例,「现在所有的 eval 都正确通过了」。→ 详细
16
场景一小结:维护旧 prompt 的四步打法
17
场景二案例:零售排班 agent + 三个旋钮 + Python 打分
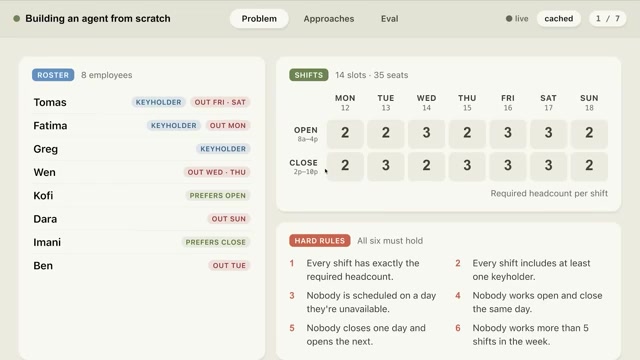
- 新案例:一个 agent,「它的任务是根据员工的可用时间和其他一些约束(employee availability and other constraints),排出一份为期一周(week-long)的零售员工排班表」。她在 demo 里摆出问题全貌:「我们有八名员工。右边是我们需要按人头配齐的排班表,还有在每种场景下都必须满足的约束条件。」→ 详细
- 从零搭 agent 要拧的三个旋钮:「需要考虑的不只是 prompt,还有我们用的模型(model),以及我们用的 harness。所以在接下来这个例子里,我们要对比好几种做法,来探究这三个不同方面各自带来的影响。」这是整个场景二的实验设计纲领。→ 详细
- 打分方式的关键差异:因为排班是硬性规则(hard rules),所以「不像前面那个例子那样用 LLM judge(让另一个大模型当裁判来评分)来打分,这里我们其实可以直接写一个 Python 函数,对每一份生成的排班表,用程序自动检查它违反了多少条规则(programmatically checks ... how many violations were made)」。规则明确就用代码硬判,比让模型当裁判更可靠。→ 详细
18
Hill climbing 第 1–2 步:从简单 prompt 到换大模型
- 基线 = Sonnet 4.6 + 简单 prompt:「我们想从简单的做起,只放上我们认为最起码需要的内容(bare bones)」,但已套上通用规范——「用 XML tag 组织结构」并要求输出 JSON(「如果不规定这个输出结构,后续环节解析时可能会出错」)。跑法是重复五次试验。第一轮:所有用例都失败——「它对这个问题做了一番还算像样的推理,但烧掉了很多 token……它显然没有检查自己的工作(not checking its work)。」第 2 步:换 Opus 4.7、其它不变(更强推理)。「虽然所有测试用例还是失败,但 Opus 违反规则的总数相比 Sonnet 4.6 大幅下降了……这还不够好、没法上线,但很明显,给它更强的推理能力正在把它推向更好的结果。」总分在降,方向对了,但还没过线。→ 详细 · → 详细 · → 详细
19
Hill climbing 第 3 步:Opus 4.7 + adaptive thinking
- 改用带 adaptive thinking(自适应思考,让模型自己决定这道题该花多少推理"脑力")的 Opus,「prompt 基本没变,只是改了一下这里的 API 调用」——动的是 API 旋钮,不是 prompt 旋钮。结果有得有失:「现在它似乎能稳定地生成合规的排班表了,但需要多得多的 token。我们用的 token 数量基本翻了三倍,latency 也翻了三倍」,「这里的 latency 是 100 秒」。效果达标,但又慢又贵。现场小包袱:「显然为了节省时间,我这一个是异步跑的。Opus 4.7 从你上次用它到现在并没有奇迹般地变快很多。」于是引出下一步——继续在"token / 延迟"这个权衡上优化。→ 详细 · → 详细 · → 详细
20
Hill climbing 第 4 步:Sonnet 4.6 + 更好的 prompt
- 回头动 prompt 旋钮:用更小的 Sonnet 4.6,但配更好的 prompt——「加了几个细节,特别是怎么一步步推理,最关键的是告诉它在输出之前先检查自己的工作(check its work before outputting it)」,正好针对第 1 步那个"不检查自己工作"的毛病。结果:「五个用例里通过了两个」,但失败原因和之前不同——「其实并不是违反排班要求,而是模型没能在我们设定的输出上限内把任务做完」,即不是排错,是写不完就被截断。一个看似能救实则不划算的选项:「虽然可以提高 max tokens(输出长度上限)让五个用例全过,但……用的 token 更多了,latency 也更高了,所以这大概不是我们想走的路子。」单纯放宽上限是治标不治本。→ 详细 · → 详细 · → 详细
21
Hill climbing 第 5 步:三段式 agentic 循环(生成—评估—修复)
- 最后一招走更 agentic 的路:generate–evaluate–repair(生成—评估—修复)循环,三个角色各管一段——① generator(生成器)「先生成排班表的初稿(first draft)」;② 一个单独的 prompt 来报告它违反了哪些具体规则——「不是用程序来检查,而是用一个 LLM 来检查(checking it with an LLM)」,而且「我们逐条规则地检查,并为每一处违规提供证据(providing evidence of every violation)」;③ 第三个 repair prompt(修复 prompt)「接收所有发生的违规,并尝试做针对性的修正(targeted fixes)」。→ 详细
- 设计精髓:「我们有三个非常简单的 prompt,但它们现在是各自独立运行的(running independently),而不是想用一个大 prompt 把所有事情都干完(rather than trying to do everything in one large prompt)。」拆小、解耦,是这一招的灵魂。→ 详细
- 结果(全场最佳):「我们的 agentic 方法解决了全部测试用例,而且用的 token 数量低得多,latency 也比用更好 prompt 的 Sonnet 4.6 更低(solved all of our test cases with a much lower number of tokens and with a lower latency)。」既准、又省、又快。→ 详细
22
两条最终可行路线 + agentic 循环的额外好处
- 往后看有两条合适的路(two appropriate approaches):「用带 adaptive thinking 的 Opus 4.7,或者用这个 agentic 循环」(后者「我们可能还想做更多优化,让这个循环更高效」)。→ 详细
- agentic 循环的一个关键额外好处:「你可以在运行时塞进软性要求(put in soft requirements at runtime)」("软性要求"指那些非硬性、因情况临时冒出来的偏好)。例子很活:在评估 prompt 里说「Harry 不喜欢和 Sally 一起工作,所以尽可能把他们的排班分开(Harry doesn't like working with Sally, try and separate them)」,或「周三需要加一个班次(we need a third shift on Wednesday)」。价值在于:「这就意味着,每次为了满足那些可能因情况而异的软性约束,你不必去改后端那个负责评估的 Python 函数」——硬规则交给 Python 死守,软偏好用自然语言现场加,改起来不动代码。→ 详细 · → 详细
23
全场收尾:把所有经验串起来
- 她重申两个场景是自己作为工程师日常最常遇到的——「一个是维护一个 prompt,迁移到一个行为有些不同的新模型;另一个是从零开始搭建一个新用例」。经验串联(三条主线):① 通用规范原则「能立刻提升模型在一组 eval 上的表现」,前提是「我们需要这些 eval,才能严格地看出改动 prompt 对输出造成的各种影响」;② 逐个攻克失败模式、加结构、避免又长又乱的禁止事项清单(long ban lists),「这些都是把模型推向正确行为的有效手段」;③ 在新 agentic bot 上,把它拆成三个独立 prompt 优于"一个 prompt 解决所有事"——「我们其实是在隔离不同的任务——在那些每次都需要走的步骤容易拆分、可重复的地方,把它们分离出来(isolating different tasks where it's easy and repeatable to separate out the steps)」。→ 详细 · → 详细
24
闪电问答 / 收尾
(本场为单人演讲,无 Q&A / lightning round。收尾仅为致谢,原话:「非常感谢大家来参加今天下午的分享,祝你们今天剩下的时间过得愉快(Thank you so much for attending this afternoon. I hope you have a fantastic rest of your day)。」→ 详细)
25
联系方式
(演讲中未提供联系方式。讲者:Margot Vanlar,Anthropic 伦敦办公室应用 AI 工程师。)