为什么 LLM 推荐器会是 AI 最大的消费级应用——Devansh Tandon(Meta)
- 一Meta 推荐研究负责人 Devansh Tandon 的第一个论点:推荐系统和 LLM 一样吃 scaling 律,而且还在曲线早段——证据是 Meta 的 HSTU 论文,以及 Meta 财报:简化排序、用更长的互动历史后 Reels 观看时长同比 +30%(2025 Q4),下一季又把训练用的互动序列加长一倍(2026 Q1);背后转着一个「token 进、互动出」的飞轮:训练 → 推理 → 用户互动 → 广告 / 订阅变现 → 替下一轮训练买单。→ 详细
- 二行业在四条 S 曲线上并行攀爬(传统 → 受 LLM 启发 → LLM 原生 → agentic),造 LLM 推荐器的配方就三步:用语义 ID 给内容分词(一条 3 分钟的 Reel 从约 1 万个 token 压到约 10 个)、把 LLM 训成懂「英语 + 内容目录」的双语模型、再把用户信息写进 prompt 直接解码出推荐——模型于是能被读懂推理过程,也能被用户一句话引导(Instagram 的「Your Algorithm」)。→ 详细
- 三用同一个飞轮比较信息流和聊天 App:信息流只需解码指向创作者现成内容的「指针」,每小时互动的推理成本比聊天 App 低多达 100 倍,加上日活前 10 的 App 里有 4 个是信息流,他断言 LLM 推荐会是 AI 最大的消费级应用之一——这是 Meta 一方的立场,倍数怎么算口头没展开,幻灯片旁注只给了粗略依据(一次好推荐带来 1–3 或 10–30 分钟互动,聊天一轮只有 1–2 分钟),拿来做投资判断要打折听。→ 详细
开场:两个大论点,以及讲者站在哪个位置上说话
- 两个论点:这是 AI Engineer 大会「LLM RecSys」(LLM 推荐系统)分会场的第一场,题目叫《Token 进,互动出:训练 LLM 推荐系统》。讲者要立两件事:① 推荐系统和 LLM 一样,能靠扩大规模持续变强,而且这个领域在 scaling 曲线(规模越大效果越好的那条曲线)上还非常早;② LLM 推荐系统会成为 AI 最大的消费级应用之一——演讲标题把「之一」省掉了。→ 详细
- 讲者与利益相关:Devansh Tandon 在 Meta 带 Meta Recommendations Research 团队,训练支撑 Instagram、Facebook 广告和 Meta 全家桶的前沿模型(LLM 和推荐模型都做);此前在 Google 多年,待过 DeepMind、YouTube 等核心 ML 团队。利益相关:这是 Meta 推荐研究负责人在讲 Meta 最擅长的事,「LLM 推荐器会是 AI 最大的消费级应用」属于讲者立场,不是中立结论。→ 详细
- 去年那场的续集:他去年在同一大会讲过《Teaching Gemini to Speak YouTube》,主题是语义 ID 和生成式检索(配两篇论文);一年间这些想法已从研究走进规模化生产,YouTube、Meta、Spotify、DoorDash 都有发布和论文。本场分四段:scaling 曲线 → 四条范式 S 曲线 → 推荐器配方 → 消费级 AI 应用框架。→ 详细
推荐系统和 LLM 一样吃 scaling 律,Meta 财报里已经兑现成观看时长
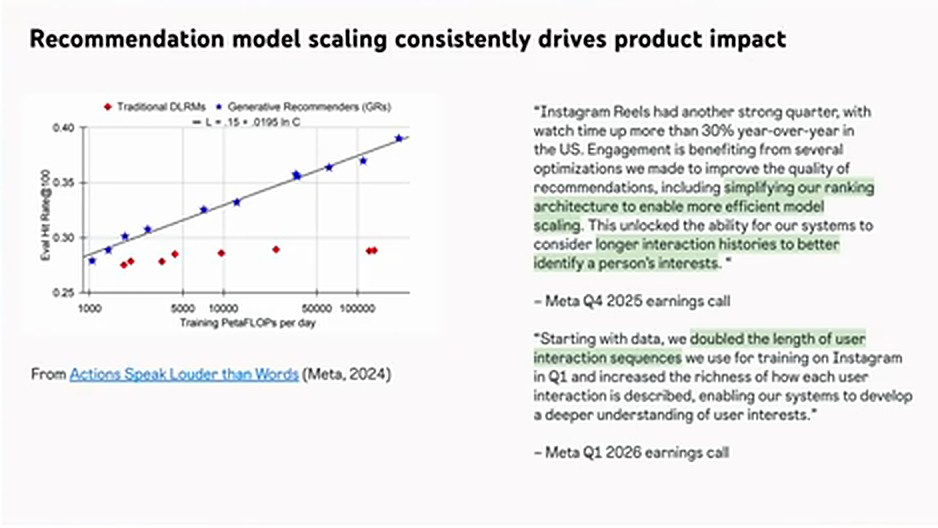 ▲ 图注:幻灯片「Recommendation model scaling consistently drives product impact」。左图出自 Meta 2024 年的论文,生成式推荐(GRs)的 Hit Rate@100 随训练算力沿一条直线从约 0.28 升到约 0.39,传统 DLRM 一直停在 0.28 上下;右侧摘录 Meta Q4 2025 财报电话会(美国 Instagram Reels 观看时长同比增长超 30%,归因于简化排序架构和更长的互动历史)与 Q1 2026 财报电话会(训练 Instagram 用的互动序列长度翻倍)。
- LLM 那条曲线为什么值钱:讲者从 2020 年那篇里程碑式的 scaling law(规模定律)论文讲起——那时 Dario 还在 OpenAI,Anthropic 还没成立。核心是幂律:模型规模、数据量、训练算力(FLOPs)往上加,loss(模型的预测误差)就在对数坐标上稳稳往下走。正因为这条曲线「干净、可预测」,大家能提前算出模型会变多好,于是引爆了前沿竞赛;讲者直说,今天巨额的 capex(资本开支)和 AI 基建大建设,底气也来自这条曲线。→ 详细
- 推荐系统本来就是「大模型」:推荐系统遵循非常相似的 scaling 律。在这波 LLM 之前,RecSys 就是大科技公司里规模最大的生产环境 ML 模型,至今仍是最大的一批之一,服务着十亿以上日活。它的曲线横轴是数据、算力、模型规模,纵轴是推荐质量:离线评估看离线指标(字幕是 net entropy / AU gains,译文推断为归一化熵、AUC 一类),真上线后看的是用户互动和营收。→ 详细
- Meta 自己的证据:2024 年的 HSTU(Meta 提出的生成式推荐模型架构)论文和今年的后续论文都显示,模型、算力、数据一扩,离线推荐质量明显变好。讲者强调这不只是学术研究——他引了 Meta 近期财报:Instagram Reels 这个季度观看时长同比 +30%(幻灯片注明出自 Meta 2025 年 Q4 财报电话会,原文是美国区同比增长 30% 以上),推荐质量上的优化包括两条:简化排序架构,让模型能高效扩展;用更长的互动历史来识别一个人的兴趣。→ 详细
- 「更长的历史」具体是什么:把训练 Instagram 所用的用户互动序列长度翻了一倍(幻灯片注明这句出自 Meta 2026 年 Q1 财报电话会),并让每一次互动带的信息更丰富。讲者的判断是,这些做法和 LLM 的幂律 scaling 曲线「直接对应」——喂更多、更长的数据,推荐就更准。→ 详细
「token 进、互动出」飞轮:推荐模型自己挣下一轮训练的钱
- 飞轮怎么转:训练一个模型 → 在上面跑推理(这就是「token 进」)→ 推荐模型给出更好的内容推荐 → 推高用户互动,也就是日活和使用时长 → 互动转化为变现,也就是广告或订阅收入 → 这笔钱为下一轮模型训练买单。讲者的原话是 "every step on the scaling curve is one loop around this flywheel"(scaling 曲线上每往前一步,就是飞轮转了一圈)。→ 详细
- 为什么说这是生意的心脏:讲者说很多消费级应用的业务核心都在转这个飞轮,所以推荐系统「还有很长的扩展之路要走」。拆开看,它把「训练花的钱」和「广告 / 订阅赚的钱」串成了闭环:只要曲线还在往上走,多投进去的算力就能靠更高的互动和变现自己挣回来——这是讲者解释推荐模型为何还能一直扩下去的框架,也是 Meta 一方看自家持续投入的视角。→ 详细
行业正在爬的四条 S 曲线:传统 → 受 LLM 启发 → LLM 原生 → agentic
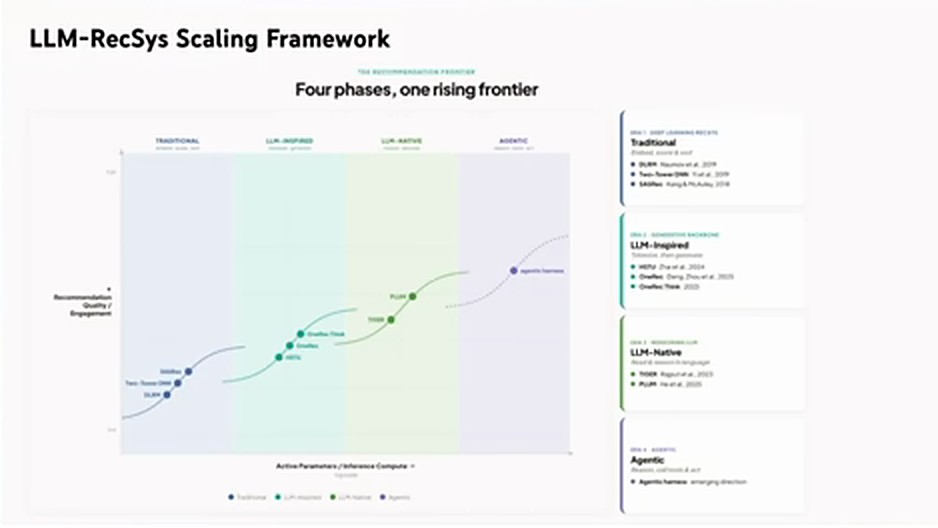 ▲ 图注:幻灯片「LLM-RecSys Scaling Framework」,副标题「Four phases, one rising frontier」。四段首尾相接的 S 曲线依次落在 TRADITIONAL、LLM-INSPIRED、LLM-NATIVE、AGENTIC 四个色带里,纵轴是推荐质量 / 互动、横轴是激活参数 / 推理算力,曲线上标着各阶段代表工作:DLRM、Two-Tower DNN、SASRec → HSTU、OneRec、OneRec-Think → TIGER、PLUM → Agentic harness。
- ① 传统 RecSys:重心在特征工程(人工设计喂给模型的信号)和用户 / 内容 embedding(把用户、内容各压成一串数字向量);大多数生产系统仍在这里,跑双塔、稀疏网络一类排序模型,靠扩大 embedding 模型提效。它不会消失,但开发会被自动化研究(auto research)加速,特征工程会交给 agent 而不是真人 ML 工程师。→ 详细
- ② 受 LLM 启发:借 LLM 的思路、理想情况下端到端地扩展模型,代表是 HSTU 和 OneRec 论文;业界领先的推荐系统如今大多在这一段。→ 详细
- ③ LLM 原生:拿一个本身能理解、能推理的基座模型,适配到推荐任务上,代表是 TIGER 和 PLUM 论文。→ 详细
- ④ agentic(刚冒头):LLM 在循环里编排推荐系统。类比 coding agent:LLM 原生像升级模型本身(如 Opus 4.5 → 4.8,版本号按字幕转写),agentic 像改进 Claude Code、Codex 背后的 harness(包在模型外、让它跑循环调工具的那层软件)。推荐不再是模型跑一次就出结果,而是 agent 规划、检索、排序、评审自己的推荐,再调模型打磨后交付——讲者称之为「很有意思的研究方向」(消费级购物 agent 的循环设计可对照 ep216)。→ 详细
- 全景:各家公司是在四条曲线上并行扩展的;如今大部分推荐系统处在「受 LLM 启发」,正努力迈向 LLM 原生,也还有很多公司在用传统模型、在爬第一条曲线。→ 详细
造 LLM 推荐器的配方:三步走,拆开是一块五层蛋糕
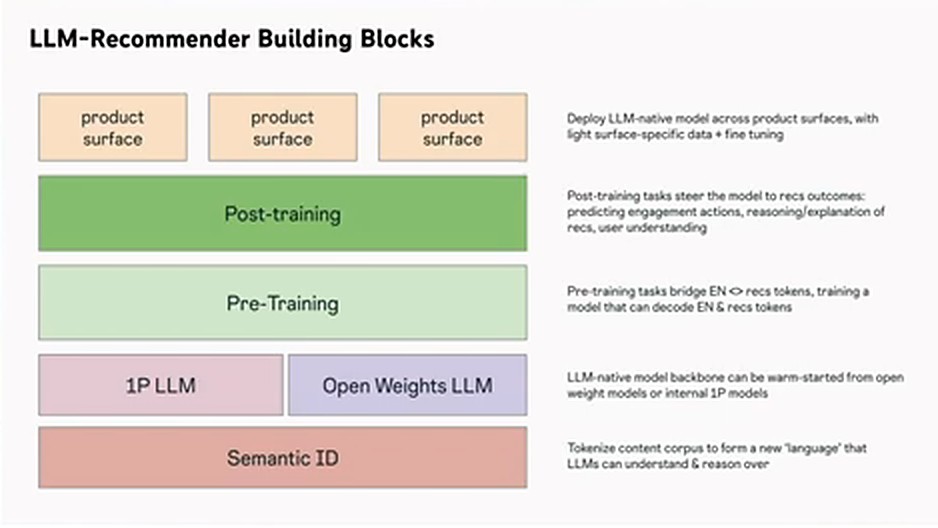 ▲ 图注:幻灯片「LLM-Recommender Building Blocks」,自下而上五层:Semantic ID(把内容库分词成 LLM 能理解、能推理的新「语言」)→ 自研或开放权重的 LLM 底座 → 预训练(打通英文与推荐 token)→ 后训练(引向预测互动、解释推荐、理解用户等推荐目标)→ 用少量场景数据微调后部署到多个产品场景。
- 三步:① 把内容 token 化,给你的领域造一门「语言」;② 适配 LLM,让它既懂英语、也懂这门领域语言,成为双语模型;③ 把用户信息写进 prompt,模型直接从你的内容库里解码出推荐结果。讲者说「其实挺简单」。→ 详细
- 五层蛋糕(自下而上):① semantic ID(语义 ID)——把内容库转成 LLM 能理解、能推理的 token;② 基座 LLM——开放权重模型或公司自研模型都行;③ 预训练——打通英语和推荐 token;④ 后训练——把模型引向推荐任务,比如预测用户互动、对推荐做推理;⑤ 针对具体产品场景做轻量微调,部署上线。→ 详细
- 最划算的地方:大部分算力在所有产品场景之间共享,不必为每个场景从零训练一个单独的模型。→ 详细
第一层 · 语义 ID:一条 3 分钟的 Reel 从约 1 万个 token 压到约 10 个
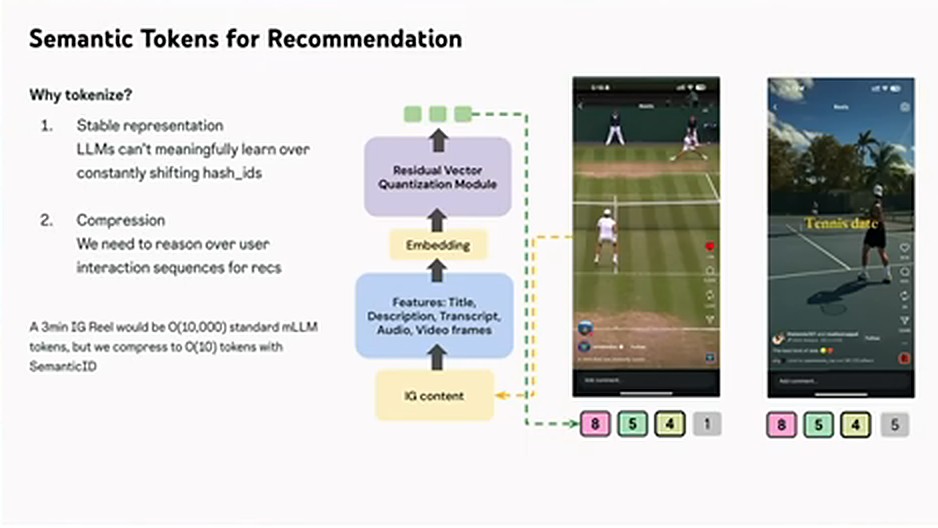 ▲ 图注:幻灯片「Semantic Tokens for Recommendation」。左侧列出分词的两条理由(稳定表示、压缩),写明一条 3 分钟的 IG Reel 约占 O(10,000) 个标准 mLLM token、用语义 ID 可压到 O(10) 个;中间是生成流程:标题、描述、转写、音频、视频帧等特征 → embedding → 残差向量量化模块 → 语义 token;右侧两条网球 Reel 的语义 ID 是 8-5-4-1 和 8-5-4-5,前三位相同,只靠末位区分。
- 普及得惊人:很多团队只是在传统模型里把哈希 ID(随机分配的内容编号,本身不带任何含义)换成语义 ID,就看到了不错的效果。→ 详细
- 为什么要给内容分词,两个理由:一是稳定——给模型一个稳定的表示去学,而不是一个不停变化、模型只能死记硬背的哈希值;二是压缩——模型要在很长的用户互动序列上推理,不压缩的话,一条三分钟的 Instagram Reels 视频就要占约 10,000 个 token,上下文窗口很快塞满,所以得压到大约 10 个 token。→ 详细
- 长什么样:几条讲网球的 Reels,语义 ID 的前三个 token 相同,因为内容很像。可以想象第一个 token 代表「体育」,接下来两个代表「网球」,最后一个把每条视频区分开——像图书馆的分类号,越往后越细,相似的内容自然共享前缀。→ 详细
预训练:让模型在「英语」和「语义 ID」之间变成双语
后训练:LLM 重排序器,能直接读它的思维链看它为什么这么推
新产品形态:用户用一句话「驾驶」自己的信息流
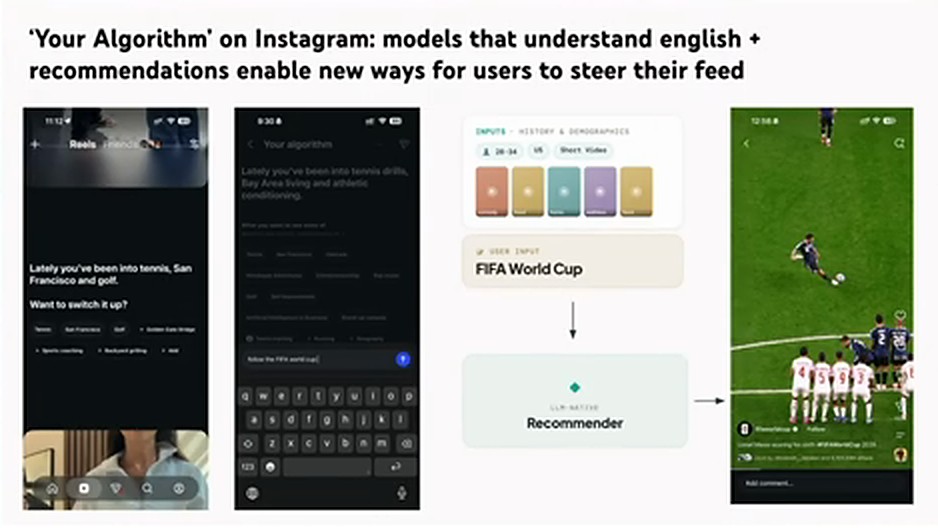 ▲ 图注:幻灯片「'Your Algorithm' on Instagram」。左边两张 Instagram 截图:Reels 里弹出「Lately you've been into tennis, San Francisco and golf. Want to switch it up?」和一排兴趣标签,以及「Your algorithm」页,输入框里正在输入 follow the FIFA world cup;右边示意历史与人口属性加上用户输入「FIFA World Cup」,经 LLM 原生推荐器推出一条足球任意球 Reel。
- Instagram 的「Your Algorithm」:讲者认为,模型一旦同时懂英语和推荐,就能打开新的产品形态,让用户自己引导信息流。例子是 Instagram 的「Your Algorithm」功能:刷 Reels 时点进去,就能看到算法对你和你的兴趣是怎么判断的,还可以增删兴趣、用自然语言跟它对话(Instagram 负责人 Mosseri 从产品侧讲过这个功能的来由,见 ep77)。→ 详细
- 从黑盒到可驾驶:他预言推荐算法会从黑盒走向把控制权更多交还用户、变得可交互、可引导。最让他兴奋的一点,原话是用户可以按 "their own goals that's expressed in language rather than just likes or comments"(用语言表达的自己的目标,而不只是点赞和评论)来引导算法;模型还能开始解释自己的推荐。→ 详细
- 世界杯的例子:讲者给自己加了一条兴趣「这段时间我想关注 FIFA 世界杯」,模型同时拿到他的历史互动和这条新输入,解码出为他定制的推荐,比如 Messi 最近踢进的一个任意球——长期口味(历史)和临时目标(一句话)在同一个模型里合流。→ 详细
- 全行业都在试:Spotify 的 prompted playlists(用一句 prompt 生成歌单)、YouTube 的自定义信息流(custom feeds)、Ask DoorDash;讲者说这类交互式推荐器会是一个很有意思的新产品场景,分会场后面的讲者会细讲。→ 详细
用同一个飞轮看所有消费级 AI:信息流每小时互动的推理成本,比聊天 App 低多达 100 倍
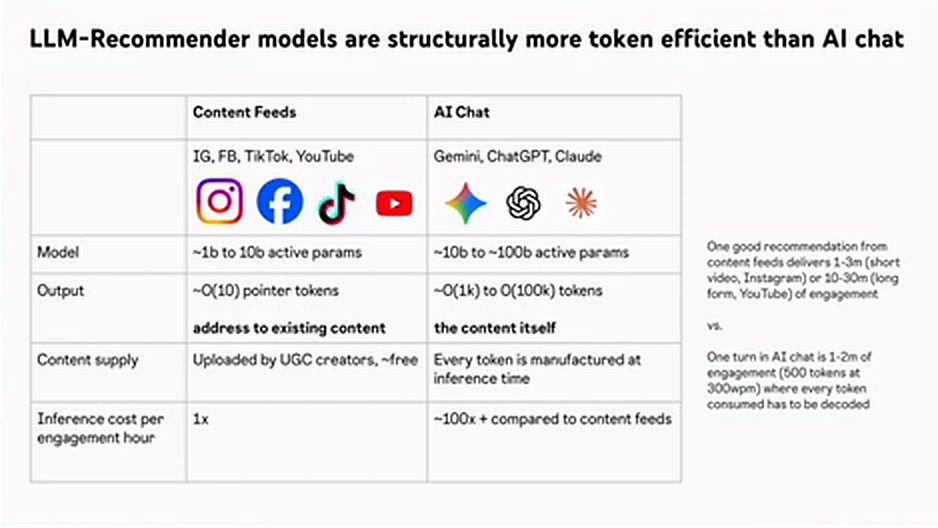 ▲ 图注:幻灯片「LLM-Recommender models are structurally more token efficient than AI chat」对比表,内容信息流(IG、FB、TikTok、YouTube)对 AI 聊天(Gemini、ChatGPT、Claude):模型约 1b–10b 对约 10b–100b 激活参数;输出约 O(10) 个指针 token 对 O(1k)–O(100k) 个内容 token;供给由 UGC 创作者上传、约等于免费,对每个 token 都在推理时现造;每小时互动的推理成本 1x 对约 100x 以上。旁注写着一次好推荐带来 1–3 分钟(短视频)或 10–30 分钟(长视频)的互动,AI 聊天一轮只有 1–2 分钟。
- 一把尺子量所有消费级应用:讲者回到开头的飞轮(训练 → 推理 → 互动 → 变现),说内容信息流和 AI 聊天应用转的其实是同一个飞轮,可以拿它评估任何一款消费级应用。两道关卡:训练 ROI 一侧,看它能多高效地把算力变成前沿模型;推理一侧,看推理花掉的 token 能多高效地变成用户互动、再变成收入。按这把尺子,他的结论是 LLM 推荐系统在结构上比 AI 聊天更省 token。→ 详细
- 模型大小差一个量级:左边是内容信息流(Instagram、Facebook、TikTok、YouTube),目前用的模型约 10 亿到 100 亿激活参数(每次推理实际参与计算的参数量);右边是几大 AI 聊天应用(Gemini、ChatGPT、Claude),跑的是 100 亿到 1000 亿激活参数的模型。→ 详细
- 输出差得更远——指针 vs 现造:信息流的输出只是一个语义 ID token,相当于一个指向现成内容的「指针 / 地址」;内容本身是创作者上传的,创作者经济很健康,所以内容供给「实际上是免费的」。聊天应用则得自己解码每一个内容 token,每轮对话输出几千个 token,而且每个 token 都必须在推理时由应用现场「制造」出来。打个比方:信息流像图书管理员,只需报出书架编号;聊天 App 像当场替你写一本书。→ 详细
- 算到每小时互动上:比较两类应用「产出一小时用户互动要花多少推理成本和算力」,有一个巨大的结构性差距——信息流便宜得多,"up to 100 times or more cheaper"(便宜多达 100 倍甚至更多),原因就是它们 "decoding pointers to content rather than content itself"(解码的是指向内容的指针,而不是内容本身)。读的时候留意两点:他比的是每小时互动的成本,不是每小时能赚多少钱;这个倍数怎么算口头没展开,幻灯片旁注只给了粗略依据(一次好推荐带来 1–3 分钟短视频或 10–30 分钟长视频的互动,聊天一轮只有 1–2 分钟),属于讲者(Meta 一方)的量级判断。→ 详细
收尾:为什么说 LLM 推荐是最重要的消费级 AI 应用之一
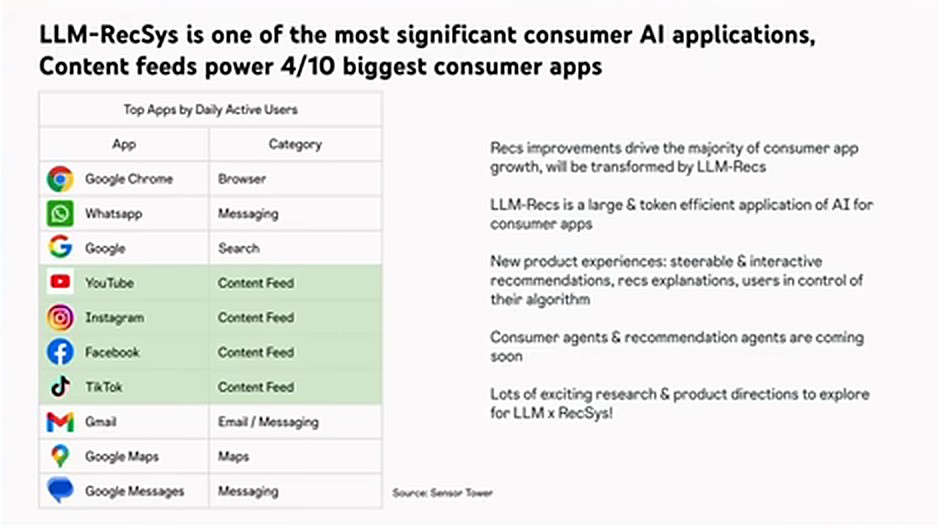 ▲ 图注:幻灯片「LLM-RecSys is one of the most significant consumer AI applications」。左表是按日活排名的头部 App(来源 Sensor Tower),YouTube、Instagram、Facebook、TikTok 四个内容信息流绿底标出,其余是 Chrome、WhatsApp、Google 搜索、Gmail、Google Maps、Google Messages;右侧五条要点:推荐改进驱动大部分消费级应用增长、LLM 推荐是体量大又省 token 的 AI 应用、可引导可交互可解释的新产品体验、消费级 agent 与推荐 agent 即将到来、LLM × RecSys 有大量可探索的方向。
- 盘子有多大:按日活排的前 10 名 App 里,有 4 个是内容信息流;而在信息流应用里,无论是用户互动还是变现,几乎所有增长都由推荐模型和广告模型驱动——讲者断言这两类模型会被 LLM 推荐系统「彻底改造」,称之为 AI 在消费级应用上一个 "very large and very token efficient"(体量极大、token 效率极高)的应用。→ 详细
- 接下来会看到什么:大量新的产品体验——可引导、可交互的推荐,对推荐结果的解释,让用户更多掌控自己在这些 App 上的体验;未来一年左右会出现关于消费级 agent 和推荐 agent 的重要研究。他以此收束:LLM 与推荐的交叉点,无论做研究还是做产品,都是超级令人兴奋的领域。→ 详细
闪电问答 / 收尾
本期是 18 分钟的单人演讲,没有问答环节;讲者讲完即致谢下台,收尾观点已并入主题十一。→ 详细