全书是一条清晰的「从数据出生到送到你眼前」的流水线,每一章拆穿这条流水线上的一个工位如何作弊;最后第 10 章把前九章的防御招式收拢成一套可复用的提问清单。
一句话串起来:样本 → 平均 → 缺失的小数字 → 图 → 相关 → 因果 → 综合操纵 → 反击。前九章是「矛」(行骗术),第十章是「盾」(识破术)。
体例说明:每章给出 ① 该章揭露的骗术 ② 最精彩的真实案例/数字 ③ 论据 ④ 如何识破,并嵌入该章最有教学价值的图。
① 骗术总纲:统计是「事实崇拜文化」里最高级的撒谎方式。它能「煽情、注水、搅浑、过度简化」,而你「钉不到说话人头上」——比希特勒的「弥天大谎」更高明,因为它包着一层客观的外衣。 ② 最精彩的开场案例:作者的岳父从爱荷华搬到加州后说「这地方犯罪可真多」——其实多的只是他订的那份报纸上的犯罪版面。这是一个非正式的统计错误,同时犯了「有偏样本」(只看一份爱犯罪新闻的报纸)和「半相关」(把"报纸犯罪版面"当成"犯罪率")。另一例:一个冬天十几位研究者各自报告抗组胺药「相当比例的感冒在服药后痊愈」,医药热由此而起——可幽默作家 Felsen 早点破:「妥善治疗,感冒七天好;放着不管,感冒一周愈。」 ③ 论据:作者声明书里的案例广泛采自专业统计学家本人的「收藏」(他们比谁都痛恨统计被滥用),并列出六本统计学专著为来源——这给全书的「行骗目录」打了可信度底子。 ④ 如何识破:作者给出本书的精神——「骗子早就会这些招,老实人必须学来自卫」。把每一个数字、平均、趋势、图表都默认当作「可能不是它看起来的样子」。
① 骗术:抽样调查的结论,永远不会比它依据的样本更好。只要样本里系统性地漏掉了某一类人,再大的样本量、再精密的小数点也是「带着伪科学光环的瞎猜」。 ② 最精彩的案例:耶鲁 1924 届校友「年均收入 25,111 美元」(《时代》杂志援引《纽约太阳报》)。这个数字「精确得可疑、健康得离谱」。作者层层剥开:(a) 远方人群的收入不可能精确到个位数;(b) 数字来自校友自报,而人会因虚荣高报、因避税低报;(c) 最大的误差源是抽样——失联的「迷途羔羊」恰恰是那些二十五年后沦为店员、技工、流浪汉、潦倒文人的人(富人在《美国名人录》里很好找),而把问卷扔进废纸篓的,多半也是收入羞于启齿的人。两类「最能拉低平均」的人被系统性漏掉,25,111 这个数字「开始自己解释自己」——真实均值可能只有它的一半。 ③ 论据/数字:邮寄问卷回收率常只有 5%–10%;杂志阅读调查里人人都说自己读《Harper's》没人读《True Story》,但后者发行量是前者的几十倍——「调查唯一查出来的是势利」。1936 年《文学文摘》依据 1,000 万电话簿与订户名单预测兰登 370 票大胜罗斯福,惨败收场——因为 1936 年买得起电话和杂志订阅的人,本身就是偏共和党的特殊人群。 ④ 如何识破:先分清随机样本(universe 中人人机会均等)与分层随机样本(按已知比例分组,而"已知比例"本身可能就错)。记住偏差有「看得见」和「看不见」两种;只要存在偏差的可能就保留怀疑。读到「67% 的美国人反对……」时,追问一句:是哪 67% 的美国人?
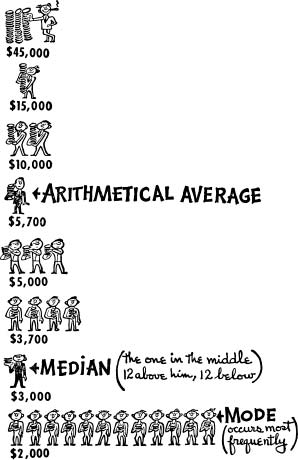
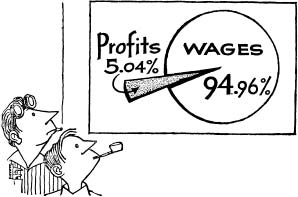
① 骗术:「平均」一词含义极松,至少有三种——均值(mean,全部相加除以个数)、中位数(median,正中间那个,一半人在上一半在下)、众数(mode,出现最多的那个)。在收入这类右偏分布里三者相差极大,于是同一批数据可以挑出最有利的那个「平均」来用。 ② 最精彩的案例:作者扮演房产中介——卖房给你时说「本地年均收入约 1.5 万美元」(用 mean,被三户百万富翁周末客抬高),第二年搞减税请愿又说「本地年均收入只有 3,500 美元」(用 median)。「两个都是合法算出的平均,代表同一批人、同一份收入」——这就是用统计撒谎的妙处:两次你都抓不到他撒谎。引申出那句名言式的结论:「几乎每个人都低于平均(均值)。」 ③ 论据/数字:作者给出一张「谁挣多少」的工资分布图——均值 5,700、中位数 3,000、众数 2,000,老板当然爱用 5,700。又演示了一手「越糟看着越好」的财技:90 个员工 + 3 个老板,先报「员工均薪 2,200/老板均收入 26,000」(难看),再把 3 万利润转成奖金、并把老板自己也算进"工资"取均值,就变成「人均工资 2,806.45/老板均利润 5,000」,利润占比看着不到 6%。对照组是诚实的范例:人口普查局说 1949 年美国家庭收入「中位数」3,100 美元,并主动给出"family"的定义和 ±59 美元、95% 置信的误差——这才是负责任的数字。 ④ 如何识破:看到「平均」先问三连——这是哪种平均?包含了谁?均值和中位数会差很多吗? 当数据接近正态分布(如成年男性身高),三种平均几乎重合,不必深究;当数据明显右偏(如收入),不指明种类的「平均」基本没有意义。
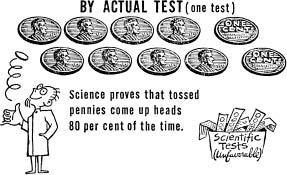
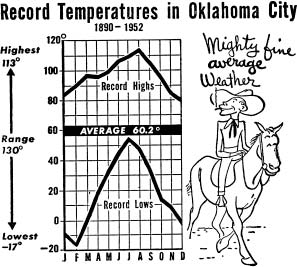
① 骗术:把关键的小数字——样本量、显著性水平、误差范围/离散度——藏起来不说。它们「该在却不在」,而缺席往往不被注意,这正是它得逞的秘诀。 ② 最精彩的案例:「用户报告使用 Doakes 牙膏后蛀牙少 23%」,由「独立实验室」检测、注册会计师背书。小字里藏着:测试组只有 12 个人。作者点破操作手法:让一小撮人记半年蛀牙数,再换 Doakes——结果无非"明显更多/明显更少/差不多"三种,公司把前两种悄悄归档、反复重测,迟早靠纯粹的偶然撞上一次"大幅改善",配上大标题。样本越小,偶然造成的差异越大、越好用。 ③ 论据/数字:(a) 抛硬币——作者抛 10 次得 8 次正面,"于是证明硬币 80% 朝上"(按牙膏的统计法就是如此);要抛到 1,000 次才会逼近真实概率。只有大量试验时"大数定律"才有效。(b) 脊髓灰质炎疫苗——450 个孩子接种、680 个做对照,看似大规模;但该病发病率极低,这个规模本就只该出现约 2 例,实验注定毫无意义,需要 15–25 倍的人数才说明问题。(c) 3.6 口之家——按"统计上的平均家庭 3.6 人"盖两居室,可三、四口之家只占 45%,于是两居室过剩、大小户型不足,"误导性的不完整"造成了真金白银的损失。(d) Gesell 婴儿发育norm——必有一半孩子达不到"平均"月龄坐立,于是制造了大批焦虑的父母;把"normal(常见)"误当"desirable(该如此)"会雪上加霜。 ④ 如何识破:(a) 主动找显著性——最常见以概率表达,「五个百分点的显著性水平」(95% 置信)是多数用途的及格线,1% 即"几乎确定"。(b) 找误差范围/离散度——只给平均、不给range,就像只看年平均气温去选露营地(圣尼古拉斯岛 47–87°F,沙漠 15–104°F,均值都是 61°)。
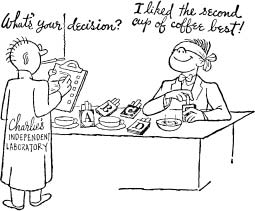
① 骗术:抓住一个数学上真实、但小到没有意义的差异大做文章。所有抽样结果都自带统计误差(probable error / standard error),忽略这个「±」,就会把噪声当信号。 ② 最精彩的案例:Peter 智商 98、Linda 智商 101。看着 Linda 更聪明、且高于平均,Peter 低于平均——「这种结论纯属胡说」。斯坦福-比奈测验的概率误差是 3%,所以应写成 98±3 和 101±3:Peter 真实智商有四分之一的概率高于 101,Linda 有四分之一的概率低于 98。换句话说,Peter 完全可能反而更高。只能用"区间"来思考智商:"正常"不是 100 这个点,而是比如 90–110 这个范围;小差异之间的比较毫无意义。 ③ 论据/数字:Old Gold 香烟的"小题大做"案例。《读者文摘》检测多个品牌香烟烟雾,结论是各品牌的尼古丁等含量"几乎完全相同、抽哪个都一样"。但有人发现:在这串几乎相同的毒物含量里,总得有一个垫底,那个恰好是 Old Gold。电报飞出,最大号字的广告登出:"本刊检测的所有香烟中,Old Gold 的有害物质最少"——所有数字和"差异可忽略"的提示统统隐去。后来 Old Gold 被勒令"停止"此类误导广告,但好处早已榨干。呼应那句老话:「差异只有在造成差异时才算差异。」 ④ 如何识破:永远把"±"记在心里,哪怕(尤其是)它没被写出来。看到杂志编辑因"40% vs 35% 阅读率"就要多约稿,要警惕:样本扣掉非读者后可能只剩一小撮,隐藏的概率误差大到让这点差距形同抓救命稻草。
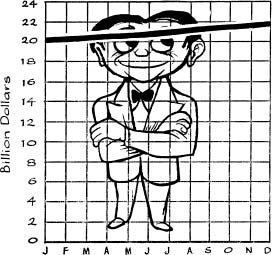
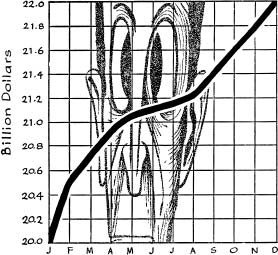
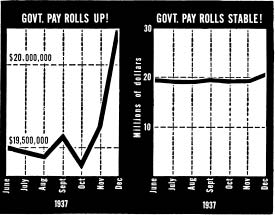
① 骗术:线图最适合表现趋势,也最容易动手脚。两步把温和趋势画成惊天动地:第一步截掉纵轴底部(truncate),第二步压缩横轴/拉伸纵轴比例。数字一个没改、曲线一模一样,改的只是"印象"——而且不用一个形容词,毫无破绽可抓。 ② 最精彩的案例:作者亲手演示——国民收入一年增长 10%。先画一张带零基线、比例正常的诚实图,10% 看着就是温和上扬。然后"把底部砍掉"(省纸还能堵悠悠之口),同一条曲线立刻爬到半张纸高,小涨变大涨。再"让纵轴每格只代表原来 1/10 的金额",10% 的涨幅顿时比 100% 还生猛——"你都能感到繁荣在国家的血管里搏动"。 ③ 论据/数字:真实案例成串——《新闻周刊》在 80 处截断、宣称"股市创 21 年新高"(1951);哥伦比亚天然气公司在《时代》登广告,十年间生活成本涨约 60%、燃气价降 4%,却把图从 90% 砍起、不留任何断口,于是"生活成本翻了三倍、燃气降了三分之一"。最经典的是 1938 年《Dun's Review》并排放的两张图:左边"政府工资飙升!(GOVERNMENT PAY ROLLS UP!)"红线从底冲到顶,右边"政府工资平稳(STABLE)"——同一组数据(约 1,950 万→2,020 万,涨不到 4%),诚实地画就是几乎水平的一条线。 ④ 如何识破:看线图先找零基线和纵轴刻度有没有断口;把曲线的陡峭程度和它代表的真实百分比对一对——往往会发现"四百米冲刺"其实只是"溜达了 4%"。
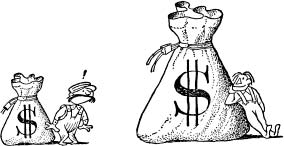
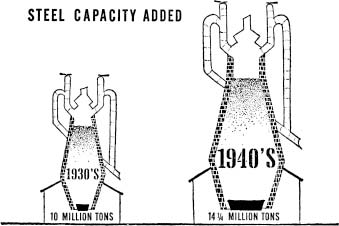
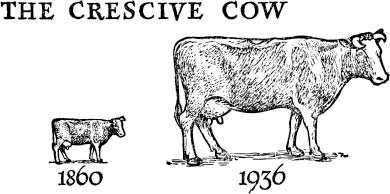
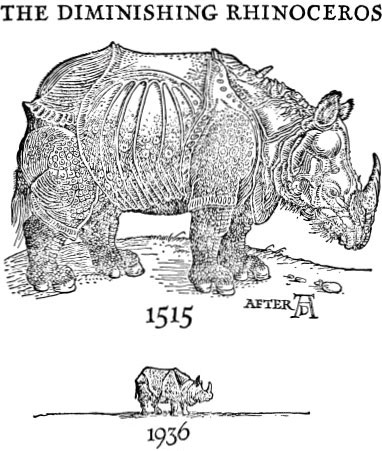
① 骗术:用图画(钱袋、钢炉、奶牛、小人)代表数量本是好用的"象形图"。但当你要表现"翻倍"时,画一个高两倍的物体——它必然同时宽两倍,占的面积是 4 倍;而它画的是有三维体积的实物,于是视觉体积是 8 倍。嘴上说"两倍",让你"看成八倍"。 ② 最精彩的案例:美国钢铁协会的两座高炉。为显示钢产能从 1930 年代到 1940 年代猛增(暗示行业自己干得好、无需政府干预):代表 30 年代新增 1,000 万吨的高炉,画成 40 年代那座(新增 1,425 万吨)高度的约三分之二;眼睛看到的却是一座比另一座大近三倍的炉子。更过分的是第二座炉子横向也胖了一圈、代表铁水的黑条变成 2.5 倍长——"50% 的增长,画成 150%,给人 1500% 以上的视觉印象,算术变成了幻想"。 ③ 论据/数字:(a) 钱袋——Rotundia 周薪 30 美元、美国 60 美元,诚实画法是两个等宽、一高一矮(或 1 个对 2 个)的袋子;不诚实画法是一个高两倍的大袋子,按体积装的就成了"30 对 240"。(b) 不断长大的奶牛(THE CRESCIVE COW)——1860 年 800 多万头、1936 年 2,500 多万头,画成一小一大两头牛,匆匆扫过的人会以为"现在的牛比过去大"。(c) 缩小的犀牛(THE DIMINISHING RHINOCEROS)——同样手法反向用,Ogden Nash 用"rhinosterous"押韵"preposterous(荒谬)",作者说这词也正好形容这种画法。 ④ 如何识破:对任何"会变宽/变厚"的象形图保持警惕——单一数量就该用单一维度(长度/高度,或并排重复的等大图标)表示;凡是宽高一起放大、或画成三维实物的,几乎都在夸大。
① 骗术:「如果你证明不了想证明的,就去证明另一件听着差不多的事,假装它们是一回事。」在数字撞击大脑后的眩晕里,几乎没人会注意到偷换。 ② 最精彩的案例:「半盎司本药水在 11 秒内杀死试管里 31,108 个细菌」——配上声名显赫的实验室、白大褂模特,用来"证明"它能治感冒。但试管里有效不等于在喉咙里有效(何况按说明稀释过),更别提没人知道感冒是不是细菌引起、那 31,108 个是什么细菌。试管杀菌数和"治感冒"之间,根本没有已知联系。 ③ 论据/数字:(a) 7am vs 7pm——"晚 7 点公路死亡人数是早 7 点的 4 倍",于是"早上开车安全 4 倍"?错,只是晚上路上的人多、可供死亡的基数大。同理可"证明"晴天比雾天危险(因为晴天多)。要比就比每百万乘客英里的死亡率。(b) "27% 的知名医生抽 Throaties,多于任何品牌"——医生比你更懂选烟吗?不懂。这数字再真也只配回一句"那又怎样"。(c) 榨汁机"多出 26% 汁液"——多出谁的 26%?查到底是比老式手动榨汁器多,与"这台是不是市面最差"毫无关系。(d) 把一堆零碎抱怨加总后说成"78% 反对工会";用折旧、准备金把利润藏起来;同一笔钱可说成"1% 的销售回报"或"365% 的投资回报"(每天 99 美分进、1 美元出)。 ④ 如何识破:盯住"数字"和"结论"之间是否同一主语。问:这个数字到底附着在什么上?它和它声称证明的事,是真有关系,还是只是听起来像?
① 骗术:古老的逻辑谬误——"B 跟在 A 后面,所以 A 导致了 B"。在一堆唬人的数字里,这个谬误被精确的相关系数伪装得格外像"科学"。相关 ≠ 因果。 ② 最精彩的案例:抽烟的大学生成绩更差(研究本身做得规范:样本够大、相关显著)。于是"戒烟能提分、抽烟使人变笨"。但完全可能是反过来——成绩差驱使学生抽烟;更可能是第三因素同时导致两者——比如爱社交、不把书当回事的外向者既抽烟多、成绩又差(已有研究显示外向与低分的相关比智力与成绩的相关还强)。"当有许多合理解释时,你无权只挑顺眼的那个咬定不放。" ③ 论据/数字:(a) 大学教育的金钱价值——上过大学的人确实挣得多,但这不证明"是因为上了大学";大学不成比例地招收了"聪明的"和"有钱的"两类孩子,他们不上大学可能照样挣得多。(b) 女大学生更难嫁(康奈尔研究:中年男毕业生 93% 已婚高于general人口 83%,女毕业生仅 65%、老姑娘是普通女性的三倍)——但可能是"易独身的倾向导致去上大学",而非反过来;Kinsey 发现性向与教育的相关、且性向在上大学前就已定型。给 Susie Brown 的注脚:"未必如此(It ain't necessarily so)"。(c) 荒诞相关——马萨诸塞州长老会牧师薪水与哈瓦那朗姆酒价格高度相关(其实都被"物价普涨"这第三因素推高);新赫布里底人相信"虱子使人健康"(其实是人一发烧、体温升高,虱子才离开)。(d) 越多雨玉米越高只在一定范围成立,超过某个雨量,多雨反而减产——相关被外推到数据范围之外就会翻车。 ④ 如何识破:见到有人(通常是利益相关方)拿相关大做文章,先看它是不是"时代趋势"造的假相关(在校学生数、精神病院人数、香烟消费、心脏病、假牙产量……在那个年代两两正相关,但互为因果"显然可笑")。判定因果,要么能排除第三因素,要么对同一群体做纵向跟踪(如 Walker 教授的"老年女性走路更外八"——其实是她们年轻时被教导外八,是时代而非年龄所致)。
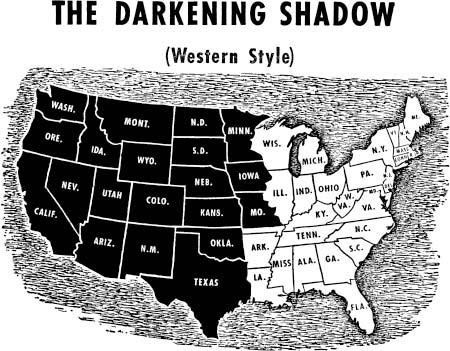
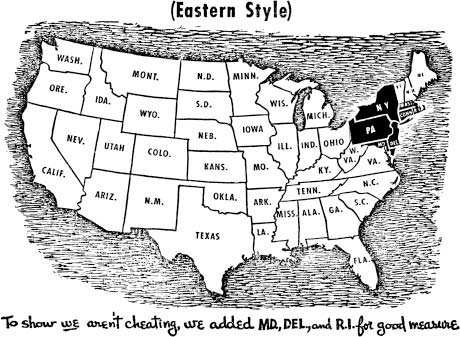
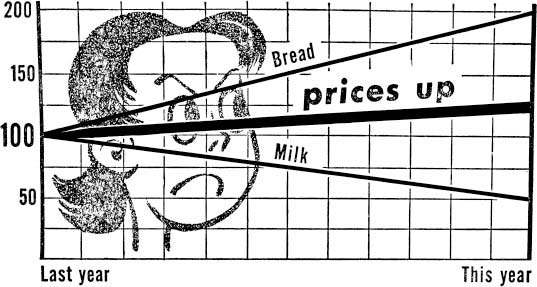
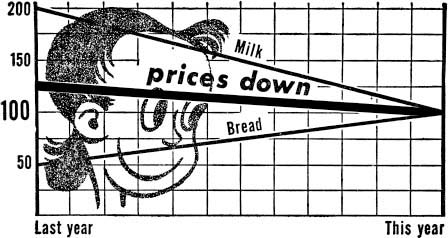
① 骗术:作者自造词 statisticulation(statistic + manipulation,统计操纵)——用统计材料误导人。不一定全是蓄意,也可能是无能;但作者犀利地指出:错误几乎总是单方向的(夸大对己有利的、极少缩小),所以很难纯粹归咎于"无心之失"。"什么时候见过工会雇了个无能到把劳方说得比实际更弱的统计员?" ② 最精彩的案例:「渐暗的阴影」地图(The Darkening Shadow)(波士顿第一国民银行发布、被《新闻周刊》等广泛转载)。它把密西西比河以西各州(面积大、人口稀、收入低)整片涂黑,以显示联邦开支已"吞掉"这些州的全部收入。骗术在于专挑面积大收入小的州;同样"诚实/不诚实"地从纽约或新英格兰涂起,就只剩一小块阴影——只是没人有动力去发那张。这地图还是个"老套路":同一银行早年的版本早被 Brinton 的《Graphic Presentation》当作反面教材,斥其"扭曲事实",可银行照画不误。 ③ 论据/数字(本章是杂耍大全):
① 由攻转守:前九章像在教海盗使弯刀,本章正面给出"如何盯着一个假数字、把它瞪回去"的方法,同时强调——要在"满是欺诈的旷野"里认出可用的好数据,而不是因噎废食、一概排斥统计。作者给出五个反问:
| 术语(原文) | 含义 | 它怎么骗人 / 关键要点 |
|---|---|---|
| 均值 mean | 全部数值相加再除以个数(算术平均) | 在右偏分布(如收入)里被极端高值拉高;不指明种类时,"平均"常默认指它,因为最大 |
| 中位数 median | 正中间那个数,一半在上一半在下 | 通常比均值更能反映"典型水平";普查局报收入用的就是它 |
| 众数 mode | 出现频率最高的那个数 | 工资分布里往往是最低档,老板不爱提;与 mean 可差出几倍 |
| 正态分布 / 钟形曲线 normal distribution | 对称的钟形分布 | 此时 mean、median、mode 三者重合,"平均"不必细究;收入等右偏数据则三者分离 |
| 概率误差 probable error | 测量值有一半概率落入的 ± 区间(旧式,斯坦福-比奈仍用) | 智商 98 实为 98±3;忽略这个 ± 就会把噪声当真差异 |
| 标准误差 standard error | 约覆盖三分之二情形的误差度量(现代统计更常用) | 与概率误差同类、数学上更好用;缺失它的相关数据"不该当真" |
| 显著性 significance | 一个结果"是真效应而非偶然"的可能性,常以概率表达 | 5%(95% 置信)是多数用途及格线,1% 即"几乎确定";被藏起来的"那个不在场的小数字" |
| 大数定律 law of averages | 只有在大量试验下,频率才逼近真实概率 | 抛 10 次得 8 次正面证明不了什么;小样本里偶然差异被当成发现 |
| 哇哦图 gee-whiz graph | 截断纵轴、压缩横轴以夸大趋势的线图 | 数字不变、曲线不变,只改"视觉印象",且无形容词可抓 |
| 一维图 one-dimensional picture | 用面积/体积(二维、三维物体)表现一维数量 | 高两倍 → 面积 4 倍 → 体积 8 倍;说"两倍"看成"八倍" |
| 半相关数字 semiattached figure | 证明不了 A,就拿一个貌似相关的 B 冒充 | "试管杀菌 31,108 个"冒充"能治感冒";唯一回应是"那又怎样" |
| 事后归因 post hoc | post hoc ergo propter hoc——B 跟在 A 后,便断定 A 导致 B | 相关≠因果;可能反向、可能第三因素、可能纯属偶然 |
| 虚假相关 spurious correlation | 两变量真有统计相关,却互不为因果 | 牧师薪水 vs 朗姆酒价(都被物价普涨推高);多由"时代趋势"造成 |
| 统计操纵 statisticulate | 作者自造:statistic + manipulate,用统计材料误导 | 不一定蓄意,但"错误几乎总是单方向的",故难称无心 |
| 基期 base / index number | 指数的参照时点 | 换基期可让同一组物价"涨 25%/跌 25%/没变" |
| 百分比 vs 百分点 percentage vs percentage points | 相对变化 vs 绝对刻度差 | 3%→6%:可说"涨 3 个百分点"(温和)或"涨 100%"(吓人) |
| 百分位 percentile | 在每百人中的排名 | 99 分位常远强于 90 分位,而 40 与 60 分位可能几乎相当(数据向均值聚集) |
| 外推 extrapolation | 把趋势延伸到数据之外去预测 | 隐含"其他条件不变",而它从不肯不变;电视机/密西西比河式荒谬 |
| OK 名号 O.K. name | 医学、实验室、名校等自带权威感的招牌 | 数据来自名校,结论却是作者私塞的——要确认权威"在背后"而非"在旁边" |
1. 谁说的?(Who Says So?)
2. 他怎么知道的?(How Does He Know?)
3. 漏掉了什么?(What's Missing?)
4. 是不是偷换了主题?(Did Somebody Change the Subject?)
5. 这数字讲得通吗?(Does It Make Sense?)
这本书的局限:
为什么它至今仍是经典: 它把"对数字的怀疑"从一种模糊的直觉,提炼成了一套有名有姓、可逐条检查的清单。70 年里数据呈现的载体从报纸图表换成了 dashboard 和 AI 生成的图,但人脑被"精确小数点 + 一条上扬曲线 + 一个权威名号"催眠的弱点丝毫未变——这本书针对的是人性,不是技术,所以不过时。
「世上有三种谎言:谎言、该死的谎言,和统计数字。」——Disraeli(本书题记)
「有朝一日,统计思维之于高效公民,将如读写能力一样必不可少。」——H. G. Wells(本书题记)
「让我们惹上麻烦的,往往不是我们不知道的事,而是我们自以为知道、其实不然的事。」——Artemus Ward(本书题记)
「包装精良的统计,比希特勒的'弥天大谎'更高明:它一样误导你,却钉不到说话人头上。」(引言)
「骗子早就会这些招;老实人必须学来自卫。」(引言)
「读到'67% 的美国人反对……'时,别忘了追问那句挥之不去的话:是哪 67% 的美国人?」(第 1 章)
「这就是用统计撒谎的妙处——两次你都抓不到他撒谎。」(第 2 章)
「几乎每个人都低于平均。」(第 2 章,论右偏分布里的均值)
「一个差异,只有在它造成差异时,才算一个差异。」(第 4 章)
「说'两倍',却留下'八倍'的印象——这就是一维图能干的事。」(第 6 章)
「如果你证明不了想证明的,就去证明别的、再假装它们是一回事。」(第 7 章)
「当有许多合理解释时,你无权只挑顺眼的那个咬定不放。」(第 8 章)
「统计与其说是一门科学,不如说是一门艺术。」(第 9 章)
「武断地拒绝统计方法毫无意义——那就像因为有人用文字掩盖事实,就干脆拒绝阅读。」(第 10 章)
「科学真是迷人:用一丁点事实的投入,就能批发出整车的猜想。」——Mark Twain,本书第 10 章引(论外推之荒谬)